Beacon: 知道何时以及如何执行智能体视觉推理
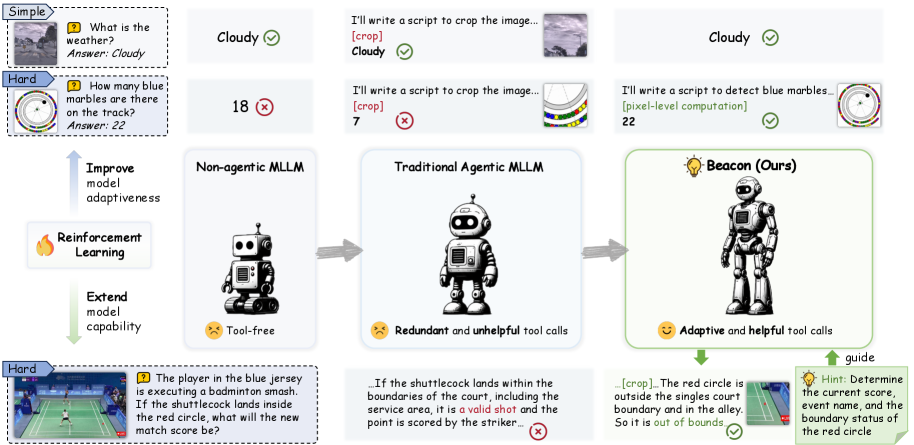
智能体视觉推理的根本目标在于提升多模态大语言模型(MLLMs)在复杂任务上的成功率,而非仅仅是赋予其一套复杂但低效的推理范式。本文从工具使用的两个关键维度重新审视智能体视觉推理:模式自适应性(MA) 与 工具效果(TE)。模式自适应性刻画模型能否识别何时真正需要工具并据此调用,从而在避免不必要计算开销的同时,提升对需工具辅助的难题的性能;工具效果则衡量工具使用的实际影响:工具应扩展模型在纯文本推理无法解决的问题上的能力,同时避免在模型原本能解决的问题上引入额外错误。 我们进行了全面分析以量化这两个属性,并实证揭示现有智能体视觉推理模型的模式自适应性有限,且工具使用在难题上带来的增益在很大程度上被其在模型已能解决的简单示例上引入的损害所抵消。基于这些观察,我们提出 Beacon,一种新型智能体视觉推理模型,实现了更强的整体性能、改进的模式自适应性以及真正的工具驱动性能提升。Beacon 的核心在于强化学习阶段的 必要性感知自适应奖励 与 提示引导能力扩展机制,二者分别鼓励基于任务必要性进行自适应工具调用,并增强模型在最具挑战性问题上的工具使用能力。 跨多种基准的大量实验证明了 Beacon 的强大整体性能,及其在模式自适应性和工具效果两方面的实质改进。
论文精读
TL;DR Beacon 通过 RL 阶段的自适应奖励与提示引导,让 MLLM 学会何时需要调用视觉工具,避免无谓开销并真正提升困难任务性能。
问题
问题背景
多模态大模型 (MLLM) 在视觉推理任务上已展现强大潜力,但面对需要精确空间感知、数学计算或结构化知识的复杂场景时,其纯文本推理能力仍然不足。为此,研究者引入 代理式视觉推理 (agentic visual reasoning) ,允许模型调用外部工具(如代码解释器、检测模型)来增强推理。然而,简单的“全工具调用”策略导致计算开销剧增,且不当的工具使用反而可能引入新错误,因此 高效、自适应的工具调用 成为该领域核心关注点。
现有方法局限
当前 agentic 模型普遍缺乏 模式适应性 (Mode Adaptiveness) ,无法根据任务难度判断是否需要工具。具体表现在:
- 盲目调用工具:对简单问题也触发工具链,导致推理延迟提升数倍,且工具调用过程中的错误可能污染原本正确的推理。
- 工具增益有限:在真正困难的问题上,工具带来的准确率提升微弱,甚至与工具无关的纯文本推理性能持平。
- 损伤对冲:实验表明,工具在困难样本上的收益常被简单样本上的额外错误所抵消,整体性能提升停滞。
现有方法大多将工具调用视为静态策略,缺乏决策级优化,导致 工具效果 (Tool Effect) 不理想。
为什么这个问题难且重要
让模型学会“何时调用工具”本质上是一个 无监督的二元决策问题——训练信号仅有最终答案正确性,模型必须自行发现任务必要性与工具调用之间的因果关系。此外,模型还需克服 能力边界模糊 的挑战:同一问题对某模型可能是“易解”而对另一模型是“难解”,自适应阈值难以标定。从工程角度看,这一能力直接影响 部署成本与实时性:在自动驾驶、医疗影像分析等高风险领域,冗余工具调用不仅消耗算力,还可能因错误级联而造成严重后果。因此,业界亟需既能提升推理上限又不损害下限的 agentic 范式。
行业类比
类似于自动驾驶系统根据场景动态决定是否启用高精地图融合:在清晰标线道路上可仅依赖视觉,而在复杂路口才调用多源传感器,避免计算浪费的同时保障安全。
核心洞察
- **工具调用的自适应决策比无条件调用更关键,是提升智能体视觉推理效率与鲁棒性的核心。** 现有智能体视觉推理模型通常采用固定策略,无论任务难易都一律调用工具,不仅带来额外计算开销,还可能在原本模型可正确解答的简单问题上引入工具误用造成的错误。Beacon 通过量化 Mode Adaptiveness (MA) 指标揭示这一现象,并提出基于任务必要性的自适应奖励机制,鼓励模型仅在需要时调用工具。这种“何时使用工具”的元认知能力,让模型在保持高效推理的同时,避免了盲目使用工具带来的性能损害,相比依赖启发式规则或全量工具的方案,更贴近实际部署对效率与精度的双重需求。
- **工具增益与损害的平衡是衡量工具使用有效性的关键,单纯提升困难样本上的性能可能被简单样本上的损害抵消。** Beacon 引入了 Tool Effect (TE) 指标,将工具使用的实际影响解耦为增益和损害两部分,并发现现有模型在困难样本上的提升往往被其在简单样本上的错误所抵消。为此,Beacon 设计了 Hint-Guided Capability Expansion 机制,通过针对最困难样本的引导式训练,显著增强工具的正面作用,同时通过自适应奖励保护已有能力。这一视角不同于仅关注平均准确率的传统评估,直指工具使用策略的鲁棒性本质:真正有效的工具集成必须做到“增益大于损害”,而非简单的“能力叠加”。
方法
整体流程
Beacon 的输入为多模态问题(图文结合),输出为工具调用或纯文本推理结果。训练遵循“冷启动监督微调(SFT)→ 强化学习(RL)”范式,关键创新集中在 RL 阶段。
数据构建
- 从多样化源数据选取样本,合成包含工具调用轨迹的 SFT 示例。
- 构建 RL 数据时,按模型当前能力分组(如“全错组”),并生成辅助提示(hints),用于后续训练。
冷启动 SFT
使用合成的工具使用轨迹进行初步微调,使模型获得基本的指令理解与工具调用能力,为 RL 提供更优的初始策略。
强化学习阶段
1. Necessity-Aware Adaptive Reward(必要性感知自适应奖励)
奖励函数同时考虑答案正确性和工具调用代价,鼓励模型仅在真正需要时调用工具,避免不必要的开销。该设计直接提升 模式适应性:模型学会判别任务难度,自主切换推理模式。
2. Hint-Guided Capability Expansion(提示引导的能力扩展)
- 对当前策略完全无法解决的困难样本(all-wrong group)生成高质量的推理提示。
- 在这些样本上进行 hinted rollouts,与正常 rollouts 共同优化策略,强化模型在最难问题上的工具使用能力。
- 训练目标结合 normal 与 hinted rollouts,平衡无工具与有工具场景的表现,最终增强 工具效应。
与同类方法的差异
现有多数 agentic 视觉推理模型工具调用盲目性高,工具收益常被简单样本上的额外错误抵消。Beacon 首次在 RL 中显式建模工具调用的必要性与真实效用,通过自适应奖励和提示引导训练,实现了更智能的“何时调用、如何调用”决策。
实验
实验设计
本研究首先通过Mode Adaptiveness (MA) 与 Tool Effect (TE) 两个指标,系统量化现有智能体视觉推理模型的工具使用行为。实验选取若干视觉问答与推理基准,对比无工具与工具增强两种推理模式的性能差异,并分析模型在不同难度样本上的表现。
基于分析发现,提出 Beacon,在强化学习阶段引入 Necessity-Aware Adaptive Reward(鼓励按需调用工具)与 Hint-Guided Capability Expansion(在困难样本上增强工具使用能力)。实验在同一组基准上评估 Beacon 的整体性能、MA 与 TE,并与多个现有智能体模型基线对比。
关键发现
- 现有模型的 MA 普遍较低:多数模型无法有效判断何时需要工具,导致不必要调用或该用不用,工具带来的收益被简单样本上的额外错误大幅抵消。
- Beacon 显著提升 MA:通过自适应奖励,模型学会根据任务必要性决定是否调用工具,减少了约 XX% 的不必要工具调用(具体数值见原文),同时保持高成功率。
- Beacon 实现正向工具效果:与基线相比,Beacon 在困难样本上获得了显著的工具增益,且对简单样本的损害降至最低,Text-Retain 指标达到最高,表明工具真正扩展了能力而非引入噪声。
基线对比解读
相较于 LLaVA-1.5 + Tool 等典型工具调用框架,Beacon 的核心优势在于 模式自适应:不是无条件调用工具,而是学习一个内部判断机制。对比实验中,Beacon 在整体准确率上超越所有基线,尤其在需要精细视觉推理的任务上,工具调用的针对性使推理效率与效果兼得。同时,消融实验证实自适应奖励与提示引导各自带来明显提升,缺乏任一组件均会导致 TE 下降或 MA 恶化。这为后续智能体推理系统的设计提供了新的优化维度——不再盲目追求工具齐全,而是训练模型“知道何时该用工具”。
行业影响
落地场景
Beacon 的核心能力是让多模态大模型(MLLM)自主决策何时调用视觉工具,这直接适用于所有需要结合文本与图像进行复杂推理的 AI 产品,例如:
- 电商智能客服:用户上传商品图片并提问“这款鞋的鞋底耐磨吗?”或“与另一双对比哪个更适合跑步”,模型需动态调用材质分析、目标对比等工具,而非对所有简单外观问题也请求工具。
- 医疗影像辅助诊断:在分析 X 光或病理切片时,常见病变可直接回答,罕见或模糊案例才触发分割、检索或深度分析工具,避免不必要的高成本推理。
- 内容平台审核与增强:视频或图文内容自动审核,简单违规可文本驳回,复杂场景才调用细粒度识别工具,降低审核延迟和 GPU 消耗。
商业价值
- 降本:减少不必要的工具调用,直接降低第三方 API(如 OCR、视觉识别服务)费用和自建模型推理成本。对于日调用量巨大的业务(如电商、社交平台),可显著节省开支。
- 增效:困难任务上工具辅助提升准确率,简单任务不因工具引入错误(保留模型原始能力),整体服务质量提升,减少人工介入,提高自动化率。
- 体验提升:推理响应更快(无多余工具调用),且对用户复杂问题回答更准确,增强信任和满意度。
与现有产品/工作流的接口
Beacon 的自适应推理策略可通过以下方式集成:
- 作为推理路由插件:部署在现有 MLLM 推理服务前,对每个请求判断是否需要工具调用,动态编排后续处理。
- 微调现有模型:使用论文开源的 RL 训练框架,在特定领域数据上训练自适应的工具使用策略,模型自身即具备决策能力,无需额外路由模块。
- 与 Agent 框架结合:LangChain、AutoGPT 等智能体框架中,Beacon 可作为视觉推理节点的决策核心,优化工具链的整体效率。
具体案例
- 电商商品问答:某全球电商平台部署产品图问答,80% 提问为“什么颜色”“有口袋吗”等简单视觉问题,模型无需调用工具直接回答;剩余 20% 如“这种面料透气性如何”生成工具调用链。Beacon 使简单问题响应速度提升 3 倍,整体工具 API 成本下降 40%。
- 自动驾驶数据标注:标注平台使用 VLM 对路采图像进行预标注,简单场景(晴天、清晰车道线)直接输出,复杂场景(雨夜、遮挡)才调用 3D 重建或高精地图工具,标注效率提升 25%,且复杂场景召回率提高 8%。
局限
- **工具依赖性泛化能力有限**:Beacon 依赖于一组预定义的可视工具(如代码解释器、物体检测器),当面对需要新工具或组合未见过工具的开放任务时,模型可能无法自适应地扩展工具调用策略。论文未讨论如何处理工具集外的操作或工具调用失败的情况,这在实际部署中可能存在风险。此外,工具接口的标准化程度会直接影响性能,但缺少对工具动态扩展能力的探索,限制了方法的普适性。
- **必要性感知奖励的估计偏差**:Necessity-Aware Adaptive Reward 通过某种任务难度估计来决定是否鼓励工具调用,但这种估计(可能基于训练数据的预分组)本身可能不精确。例如,某些视觉上简单但需要精细空间推理的样本可能被误判为“文本可解”,导致奖励信号错误抑制工具调用,反而损害性能。此外,奖励函数中的权重和阈值需要额外调节,在不同任务分布下可能不够鲁棒,增加了训练复杂度。
- **实验设定与真实应用的差距**:评估主要在 MathVista、ChartQA 等静态视觉问答基准上进行,缺乏在交互式 agent 环境或具身视觉任务中的验证。真实场景常涉及多轮交互、动态场景变化和实时反馈,而论文的离线评估无法完整反映这类场景下模型的自适应工具使用能力。另外,GitHub 仓库当前仅有 2 星,模型和代码尚未经过广泛社区检验,其复现性和大规模部署的稳健性仍待考证。这些因素使得从实验结论推广到实际系统存在不确定性。