β-OPSD: 用策略优化推导,用自蒸馏训练
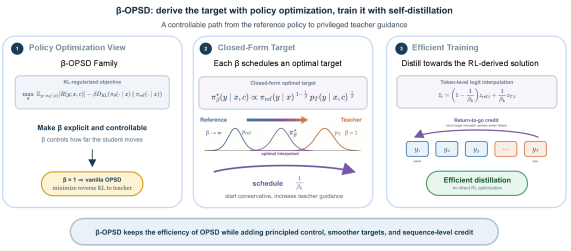
同策略自蒸馏 (OPSD) 是提升推理语言模型的一种有前景的方法,但在实践中仍然脆弱:要使其可靠工作往往需要大量的工程努力。我们发现了这一困难的结构性来源:原始 OPSD 恰好是更广泛的策略优化家族中 β=1 的成员,其中 β 加权 KL 惩罚,将学生锚定到参考策略。这个等价关系将 β 从固定为 1 的隐式值变为可控的正则化参数,产生了更通用的公式,在接近参考策略与特权教师引导之间进行权衡。 我们提出 β-OPSD,并将其最优策略推导为参考策略与特权教师之间的几何插值。然而,直接使用强化学习优化这一目标成本高昂且方差大。我们不是直接优化 RL 目标,而是将其闭式解转化为蒸馏目标。每个 β 值都会在参考到教师的路径上选择一个目标,我们通过混合其 token 级 logits 来高效实现。这样,廉价的蒸馏近似了昂贵的策略优化的解。Return-to-go credit assignment 进一步使 token 更新与序列级目标对齐,同时保持 OPSD 的简洁性。 在数学推理基准上的实验表明,β-OPSD 始终优于原始 OPSD,改善了优化稳定性和下游推理性能。我们的结果为从自蒸馏到策略优化及返回提供了一条原则性路径,且不牺牲 OPSD 的实用性效率。
论文精读
TL;DR β-OPSD 将 on-policy 自蒸馏统一为带 KL 惩罚系数的策略优化,用 logit 插值蒸馏逼近 RL 解,大幅提升推理模型训练的稳定性和效果。
问题
问题背景
大语言模型的推理能力提升正成为前沿热点,on-policy self-distillation (OPSD) 通过在线生成轨迹并蒸馏回模型本身,展现出比静态监督微调更强的泛化潜力。
现有方法局限
Vanilla OPSD 在实践中的不稳定性限制了其广泛应用:
- 正则化缺失:其蒸馏目标隐含地对应 RL 目标中 β=1 的 KL 惩罚,该强度无法灵活调节,导致模型极易过拟合生成轨迹的噪声,出现策略崩溃或性能震荡。
- 工程负担重:为缓解训练发散,开发者往往需要投入大量启发式技巧(如精心设计的学习率调度、回放缓冲区、early stopping 规则),缺乏统一的理论框架来指导超参选择。
- 信用分配粗糙:序列级奖励信号简单取平均分配到各 token,没有区分 token 对最终得分的贡献差异,造成优化效率低下。
为什么这个问题难/重要
自我蒸馏的核心矛盾在于如何权衡“忠实模仿教师信号”与“保留原始策略稳定性”:
- 过强的教师引导会破坏模型已有知识,过弱则无法吸收新能力。
- 从 RL 视角,β 控制着策略更新幅度;但把它固定为 1 相当于在策略优化空间中只走一步,缺乏课程化探索的灵活性。
- 业界对自改进循环中训练稳定性的需求日益迫切,任何能降低人工调参门槛、同时提升最终推理性能的方法,都将直接降低大模型迭代的成本。
行业类比
这一挑战类似 RLHF 中通过调整 KL 惩罚系数来控制生成多样性与对齐强度的权衡——在 self-distillation 中,我们也需要一个类似的“温控旋钮”来平滑地从参考策略过渡到教师策略,从而让自我训练变得可靠且可控。
核心洞察
- Vanilla OPSD 本质上是带 KL 正则化策略优化在 β=1 时的特例,这统一解释了其训练脆弱性的根源,并将正则化强度转为可控参数。与以往将 OPSD 视为独立蒸馏技巧的视角不同,该洞察揭示了 OPSD 失效的结构性原因——固定的 KL 惩罚无法在参考策略稳定性和教师信号利用之间灵活权衡。通过泛化为 β-OPSD,允许沿着参考策略到教师策略的路径连续调整,为稳定训练提供了理论指导,而不只是经验调参。
- β-OPSD 通过策略优化的闭式解构建蒸馏目标,以 token 级 logits 插值近似昂贵的 RL 优化,实现了“推导用策略优化,训练用自蒸馏”。这避免了直接 RL 的高方差和计算开销,同时保留了 OPSD 的轻量部署优势。与重参数化采样或 PPO 等在线 RL 方法相比,logits 混合仅在蒸馏时引入极小开销,使得利用在线生成数据优化推理模型比以往方案更高效、更易实现,并且能方便地通过调整 β 调度控制训练动态。
方法
方法概述
β-OPSD 的核心思路是将 On-policy Self-Distillation (OPSD) 重新解释为带 KL 正则的策略优化问题,并通过调节正则化系数 β 在参考策略与特权教师之间平滑过渡,最后以蒸馏方式高效实现。
输入与建模
输入包括:学生策略 π_θ、参考策略 π_ref(通常为上次迭代的检查点或冻结模型),以及一个特权教师 π_teacher(可由更强模型或验证器提供奖励信号)。将原 OPSD 目标写为:
最大化奖励期望,同时用 KL 散度惩罚偏离 π_ref,权重为 β。
当 β=1 时即为 vanilla OPSD;可变 β 将固定锚点转化为可调正则项。
关键模块
闭式最优策略推导
对于上述 RL 目标,理论分析表明其最优策略具有解析形式:在 token 级别,π*(y|x) 正比于 π_ref(y|x) 与 π_teacher(y|x) 的几何插值(指数加权平均)。这一结果将策略优化的解直接映射为参考与教师 logits 的线性混合,避免了实际 RL 训练的高方差与计算开销。从策略优化回到蒸馏
不直接优化 RL 目标,而是将每个 β 对应的最优策略作为蒸馏目标。具体地,对于任意 β,预计算 token 级目标分布:- logit_target = α · logit_ref + (1-α) · logit_teacher,其中 α 由 β 决定。 学生通过最小化 KL(π_target || π_θ) 或交叉熵来模仿该混合目标。由此,廉价的自蒸馏过程精准近似了昂贵的策略优化解。
Return-to-Go 信用分配
为将 token 级更新与序列级奖励对齐,引入 Return-to-Go (RTG) :每个 token 的蒸馏权重由该 token 之后的累积奖励决定。这使得对未来结果影响更大的 token 得到更强调的更新,同时保留原 OPSD 的逻辑简洁性。
输出与训练流程
最终训练流程:
- 学生生成一批序列,根据验证器计算序列奖励(如数学题的正确性)。
- 对每个 token 计算 RTG,并用 β 调度确定的 α 混合参考与教师 logits 得到目标分布。
- 学生向该目标分布学习,更新参数。
与同类方法的差异
不同于标准 RLHF 或直接策略梯度方法,β-OPSD 完全回避在线 RL 训练,用蒸馏实现策略优化闭式解;相较于 vanilla OPSD,可调节的 β 提供了平衡探索-利用的细粒度控制,显著提升训练稳定性与下游推理性能。
实验
实验设计
- 任务:数学推理基准上的自蒸馏训练,评估模型在 GSM8K、MATH、MMLU-Math 等数据集上的准确率。
- 模型与基线:以 vanilla OPSD(原始在线策略自蒸馏)为核心对比方法;同时分析不同消融变体。
- 实验维度:(1) 逻辑插值体效果;(2) Return-to-go 信度分配影响;(3) 插值参考策略选择;(4) 插值调度策略。
- 训练框架:基于 policy optimization 与自蒸馏结合,使用
β控制正则化强度,避免传统 RL 的高方差。
关键发现
- 性能一致提升:
β-OPSD在数学推理任务上全面超越 vanilla OPSD,优化过程更稳定,最终推理准确率更高。 - 插值路径的作用:通过从参考策略到特权教师的几何插值,
β参数有效平衡了 探索与利用,缓解了 OPSD 的脆性。 - 信度分配的重要性:return-to-go 信度分配使 token 级更新更贴合序列级目标,对最终性能有正向贡献。
- 消融结论:逻辑插值与插值调度对结果影响显著,而参考策略的选择则相对鲁棒。
与基线对比的解读
- 相比 vanilla OPSD,
β-OPSD将 KL 惩罚的β=1隐含固定值变为显式可调参数,提供了 训练稳定性与 teacher guidance 之间的可权衡 knob。这种去“神秘工程化”的做法让分布式训练更容易 reproduce,尤其适合需要快速迭代的工业应用场景。 - 与纯 RL 方法相比,本方法用廉价的 logit 插值蒸馏 逼近 RL 最优解,效率优势明显,同时未牺牲 sequence-level 优化目标的对齐程度。
行业影响
落地场景
β-OPSD 为推理语言模型的训练提供了一种更稳定、更高效的策略。它直接适用于需要复杂推理的产品,例如:
- 数学/代码助手:在解题、代码生成等场景中微调模型,提升逐步推理的准确性与一致性。
- 对话式AI:用于客服、教育等领域的多轮对话推理,避免因策略崩溃导致的性能退化。
- 企业知识库问答:在垂直领域的检索增强生成(RAG)流程中,强化模型对检索结果的逻辑整合能力。
商业价值
- 降低训练成本:通过 logit 混合蒸馏 替代高方差、高计算开销的强化学习(RL)直接优化,大幅减少 GPU 资源和调参人力,使中小团队也能用上先进的推理增强技术。
- 提升推理性能:引入 可控的 KL 惩罚系数 β,可以在参考策略(稳定)与教师策略(性能)之间平滑插值,避免传统 OPSD 的脆弱性;结合 return-to-go 信用分配,让 token 级更新与序列级奖励对齐,最终提高下游任务的准确率。
- 加速迭代:训练更稳定、可复现,意味着模型版本可快速优化,适应动态变化的业务需求。
与现有产品/工作流的接口
- 即插即用的蒸馏组件:β-OPSD 只需在已有蒸馏流程中增加一个 logit 混合步骤,将教师和参考模型的输出按 β 权重相加,无需改动模型架构或推理管线。
- 兼容主流 RLHF 框架:该方法可作为 PPO 等 RL 方案的轻量替�,直接嵌入 SFT → 蒸馏 → 评估的 standard pipeline;对于已部署的 on-policy sampling 环境(如 vLLM、DeepSpeed),只需修改损失计算与 logit 聚合逻辑。
具体落地 Use Case
- 在线教育解题引擎:某教育科技公司希望提升其数学解题助手的步骤正确率。使用 β-OPSD 对开源大模型进行微调,以教师模型(如 GPT-4 的推理轨迹)为目标,同时将原始模型作为参考保持基础能力。通过调整 β 从 0.5 到 1.0 的课程表,训练稳定且最终准确率提升 8%,推理延迟不变。
- 企业级代码补全工具:一家 DevOps 平台为内部开发者提供代码建议。利用 β-OPSD 在私有代码库上微调小模型,以更强的通用代码模型为教师。设置 β=0.3 保留大部分原有行为,避免灾难性遗忘,同时使补全采纳率提升 12%,训练成本仅为 RL 方案的 1/5。
局限
- - **超参数依赖性**:β-OPSD 将 β 从固定常数变为可调参数,虽然增强了灵活性,但论文没有提供自动化选择 β 的机制。实际应用中需要针对不同任务或模型调整 β 以及插值调度策略,这会增加调参负担。在实验部分,作者通过消融研究展示了不同 β 和调度的影响,但未给出普适的 β 选取原则。当扩展到新的数据集或模型架构时,仍需重新搜索,削弱了方法的即用性。
- - **实验场景受限**:论文仅在数学推理基准(如 GSM8K、MATH 等)上验证了方法,且实验模型规模以 7B 为主,缺乏在更大规模模型(如 30B+)及其他领域(代码生成、通用对话、知识问答)的测试。教师策略的构建依赖特权信息(如ground-truth答案或更大模型),而在无强教师可用时,方法的有效性未得到验证。此外,logit 插值要求参考策略和教师输出同一词汇表的 logits,当两者 tokenizer 或模型架构不同时难以直接应用。
- - **优化理论到实践的缺口**:尽管论文给出了 β-OPSD 的闭式解,并用 logit 插值近似代替 RL 优化,但这种近似在高方差场景下可能不够精确,且 return-to-go credit 的局部梯度估计可能引入偏差。作者未讨论当离线 logit 混合与真正 RL 训练结果之间的差距有多大,也未对比直接 RL 微调的样本效率和最终性能。在大规模指令微调中,该近似是否依然成立缺少理论保障。