VAD: 在多模态在线策略蒸馏中归因视觉证据以进行目标重建
多模态在线策略蒸馏(OPD)通过特权视角教师监督学生生成的轨迹,迁移细粒度视觉知识。然而,其逐词修正为源混合的,混合了视觉信号、语言先验与教师特定效应。核心挑战在于判断哪些修正由视觉证据支持,而非仅仅关注蒸馏位置或强度。 我们提出视觉归因蒸馏(VAD),一种反事实目标重建算法。在每一学生生成前缀处,VAD 在相关证据存在/移除两种情况下评估同一固定教师,通过中心化对数概率的变化定义 ut,作为视觉证据方向的带符号代理。VAD 将原始修正投影至该代理,得到干预对齐分量与残余项,并基于前者重建学生锚定目标。训练中,该重建目标提供主要监督,特权教师仅作弱正则化。 在 4B 与 9B 规模的六个细粒度视觉基准上,VAD 优于直接特权蒸馏与视觉优势加权。词元级及受控目标分析显示,代理对齐分量富含任务相关视觉修正,并产生更强目标偏移,尤其在证据反驳错误答案时。该结果支持反事实目标重建作为源混合监督的有效替代方案。
论文精读
TL;DR VAD 通过反事实视觉归因从源混合教师信号中分离出纯视觉证据,重构蒸馏目标,在细粒度多模态任务上显著优于直接特权蒸馏和视觉优势加权。
问题
问题背景
多模态大模型在细粒度视觉理解(如文档解析、图表问答)中,通常借助特权视图教师进行On-Policy 蒸馏 (OPD) 传递精细视觉知识。当前核心诉求是:如何从教师校正信号中提取视觉证据支撑的部分,避免学生学到语言偏好或教师特有偏差。
现有方法局限
传统 OPD 方法直接使用教师对下一 token 的校正作为监督目标,但该校正信号是 源混合的 (source-mixed),混杂了以下成分:
- 视觉证据:来自教师看到的丰富视觉输入;
- 语言先验:教师模型固有的语言建模倾向;
- 教师特定效应:如训练数据偏差、模型风格等。
简单加权或选择位置(如视觉优势加权)无法解耦这些成分,导致学生可能:
- 学习到非视觉的捷径,而非真正依赖视觉理解;
- 过拟合教师的模式,在分布外场景泛化能力下降。
缺乏对视觉证据归因的机制,蒸馏信号信噪比低,限制了模型在细粒度视觉任务上的提升潜力。
技术挑战与重要性
多模态模型中视觉和语言信号高度耦合,估计“哪些校正由视觉证据支持”本质上是一个反事实推理问题:需要对比教师在有/无相关视觉证据下的行为差异。技术难点包括:
- 不能重新训练教师,需在固定教师下在线量化单个 token 校正的视觉归因程度;
- 必须在 On-Policy 训练循环中高效实现,避免额外计算开销;
- 归因结果要能重构出对学生的有效监督目标,同时保留对学生自身策略的适应性。
业界越来越重视可解释 AI 和多模态模型的视觉根基能力。精准的视觉监督信号能提升模型对细节的敏感度,减少语言偏见,是构建可信可靠多模态系统的关键一步。
行业类比
类似自动驾驶系统在决策时必须明确感知依据,VAD 让蒸馏过程更透明,确保学生模仿的是可靠的视觉推理,而非盲从教师的混合信号。
核心洞察
- **VAD 通过反事实视觉归因将教师信号解耦为视觉可归因成分与残留项**,而非像现有方法那样直接蒸馏混合源信号或仅按视觉相关性重新加权。这种解耦让模型只在有视觉证据支持时才依赖教师校正,从而避免将语言先验或教师偏见错误地固化到学生策略中,为多模态知识迁移提供了更干净的信号路径。
- **代理向量 u_t 定义了视觉证据的“符号方向”**,既能捕捉证据对候选 token 的支持,也能捕捉证据对错误 token 的驳斥,这与只关注“支持强度”的视觉优势加权方法有本质差异。由此生成的重建目标在证据反驳错误答案时能产生更强的梯度信号,有效修正学生模型的错误预测,对细粒度视觉理解任务尤为关键。
方法
输入
VAD 的输入包含三部分:
- 学生模型 在当前时间步生成的 前缀序列(partial trajectory);
- 特权视图教师(privileged-view teacher),固定不变,能够访问完整视觉证据;
- 对应的 视觉证据(如高分辨率图像或额外视图)。
关键模块
- 反事实评估 – 在学生前缀处,用同一固定教师分别评估 视觉证据存在 和 证据移除 两种条件,计算教师对候选 token 的 centred log-probabilities,其差值定义为符号化视觉证据方向代理
ut。ut为正表示证据支持某 token,为负表示证据反驳该 token。 - 修正归因 – 将教师原始 next-token 修正(即教师 log-prob 与学生 log-prob 的差异)投影到
ut方向上,得到 干预对齐分量 和 代理无法解释的残差。前者捕获了修正中由视觉证据直接支持/反驳的部分。 - 目标重建 – 仅使用对齐分量,结合学生本身 log-prob,重构一个 学生锚定的蒸馏目标。该目标去除了语言先验和教师特异性,只保留与视觉证据相关的信息。
- 训练信号 – 蒸馏损失以重构目标为主要监督,同时使用原始教师修正作为 弱正则化项,防止过拟合或训练不稳定。
输出
训练过程中,每个 token 位置输出的是一个 重构后的 log-prob 分布,作为学生优化的软标签。最终产出微调后的学生模型,其视觉感知更依赖于真实视觉证据。
与同类方法的差异点
不同于直接蒸馏混合源教师修正或简单加权的方法,VAD 通过反事实推理显式剥离视觉归因分量,仅用“证据支持或反驳”的部分塑造学习目标,从而系统性地减少语言偏差和教师特异性的干扰。
实验
实验设计
- VAD 在 4B 和 9B 参数规模下,于六个细粒度视觉基准上进行评估,覆盖多种视觉任务。
- 基线方法包括直接特权视图蒸馏 (Vision-OPD) 和视觉优势加权 (VA-OPD),均代表当前多模态 on-policy 蒸馏的主流方案。
- 实验从多个维度深入分析:归因修正的语义 (RQ2)、替代监督目标的效果 (RQ3)、后训练检查点的泛化能力 (RQ4) 以及训练超参选择的影响 (RQ5)。
关键发现
- VAD 在所有基准上均一致超越 Vision-OPD 和 VA-OPD,验证了反事实目标重建可以有效剥离源混合信号中的非视觉成分。
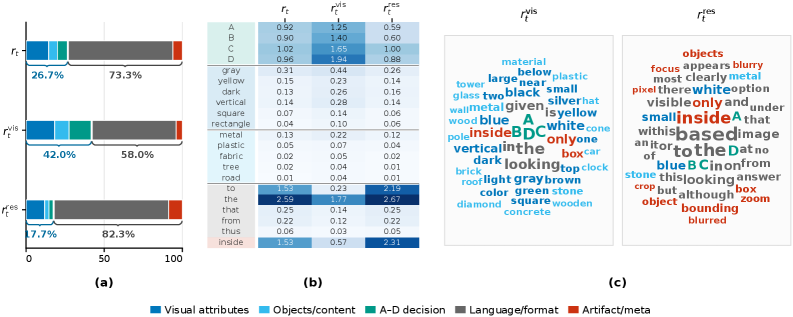
- Token 级分析揭示,代理对齐分量 (proxy-aligned component) 显著富集了任务相关的视觉修正,尤其当证据反驳模型错误答案时,能驱动更强的目标偏移,促使学生模型更准确地纠正误判。
- 归因修正不仅精确定位视觉证据支持的方向,还保留了与教师原始修正一致的干预部分,丢弃了不可解释的残差,从而在蒸馏过程中提供更“纯净”的监督信号。
与基线的对比解读
- 相较于 Vision-OPD 直接使用特权视图教师 logits 作为目标,VAD 通过学生锚定重建,有效抑制了教师特定效应和语言先验的干扰,使修正与视觉证据绑定更紧密。
- 与 VA-OPD 的加权策略相比,VAD 不依赖启发式权重去估计修正的“重要性”,而是从因果角度量化修正中可归因于视觉证据的成分,因此性能增益更稳定且可解释性更强。
行业影响
落地场景
VAD 主要面向需要细粒度视觉理解的多模态产品,例如电商商品图像解析(材质 / 颜色 / 尺寸推断)、内容平台视频审核(识别违规视觉元素而非依赖文本先验)、医疗影像报告生成(病灶视觉证据归因)、自动驾驶场景理解(罕见物体 / 标志识别)。在这些场景中,模型的错误往往源于语言先验或数据集偏差,VAD 通过反事实目标重构将监督信号对齐到可归因的视觉证据,从而减少幻觉式修正。
商业价值
VAD 提供了一种更精准的 on-policy 蒸馏方案:
- 降低错误成本: 电商错配属性导致退货、医疗误判增加风险,VAD 通过强化视觉证据可减少此类损失。
- 提升用户体验: 内容推荐 / 搜索中视觉理解更准确,可提高点击率和留存。
- 节省人工复核: 自动化审核场景中,模型若因视觉证据不足而拒绝判定,可减少人工介入。
- 训练成本可控: 论文显示 VAD 无需额外标注数据,计算开销与直接蒸馏可比(见论文表 8),在 4B/9B 模型上均有效,具备规模化落地潜力。
与现有产品 / 工作流的接口
VAD 可直接嵌入基于 transformer 的多模态训练框架:
- 数据流: 输入为 student 生成的 sequence 和 privileged-view teacher 的 logprobs,不需要改变现有数据管道。
- 训练流程: 可作为现有 SFT / RLHF 流程的插件式蒸馏模块,替代直接 KL 散度或视觉优势加权。训练时 teacher 前向两次(有证据 / 无证据),student 仅需常规前向,显存 / 速度损失可接受。
- 部署: 训练后的 student 模型为标准 VLM,推理无需 teacher,可直接部署到已有 serving 系统。
具体落地用例:
- 电商服装属性抽取: 用户上传衬衫图片,模型需输出“纯棉 / 条纹 / 长袖”。传统蒸馏可能因“条纹”与“衬衫”的文本共现频率而错误强化,VAD 通过遮挡视觉区域后观察 logprob 变化,将修正投影到视觉可解释的方向,确保模型真正看到条纹而非语言猜测。
- 社交媒体视频安全审核: 识别视频帧中是否出现暴力标志。语言先验可能导致模型将“红色液体”错判为血, VAD 在训练 teacher 修正时过滤掉仅由上下文驱动的部分,使 student 更依赖视觉证据,降低误报率。
这种机制尤其适合对可解释性和证据驱动有要求的合规场景,为多模态模型的工业化部署提供更可靠的蒸馏范式。
局限
- 反事实移除的假设与偏差:VAD 通过构造“有证据”和“无证据”视图来估计视觉贡献,但无证据视图(如遮挡、模糊或零图像)可能引入人为分布偏移,使教师模型在异常输入下的行为与正常情况不一致,从而影响 proxy u_t 的准确性。论文未充分讨论不同移除策略的影响,这可能限制归因的可靠性。
- 计算效率:训练时需要为每个前缀执行两次教师前向(有证据和无证据),相比标准 OPD 增加约一倍教师开销。虽然论文自称效率可接受,但在大规模训练或频繁在线蒸馏场景中,这可能成为瓶颈。实验仅在 4B/9B 模型上验证,更大模型上的计算成本未评估。
- 任务与模态泛化:实验集中在细粒度视觉基准,未验证方法在非视觉模态(如音频、视频)或多模态任务(如视觉问答中的语言主导场景)上的有效性。此外,假设视觉证据是主要可归因源,对于需要复杂多模态推理的任务,视觉证据可能不充分,方法可能失效。