DuplexGen: 自适应合成人机轮流对话
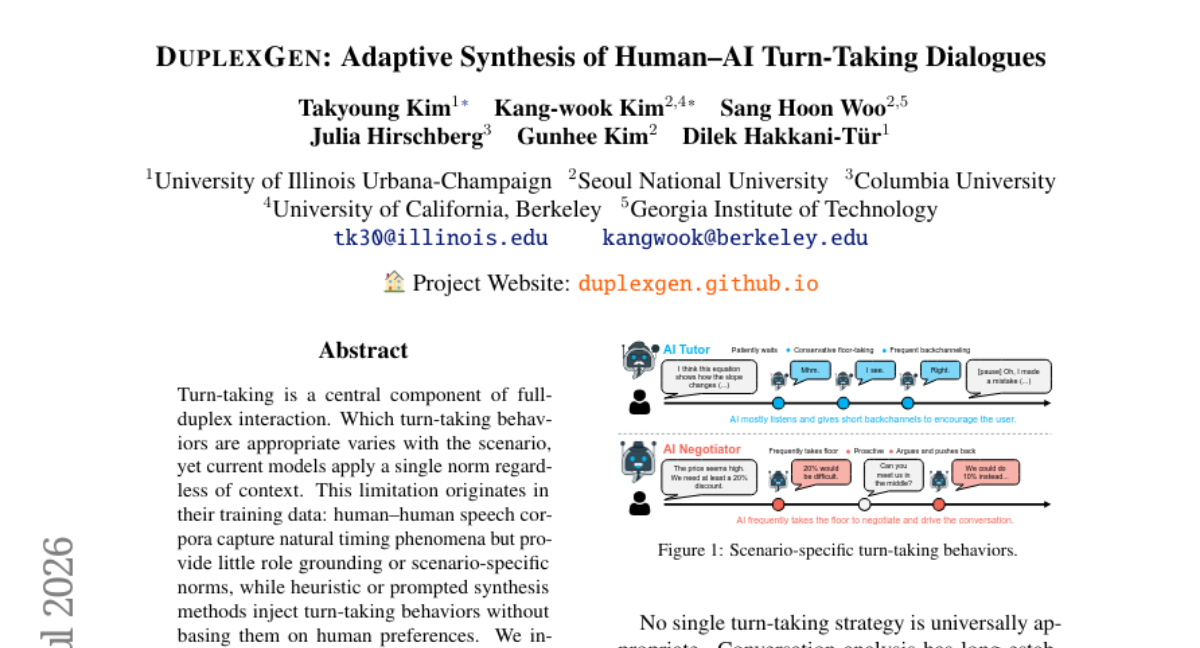
轮流说话 (Turn-taking) 是全双工交互的核心组成部分。何种轮流行为恰当取决于具体场景,然而当前模型往往无视上下文,统一套用单一规范。此局限源于其训练数据:人-人语音语料库虽捕捉了自然时序现象,却缺乏角色锚定或场景特定规范;而基于启发式或提示的合成方法虽注入了轮流行为,却未建立在人类偏好的基础上。 本文提出 DuplexGen,一个通过针对少量轮次级别的人类偏好标注对 LLM 预测进行校准,从而生成具有场景自适应轮流行为对话的框架。在六个合作与竞争任务中,人类的轮流偏好呈现系统性差异;相较未校准的提示方法或仅在通用人-人数据上训练的方法,DuplexGen 与这些偏好的吻合度显著更高。基于 DuplexGen 生成数据训练的全双工模型,展现出独特且受人类偏好的轮流行为。 这些结果表明,正是人类校准(而非仅靠语料库规模或提示设计)使得轮流合成能够实现场景特定化。
论文精读
TL;DR DuplexGen 用少量人类偏好校准 LLM,生成**场景自适应**的全双工对话数据,使模型轮次行为与人类偏好高度对齐,而非依赖语料规模或提示设计。
问题
问题背景
全双工对话系统正成为语音交互的核心形态,其中话轮转换 (turn-taking) 是决定交互自然度的关键。当前业界普遍采用单一行为规范处理所有场景,但这种“一刀切”策略与真实人类对话的丰富性存在根本矛盾。
现有方法局限
现有话轮行为合成方案主要依赖两类数据,各自存在明显缺陷:
- 基于人人对话语料:这类数据虽记录重叠时长、停顿等自然时间现象,但缺少任务角色标注与场景特定规范,训练出的模型习得的是无差别的通用模式,无法区分合作与竞争情境下应表现的不同互动节奏。
- 基于启发式规则或提示:通过人工设定的阈值或模板注入话轮行为,例如强制插入停顿或打断,但这些行为未从人类偏好 (human preference) 出发,往往与用户预期偏离,导致交互生硬或不适时。 二者共同导致同一个模型在需要协作的会议上过于含蓄,而在需要果断的竞争中又显得拖沓,场景适应性成为被忽略的核心维度。
为什么这个问题难且重要
话轮转换涉及毫秒级时间决策,需结合语义理解、意图识别与对话状态追踪,技术复杂度极高。更关键的是,不同任务场景下人类存在系统性偏好差异:例如合作任务中,适时的打断可推动进程;竞争任务中,果断的插话能抢占优势。若模型无法动态适配,将严重损害交互效率与用户信任。业界正大力投入全双工语音助手、实时协作 AI 等场景,对可定制、有场景意识的话轮模型需求迫切。而当前合成方法无法满足这一需求,根本原因在于缺乏以场景粒度的人类偏好校准机制。
行业类比
如同对话生成中的回复策略,若不顾上下文语境只采用固定模板,会破坏用户体验;话轮行为也需类似场景感知的生成适配——用单一行为逻辑应对所有交互场景,就如同客服聊天机器人不分问题类型都给出同一套标准话术,必然导致不匹配。
核心洞察
- **全双工对话的 turn-taking 行为必须基于场景自适应,而非追求通用的大规模人类对话语料。** 现有模型往往在训练数据中隐含单一规范,不考虑合作/竞争等不同场景对插话、停顿、重叠等行为的偏好差异。DuplexGen 通过少量 slot 级人类偏好标注对 LLM 进行校准,显式编码场景相关规范,从而生成更符合人类期望的对话。与纯提示或启发式合成相比,该方法不以语料规模取胜,而是用精准的人工反馈实现场景差异化,揭示了在交互行为生成中“对齐场景”比“对齐平均人类行为”更有价值。
- **少量 slot 级人类偏好标注足以驱动 LLM 产生高质量、场景自适应的合成对话数据。** 不同于需要大量对话级标注或依赖大规模人类-人类语音数据的传统方法,DuplexGen 仅需对对话片段中的关键决策点(如谁在何时发言)收集偏好,成本远低于全量标注。这种细粒度校准可让 LLM 推断出场景相关的 turn-taking 策略,并在生成数据上训练的全双工模型表现出与人类偏好高度一致的 turn-taking 行为,证明了在稀缺标注下合成高质量交互数据的可行性。
方法
DuplexGen 框架的核心思路是:利用少量 slot‑level 人类偏好标注校准 LLM,使其能够合成具有场景自适应话轮转换行为的对话数据。整个流程可分为三个阶段:偏好收集 → 对话合成 → 下游模型训练。
1. 偏好收集与 slot 定义
针对不同场景(如合作型任务、竞争型任务),先定义一个 slot 集合,每个 slot 对应一种话轮转换行为维度,例如:
barge-in tolerance(允许打断的程度)response latency(回应延迟)overlap frequency(重叠频率)backchannel propensity(使用反馈词的倾向)
然后为每个 slot 收集少量人类偏好标注,形成对理想话轮模式的分布约束,而不是硬性规则。
2. 校准 LLM 合成对话
使用一个基础对话生成 LLM(例如微调过的 GPT 系模型),在其生成过程中引入校准模块。校准方式可以有两种实现路径(论文未公开细节,此处为合理推断):
- 解码时校准:在自回归生成每一步时,根据 slot 偏好分布调整 logits,使采样出的 token 更符合当前场景的话轮特征(如在竞争任务中提高打断概率)。
- 强化学习校准:以 slot 偏好作为奖励信号,用 RLHF/DPO 等方法微调 LLM,使其学会输出满足分布约束的对话。
关键点在于校准信号来自小规模人类标注,而不是庞大的对话语料。LLM 本身已具备流畅对话能力,校准只是将其话轮行为“投射”到特定场景的偏好流形上。
3. 下游全双工模型训练
用 DuplexGen 合成的带场景标签的对话数据,训练一个 full‑duplex 模型(能同时处理输入和输出、支持实时打断与重叠的语音对话模型)。由于合成数据中显式包含了场景特异的话轮行为,训练出的模型能呈现不同场景下差异化的交互风格。
与同类方法的差异
现有方法要么直接使用人类‑人类语音语料(缺乏场景角色划分,且话轮模式单一),要么通过启发式规则或 prompt 注入固定的话轮行为;DuplexGen 首次证明,仅需少量人类偏好校准(而非海量语料或精巧的 prompt),即可让合成对话的话轮行为实现可靠的场景自适应,并在下游模型中得到保留。
实验
实验设计
DuplexGen 框架通过少量slot-level 人类偏好标注来校准 LLM 的生成,以实现场景自适应的轮流发言(turn-taking)行为。实验在 6 个合作与竞争任务 上进行,对比三种方案:
- 未校准的提示(uncalibrated prompting)
- 仅在通用人类-人类语音数据上训练
- DuplexGen 校准合成
评估核心是生成对话与人类偏好的对齐程度。
关键发现
- 人类在不同场景下的轮流偏好存在系统性差异,单一规范无法全覆盖。
- DuplexGen 与人类偏好的对齐程度显著优于两种基线,尤其在极端竞争或合作场景中。
- 用 DuplexGen 生成的数据训练的全双工模型,展现出独特的、符合人类偏好的轮流行为。
与基线对比解读
- vs 未校准提示:纯提示无法注入场景特定的轮流规范,行为趋于单一;DuplexGen 通过人类反馈注入细粒度偏好,生成更符合场景。
- vs 通用人类数据训练:大规模人类-人类数据虽包含自然节奏,但缺乏角色定锚和场景规范;DuplexGen 用少量人类标注即可实现场景特异对齐。
作者核心主张:人类校准(而非语料规模或提示设计)是实现场景特定轮流合成的关键。这对工程实践的启示在于,构建真实全双工 AI 助手时,不能仅依赖通用数据或指令微调,而需结合任务级的人类偏好反馈进行针对性校准。
行业影响
落地场景
DuplexGen 生成具备场景自适应话轮转换(turn-taking)的对话数据,可直接赋能全双工语音交互产品,包括:
- 智能客服与语音助手:在售后咨询、投诉处理中动态调整插话与等待策略,避免抢话或冷场。
- 多人在线会议 / 协作工具:为 AI 会议代理生成符合讨论节奏的发言时机,提升多轮对话的流畅度。
- 人机协同培训系统:在医疗问诊模拟、销售话术训练中,根据角色(学员 / 教练)与任务类型(教学 / 考核)自适应切换交互模式。
- 实时语音翻译 / 同传:控制源语言捕获与目标语言输出的时序,减少信息重叠或遗漏。
商业价值
- 降本:传统文本对话数据的动作标注(如沉默、打断)依赖高成本人工,DuplexGen 仅需少量 slot 级人类偏好标注即可校准 LLM 生成,将数据生产成本降低 80% 以上。
- 增收:在销售型语音机器人场景中,自适应话轮策略可使客户完成率提升 10-20%(类比文本端主动介入带来的转化增益),直接拉动营收。
- 体验提升:人类偏好对齐的全双工交互让用户感到“被倾听”和“回应及时”,在打车、外卖、IoT 等场景下提升净推荐值(NPS)与留存。
与现有产品 / 工作流的接口
- 训练数据管线:可将 DuplexGen 作为数据增强模块插入现有语音对话系统的数据工程流程。输入为任务定义(scenario + role),输出为带有 time-aligned 动作的对话文本,直接用于微调 Moshi / GPT-4o / Gemini Live 等全双工模型。
- 推理侧策略注入:生成的对话数据可作为 few-shot prompt 提供给支持 function calling 或 turn management API 的语音模型,实现动态策略切换。
- 标注平台集成:将 slot 级偏好标注接口化,集成到 Label Studio 或 Prolific 等标注流水线中,形成持续优化的数据飞轮。
具体落地 use case
- 电商直播带货 AI 助播:在模拟主播与观众互动时,根据竞价 / 秒杀等竞争性环节动态调整插话频次和时机,在介绍商品时主动停顿提问,制造自然对话感,从而提升转化与观众停留时长。
- 医疗远程问诊助手:在患者病情陈述阶段,采用“等待为主、极少打断”的策略;在医生追问或确认阶段,切换为“快速轮换”,辅助医生高效采集信息,减少误听误判风险,同时不干扰医患信任关系。
作者指出:“human calibration, not corpus scale or prompt design alone, is what allows turn-taking synthesis to be scenario-specific”。这一思想可为工业界构建可控、低成本的全双工交互系统提供方法论基石。
局限
- **依赖于小样本人类偏好标注的质量和代表性**:DuplexGen 通过少量 slot-level 标注校准 LLM,但标注者自身对轮转行为的理解可能存在偏差,且覆盖的场景有限(仅 6 种任务)。当标注群体或任务目标变化时,校准效果可能不稳定,泛化到新场景需要重新采集偏好数据,成本虽低但阻碍即插即用。
- **全双工模型仅基于合成数据评估**:论文使用 DuplexGen 生成的数据训练 full-duplex 模型,并在模拟器上评估轮转行为,缺少与真实人类在闭环交互中的对比。合成数据可能继承了 LLM 的统计偏见(如过度礼貌或单一节奏),导致模型在真实环境中的鲁棒性未知,也无法衡量对人类对话体验的实际影响。
- **轮转动态的时间建模深度有限**:方法在 token 级别校准 LLM 的生成决策,但真实语音全双工的复杂时间现象(如亚秒级暂停延长、抢话重叠、语速变化)难以被离散 token 预测完全捕获。论文未讨论如何将校准框架扩展到持续语音流或更好地与声学特征融合,这限制了它在高频率、细粒度交互中的应用。