GPT-Red: 通过大规模自我对弈实现自动红队测试
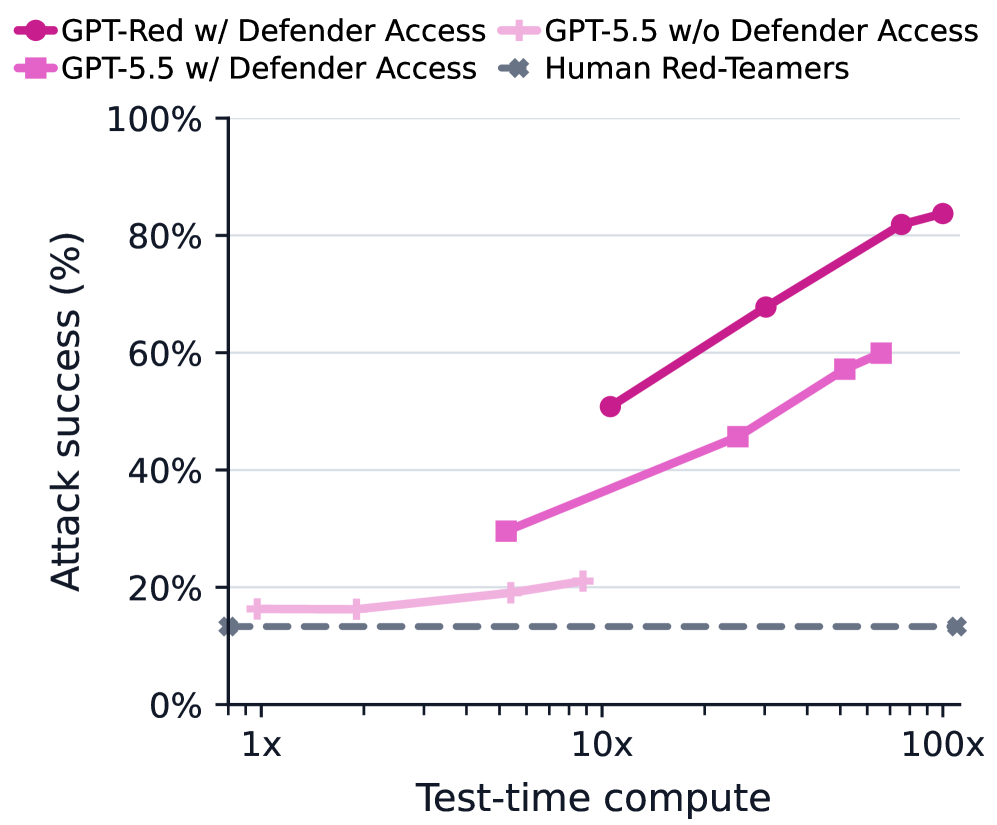
我们提出了 GPT-Red,一个自动红队代理,经过训练可以发现针对前沿 LLM 的新型提示注入攻击。目标是为了评估和提升我们生产系统的鲁棒性。为此,我们使用它来对抗训练 GPT-5.6,这是迄今为止我们对提示注入最鲁棒的模型。 为了创建 GPT-Red,我们设计了一种可扩展的 自我对弈 (Self-Play) 算法:模型的任务是攻击一个同时训练的多样化的防御代理群体。我们在逼真的红队环境中训练模型,使用的计算量与一些最大的 RL 后训练运行相当,使其成为有史以来最大规模的 LLM 安全训练运行。 GPT-Red 在红队测试中表现出色:它可靠地攻破我们过去的模型(直至 GPT-5.5),比人类红队成员发现更多成功攻击,并且泛化到未见过的环境、防御模型和工具。未来,随着每个新 GPT 模型的鲁棒性提升,期望它能提供更强的学习信号,从而实现自我改进的飞轮效应。
论文精读
TL;DR GPT-Red 通过大规模自博弈训练自动红队智能体,高效发现提示注入漏洞并超越人类红队,驱动模型鲁棒性飞轮迭代。
问题
问题背景
当前大型语言模型(LLM)越来越多地部署在智能体(agentic)环境中,需要处理来自不可信第三方的指令和数据。提示注入(prompt injection)和越狱(jailbreak)攻击可直接操纵模型行为,成为安全部署的核心威胁。业界亟需可扩展的自动化红队测试方法,持续发现模型脆弱性以支撑鲁棒性训练。
现有方法局限
传统的红队测试依赖人类专家手写攻击样本,或使用固定提示模板的LLM生成攻击。这类方法存在两个关键局限:
- 数据规模与多样性不足:人工标注成本高,生成的攻击样本数量有限,导致模型在对抗训练后容易过拟合到特定的攻击模式,对未见过的变体泛化能力差。
- 缺乏自适应性:静态的预定义攻击无法随模型更新而进化。一旦目标模型通过微调或强化学习修补了已知漏洞,旧的红队样本就失效,需要重新人工构造,形成“打地鼠”式的被动循环。
核心挑战与重要性
构建可自动进化的红队智能体面临双重挑战:
- 探索与利用平衡:攻击者必须在已知有效的攻击策略(利用)和发现全新漏洞(探索)之间动态取舍,同时避免生成无效或无意义的输入。
- 多场景泛化:生产环境中,防御模型各异,攻击载体(如直接注入、间接注入、安全拒止绕过)多样,单一攻击策略难以覆盖。
这一问题的重要性在于,随着模型能力不断提升,其被滥用的风险同步增长,工业界将自动化红队视为规模化的安全测试基础设施。缺乏持续、自动化的红队流程,就无法保证每个新版本模型在上线前达到足够的鲁棒性。
行业类比
与自动驾驶系统通过仿真环境中的对抗交通场景生成来提升感知鲁棒性类似,LLM需要与其自身对称迭代的红队智能体,在对抗博弈中形成自我强化的安全飞轮。
核心洞察
- 通过同时训练攻击者与防御者种群的自博弈方法,GPT-Red 解决了传统红队数据规模受限、易过拟合的问题。与依赖静态数据集或单轮对抗的工作不同,双方的共同演化为攻击者提供了源源不断的新防御策略作为学习信号,从而持续发现更隐蔽、更通用的提示注入攻击,为自动化安全测试提供了可扩展的持续改进范式。
- GPT-Red 的训练投入与前沿模型的大规模 RL 后训练持平,这是首次将红队工具本身的训练扩展到如此庞大的计算规模。实验表明,这种投入带来了攻击多样性、成功率和泛化能力的质变,使其在多个留存场景中超越人类红队专家,为安全关键系统中攻击模拟的可信度与覆盖面设立了新标准。
- 该工作将自动化红队与生产模型的对抗训练形成闭环:GPT-Red 用于训练 GPT-5.6,使后者的鲁棒性达到历史最佳,而更鲁棒的目标又可反过来为 GPT-Red 提供更强学习信号,构成自我强化的安全飞轮。这一设计理念为代理型 LLM 的长期安全演进提供了工程上可行的路线图,将安全从一次性评估转变为持续对抗提升的动态过程。
方法
核心机制
GPT-Red 是一个基于 大规模自对弈(Self-Play)训练的红队代理,用于自动发现针对前沿 LLM 的 提示注入(Prompt Injection)攻击。其训练流程按“输入 → 关键模块 → 输出”展开:
- 输入:一组同时训练的 防御者模型种群(Diverse Defender Agents),以及真实红队环境(如直接/间接提示注入、安全拒答越狱)。攻击者以防御者当前状态为条件,生成对抗性提示。
- 关键模块:
- 对抗性种群训练(Adversarial Population Training):构建多样化的防御者群体,攻击者与防御者同步更新。攻击者需攻破不同防御者变体,从而学习泛化性更强的攻击策略。
- 训练稳定化与扩展(Stabilizing and Scaling Self-Play):使用与最大规模 RL 后训练同级别的算力,引入稳定化技术(如对手采样、奖励塑形),避免模式坍塌。
- 推理时扩展(Inference Scaling of Attackers):攻击者生成样本时通过扩展搜索或采样提升攻击成功率。
- 输出:训练得到的 GPT-Red 模型能可靠攻破 GPT-5.5 及更早模型,发现比人类红队更多样、更成功的攻击,并可泛化到未见过的防御模型与测试框架。
与同类方法的差异
传统红队依赖 静态攻击数据集 或 有限人类专家,易导致防御模型过拟合。GPT-Red 首次在 完全自动化自对弈 中持续发现新型攻击,形成攻防能力共同提升的 自我改进飞轮,且训练规模为同类安全工作中最大。
实验
实验设计
GPT-Red 通过大规模 self-play 算法训练,攻击者模型同时与多样化的防御者代理群体对抗。训练环境模拟 直接/间接提示注入 和 安全拒答越狱 等真实场景。红队攻击成功与否作为奖励信号,驱动强化学习优化。该训练的计算规模与最大的 RL 后训练运行相当,是迄今有记录的最大 LLM 安全训练。
关键发现
GPT-Red 展现出强大的自动化红队能力:它能可靠地攻破从早期模型到 GPT-5.5 的所有历史版本,发现的成功攻击数量超过人类红队队员。该代理不仅在新颖的攻击样本上表现优异,还展现了良好的泛化性——对未见的防御模型、评估工具和环境仍然有效。基于 GPT-Red 的对抗训练得到的 GPT-5.6 成为迄今为止对提示注入最鲁棒的模型。
与基线对比的解读
相比传统依赖人类红队或有限攻击数据集的方法,GPT-Red 的 self-play 训练从根本上解决了数据多样性和规模瓶颈。人类红队虽然能提供高质量样本,但耗时且覆盖范围有限;GPT-Red 则可持续生成大量多样化攻击,避免防御模型过拟合特定攻击模式。与之前的自动化红队工具相比,GPT-Red 在攻击成功率和泛化性上均占优,更重要的是它开启了自我改进的飞轮:更鲁棒的模型反过来提供更好的学习信号,进一步强化红队代理,形成正向循环。
行业影响
落地场景
GPT-Red 的自博弈红队训练范式可直接用于所有部署 大语言模型 的产品线,尤其是存在提示注入风险的交互式应用。典型落地场景包括:
- AI 客服与智能助手:电商、金融、电信等领域中,攻击者可能通过恶意提示诱导模型泄露用户数据、执行未授权交易或生成违规内容。GPT-Red 可持续生成新型攻击,用于对抗训练和安全评估。
- 代码助手与低代码平台:开发者工具中的 AI 代理若被注入恶意指令,可能生成含漏洞代码或执行危险操作,自动化红队可提前发现此类缺陷。
- 内容审核与安全防火墙:作为红队即服务 (red-teaming-as-a-service) 的核心引擎,为第三方模型提供持续攻击模拟和安全性度量。
商业价值
- 降本增效:替代或增强人类红队,将一次性的专家测试转化为持续自动化流程。据论文,GPT-Red 找到的成功攻击数超越人类红队,且训练计算规模与大型 RL 后训练相当,适合批量部署。
- 风险控制:通过对抗训练提升模型鲁棒性,直接降低因提示注入导致的数据泄露、品牌声誉受损及合规罚款风险。GPT-5.6 的使用展示出模型安全性可随每次迭代持续提升,形成飞轮效应。
- 差异化竞争力:对于售卖 AI 安全服务的企业,可提供有 SLA 保障的安全基准测试报告,成为客户选型的关键指标。
与现有技术栈的集成
- MLOps 管道:作为模型发布前的一道自动化关卡,接入 CI/CD 流程,在新模型注册后自动触发红队评估,输出漏洞报告。
- 安全运营中心 (SOC):与生产环境监控工具联动,实时分析线上流量异常,提取新型攻击 payload 并回流至训练集。
- 人工红队协同:GPT-Red 生成的海量候选攻击可由安全专家精选,补充到针对性的防御策略中,形成人机协同闭环。
具体用例:
- 电商平台客服机器人:攻击者向机器人发送伪装的退款请求,实际注入指令获取其他用户的订单信息。GPT-Red 可生成数千条变形注入样本,用于训练机器人抵抗此类信息泄露攻击。
- 金融投资顾问 Agent:通过伪装成正常行情分析的提示,诱导模型建议高风险产品,绕过合规审核。自动化红队能持续扫描此类越狱行为,确保生产模型符合监管要求。
局限
- 计算资源需求巨大:训练使用与最大RL后训练运行相当的资源,可能是数千块GPU数月的规模,这限制了学术界和小型公司的复现与进一步研究。虽然证明了规模化有效,但这种方法可能只有少数顶级实验室能够负担,从而加剧安全研究的不平等。此外,论文未提供降低计算成本的轻量版本或效率分析,使得其在实际应用中门槛过高。
- 攻击多样性与泛化性局限:尽管GPT-Red在保留环境和防御模型上展示了泛化能力,但红队环境仍由研究者设计(直接/间接提示注入、越狱),可能无法覆盖所有真实世界的攻击向量,如多模态注入、社会工程混合攻击。自博弈训练出的攻击策略可能偏向于已有环境中的模式,面对全新的攻击范式时可能失效。模型主要针对文本提示注入,而未来LLM多模态化会带来新的脆弱性。
- 自我提升飞轮的假设依赖:作者设想随着模型鲁棒性增强,红队也能提升,形成飞轮。但实践中,如果防御模型过强,攻击者可能遭遇训练停滞(reward稀疏),导致无法发现新攻击。论文未验证这种飞轮在实际多轮迭代中的稳定性,也未探索在防御模型过度适应时如何重置攻击者,这可能限制长期提升。