弱到强同策略蒸馏
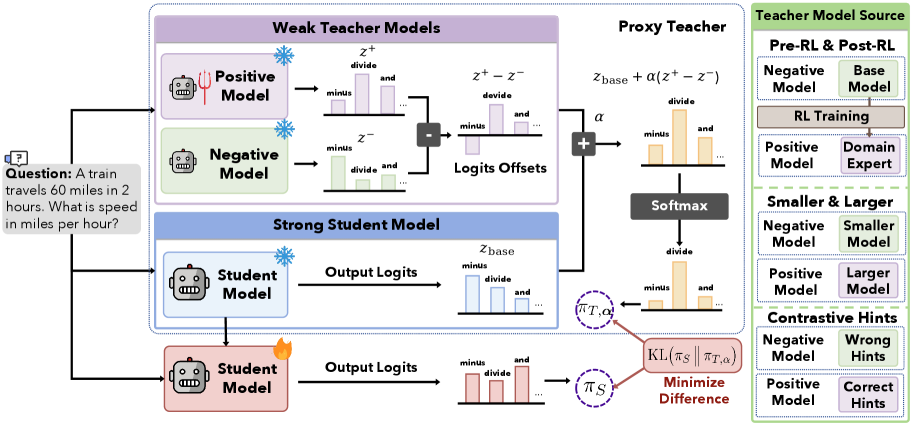
同策略蒸馏 (OPD) 是跨大语言模型能力迁移的有效范式,它将学生的逐词分布与教师在其自身轨迹上的分布对齐。然而,现有方法普遍假设教师至少与学生同样强大:要么将更大模型蒸馏为更小模型,在模型前沿失效;要么合并基于共享底座训练的多个领域专家,需要昂贵的学生规模训练。 我们提出 弱到强同策略蒸馏 (W2S-OPD),一个简单而有效的 OPD 框架,通过蒸馏多个弱模型来提升强学生。该方法在 logit 空间构造一个代理教师,由一对正负对比模型组成,两者均小于学生且获取成本低。它们的 logit 差值隔离出能力方向,并与学生自身的基础模型相加,形成既耦合该方向又与学生分布邻近的代理教师。随后,学生通过最小化自身轨迹上的逐 token 反向 KL 散度来蒸馏该代理教师。我们实例化了三组对比对: 1. 后 RL 专家 对 RL 前初始化,隔离 RL 赋予的技能; 2. 较大基础模型 对 较小基础模型,隔离规模带来的能力; 3. 带正确提示的小模型 对 带错误提示的小模型,隔离实例级解题方向。 在四个数学基准和三个代码基准上,W2S-OPD 优于标准 OPD,使得学生能够超越领域教师,并且即使所有监督来源都更弱,也能持续改进学生。分析表明,不同对比产生不同信号:后 RL 与提示对比强调推理框架,而规模对比强调求解过程。代码将发布于 https://github.com/Yu-Fangxu/W2S-OPD。
论文精读
TL;DR W2S-OPD 通过弱模型的 logit 差异构造代理教师,实现在没有更强监督下的弱到强蒸馏,让强学生模型在自身策略上持续提升并超越领域专家。
问题
问题背景
大语言模型(LLM)的能力迁移是当前研究热点,On-Policy Distillation (OPD) 通过让学生模型在自己的生成轨迹上匹配教师模型的 token 级分布,成为一种高效的知识传递范式。
现有方法局限
传统 OPD 方法隐含假设教师模型至少与学生同等强大,典型方案包括:
- 将大模型蒸馏到小模型,但在能力前沿无更强教师可用;
- 从统一基座训练多个领域专家再合并,这需要在学生模型尺度上进行昂贵训练,成本高且灵活性差。 这两种方式都未能解决“当所有监督来源都比学生弱时,如何持续提升学生”的关键问题,限制了 OPD 在真实场景的适用性。
为什么这个问题难/重要
随着 LLM 规模突破,获得更强的教师模型愈发困难,而弱模型的信号往往噪声大、方向不一致。如何从多个弱监督中提取有效增量方向,并让学生在不偏离自身分布的前提下吸收这些信号,是技术上的核心挑战。业界对此高度关注,因为该方向有望打破对强标注或大教师模型的依赖,实现模型的自举提升,降低持续进化的成本。
行业类比
这与 代码生成 中利用弱代码审查模型来指导强生成模型优化其输出质量的场景类似,旨在不依赖更强模型的情况下实现能力增强。
核心洞察
- 弱到强的蒸馏新范式:传统 on-policy distillation (OPD) 要求教师模型至少与学生能力相当,而 W2S-OPD 突破性地仅用弱模型构建代理教师,通过对比正负弱模型提取“能力方向”,注入强学生,实现弱到强的能力迁移。这为解决大规模前沿模型因无更强教师而无法蒸馏的困境提供了可行路径,实验验证学生不仅超越弱教师,甚至能超越原始领域专家。
- logit 空间的对比算术:W2S-OPD 的核心操作是在 logit 空间中计算正负模型的差值,并将其作为能力方向叠加到学生基模型上,形成分布上贴近学生的代理教师,再通过 reverse KL 蒸馏。这种轻量的方向运算避免了模型融合或额外训练,将能力提取与注入转化为可解释的向量运算,为模型增强提供了一种低成本、模块化的新思路。
- 多源弱信号的差异化增益:论文实例化三种对比对——RL 前后、不同规模基模型、正确与错误提示——分别捕捉推理框架、尺度能力与实例级解题方向。分析显示不同对比对强化的 token 类型有侧重,这为根据任务需求灵活组合弱信号、定制学生能力提供了依据,打破了“教师越强越好”的单一假设。
方法
W2S-OPD 的输入包括一个待提升的强学生模型(记为 student base model)和一组弱对比模型对:一个正例模型与一个负例模型,两者均比学生小。方法的核心是**代理教师合成(Proxy Teacher Synthesis)**模块:首先计算正例与负例在 token 层级上的 logit 差,该差值被定义为该对比对所隔离出的“能力方向”(capability direction);然后将此方向乘以一个放大系数 α,加和到学生自己 base model 的 logit 上,即得到代理教师的 logit 分布。这样构造的代理教师既蕴含了弱模型对比出的能力信号,又保持在分布上与学生相邻(distributionally adjacent),从而降低蒸馏难度。随后进行 on-policy 蒸馏:学生模型在自身推理轨迹(rollouts)上,通过最小化与代理教师间的 per-token reverse KL 散度来更新参数,使得学生在线地吸收对齐的能力方向。W2S-OPD 提供了三类典型对比对实例化:(1) 强化学习后专家 vs. 其初始化模型,隔离 RL 带来的技能;(2) 较大基座模型 vs. 较小基座模型,隔离规模带来的能力;(3) 带正确提示的小模型 vs. 带错误提示的同一小模型,隔离实例级解题方向。多组对比对可组合使用,通过统一公式合成单个代理教师。输出为训练后的强学生模型,其在数学、代码等基准上可超越原本的领域教师。与传统 OPD 不同,W2S-OPD 不要求存在比学生更强的教师,而是利用弱模型组合出有效的监督信号,使强学生实现弱到强的能力提升。
实验
实验设计
实验在四个数学基准(MATH、GSM8K、TheoremQA、MMLU-Math)和三个代码基准(HumanEval、MBPP、CodeContests)上评估 W2S-OPD 的有效性。
- 学生模型选用 7B 或 13B 参数的 LLM,教师全部为参数规模更小的弱模型(如 1.5B、3B 等)。
- 对比对(positive / negative)涉及三种实例:
- post‑RL expert vs. pre‑RL init(捕获 RL 注入的技能)
- 不同规模基座对比(捕获规模带来的能力)
- 小基座配合正确 / 错误提示(捕获实例级解题方向)
- 蒸馏目标为学生自身 rollout 上的 per‑token reverse KL,代理教师由 logit 差值叠加学生基座 logits 得到,并引入放大系数 α 控制信号强度。
关键发现
- W2S-OPD 在所有基准上一致优于经典 OPD,即使所有监督源都比学生弱,学生能力仍持续提升,甚至超越领域专属教师。
- 不同对比对提供互补的信号:post‑RL 和提示对比强调推理框架,规模对比强调解题步骤;组合多代理后可获得更全面的能力提升。
- 分析表明,蒸馏主要增强了推理关键 token(如数学题中的运算符、代码分支点),而非均匀作用于所有 token。
与基线对比深度解读
OPD 要求教师至少与学生同等能力,这在前沿模型训练中难以满足,而 W2S-OPD 仅利用弱模型即可构造高质量代理教师,从根本上解决了无强教师可用的困境。
- 通过 logit 空间中的对比(positive − negative)直接分离能力方向,再叠加学生自身基座,保证代理教师与学生分布邻接,有效避免模式坍塌与分布外漂移。
- 实验证明,该方法比直接蒸馏弱教师或简单集成更稳定,且支持多代理统一蒸馏,允许灵活组合不同来源的弱信号。
- 这一范式为大规模模型的持续提升提供了低成本的路径:只需训练小的 positive/negative 对,即可驱动大模型在特定能力上自改进。
行业影响
落地场景
W2S-OPD 将模型能力增强范式从“依赖更强教师”转变为“聚合弱模型信号”,适用于迭代式自我改进场景:
- 智能客服与对话系统:企业通常拥有多个垂直领域的弱专家模型(如退款、物流、产品咨询),但无统一强基座。W2S-OPD 可将这些弱模型蒸馏到一个强学生中,生成覆盖全业务的客服机器人。
- 代码生成助手:利用规模较小但精于特定语言或框架的模型,以及带有正确/错误提示的小模型,持续增强通用代码 LLM,提升补全与修复准确率。
- 教育内容生成:将不同学科(数学、物理、编程)的小型专家模型信号注入大模型,改善跨学科推理与讲解能力,而无需重训整个基座。
商业价值
- 降低教师成本:无需寻找或训练比学生更强的模型,直接利用已有弱模型即可提升旗舰模型,避免昂贵的大模型蒸馏或人工标注。
- 自动化组织知识整合:企业内多个部门或团队累积的弱模型可被统一吸收,将隐性专家经验转化为学生模型的通用能力,缩短研发周期。
- 持续学习与收入提升:通过定期加入新的弱对比信号(如新任务微调后的专家 vs 其初始模型),产品模型可不断进化,延长服务生命周期,进而提高用户留存与付费意愿。
与现有产品/工作流的接口
W2S-OPD 可作为后训练增强模块嵌入现有 LLMOps 流水线:
- 在 RLHF 或监督微调后,采集正负对比模型(例如
post-RLvspre-RL,或更大 vs 更小基座),利用logit差分合成代理教师,然后执行 on-policy 蒸馏,无需改动原有训练框架。 - 支持与 PEFT(如 LoRA)结合,仅需加载对比模型的适配器即可生成代理教师,存储和计算开销极低。
具体落地场景示例:
- 电商平台多语言商品问答:拥有英语、中文、日语三个小语言客服专家模型,通过 W2S-OPD 将它们分别作为正模型,其各自的基础预训练版本作为负模型,蒸馏到一个多语言强学生中,实现跨语言知识迁移,提升非英语场景下的解答质量。
- 金融研报分析系统:用少量领域数据对一个小模型进行 SFT 得到领域正模型,以其初始模型为负模型,提取金融推理方向,注入通用大模型,使其具备财报关键信息抽取和风险归因能力,而无需训练昂贵的金融专用大模型。
局限
- 代理教师的合成质量高度依赖正负模型对比方向的可靠性,论文未深入讨论弱模型退化或噪声对最终性能的影响。实际场景中获取恰当的弱模型对可能并不容易,且不同对比对(如 post-RL、scale、hint)的选择对结果影响较大,但缺乏系统性的选择指导或自适应机制。
- W2S-OPD 需要加载多个弱模型并计算 logit 差异,增加了训练时的存储与计算开销。虽然论文报告了每次迭代加速,但总体训练成本仍可能高于单教师 OPD,尤其在需要多个代理教师时。此外,该方法建立在任务相关能力方向存在于 logit 差异中的假设上,在非数学、非代码等更开放域任务上的有效性尚待验证。
- 与标准 OPD 相比,W2S-OPD 突破了教师必须强于学生的限制,但引入了更多超参数(如放大系数 α、对比对类型),且全部实验仅在 Llama-3 规模模型上完成。未探索更大模型、不同架构或非推理类任务的泛化性,也未与更现代的蒸馏方法(如多教师知识融合)进行横向对比,其相对优势的边界尚不清晰。