Seeing or Knowing? Multimodal Large Language Models 中的视觉上下文敏感性
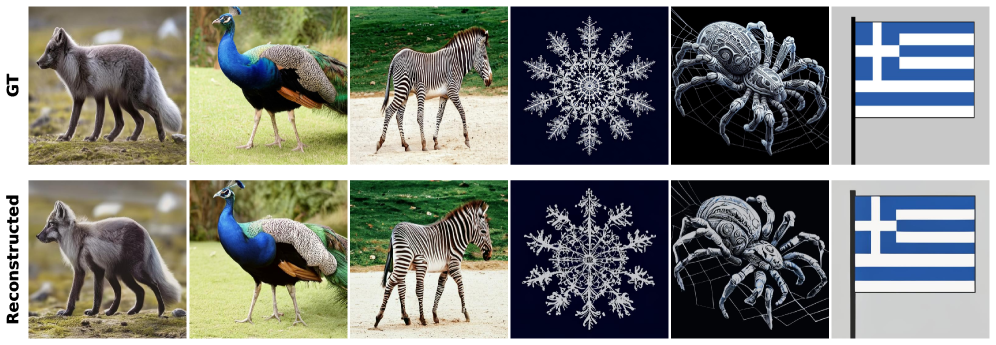
多模态大语言模型(MLLMs)通过将视觉输入与预训练语言模型的丰富先验知识相结合,取得了强劲性能。然而,它们在以视觉为中心的任务上往往表现不佳,尤其是当视觉证据与预训练知识相冲突时。我们使用两种诊断范式分别探索这些失败:(1) 通过图像重建探测视觉信息是否可用;(2) 衡量多模态上下文敏感性,即模型遵循视觉上下文而非语言先验的程度。为此,我们引入了 WhatIfVis 基准,涵盖五个粗粒度维度(时空、颜色、计数、大小、重量),其问题的答案可来自图像或先验。 我们的分析得出三点发现:(i) 粗粒度视觉证据被保留,因为这些属性可从冻结 MLLMs 的最终层图像 token 中重建。因此,关于这些属性的失败指向感知后利用,而非感知过程中的视觉编码退化。(ii) 即使明确指示使用或忽略视觉证据,未经监督微调的普通模型也表现出不稳定的视觉上下文敏感性。监督微调(SFT)提高了这种可控性并跨领域泛化,激活修补(activation patching)更将视觉-先验权衡定位到所有六种模型的架构特定深度。(iii) 视觉-先验权衡可沿学习到的向量控制。应用该引导向量(steering vector),即使没有意图指令,也能提高对普通模型的可控性。 这些结果共同将瓶颈重新定位:对于我们所研究的粗粒度属性,MLLMs 编码了视觉证据,但无法可靠地控制对其的依赖。
论文精读
TL;DR 多模态大模型虽编码了粗粒度视觉信息,但无法稳定控制对视觉证据的依赖;通过激活操控可有效提升这种可控性。
问题
问题背景
多模态大模型(MLLMs)依靠视觉输入与预训练语言先验的融合取得了强大性能,但在视觉为中心的许多任务中,当视觉证据与语言先验冲突时模型常常失败,这类“看见 vs 知道”矛盾成为可靠部署的核心疑问。
现有方法局限
以往工作大多单独评测模型视觉问答的准确率,或通过探针(probing)验证视觉信息是否已被编码,缺少一个统一框架来系统区分失败根源:是感知阶段视觉特征退化,还是后感知阶段无法有效利用视觉信息?同时,现有研究很少探究模型在明确指令下能否灵活切换对视觉证据与语言先验的依赖,即视觉上下文敏感性(visual context sensitivity)的可控性。此外,关于模型内部哪一层发生这种权衡、如何通过干预来调控,尚缺少细粒度分析。
为什么这个问题难/重要
MLLMs 内部机制高度黑箱,视觉与语言信息的融合深度因架构而异,导致难以定位瓶颈。但在高风险应用中(如医学影像、工业检测),模型若被统计先验误导而忽略视觉反例,可能引发严重后果。因此,揭示并调控模型在视觉与语言先验之间的取舍——将失败从“看不见”重新定位为“无法可靠控制依赖”——对于提升 MLLMs 的可信赖性与可控性至关重要,也直击当前业界对可靠 AI 的普遍关切。
行业类比
就像自动驾驶系统不能默认为“车道线都清晰可见”而忽略传感器返回的遮挡画面,MLLMs 也必须在视觉证据与统计捷径冲突时,学会可靠地信任视觉。
核心洞察
- **粗粒度视觉属性失败并非感知退化,而是感知后利用的控制缺陷。** 图像重建实验证明,冻结 MLLM 的最终层图像 token 中仍保有颜色、计数等粗粒度信息,这与以往假设视觉编码受损的观点相反。实际瓶颈在于模型无法可靠地决定何时信任视觉证据而非语言先验,这提示优化方向应从增强视觉编码器转向改进跨模态推理与决策机制。
- **通过低秩激活操控即可在不加显式指令的情况下调节视觉依赖程度。** 研究发现,沿学习到的 steering vector 调整特定层的激活,能够比仅靠提示词更稳定地控制模型遵循视觉或先验。这不同于常规 SFT 或 prompt engineering,它为工程部署提供了轻量级、可插拔的模型行为干预手段,且在不同领域间泛化良好。
方法
输入与任务设计
该方法从两个诊断范式出发:(1) 图像重建探测:从冻结 MLLM 最后一层图像 token 重建视觉属性;(2) 多模态上下文敏感性测量:在语言先验与视觉证据冲突时,评估模型遵循视觉上下文的程度。为此,构建了 WhatIfVis 反事实基准,覆盖空间-时间、颜色、计数、尺寸、重量五个粗粒度维度,每个问题均可从图像或先验给出答案。输入包括图像与自然语言问题,同时通过意图指令(如“仅依据图像回答”)操控模型行为。
关键模块
- 视觉证据保留验证:使用轻量重建器(线性投影或解码器)将冻结 MLLM 的图像 token 映射回像素空间,定量评估重建图像中目标属性的保留率。若属性可重建,则编码成功,失败源于后感知利用。
- 上下文敏感性基准与模型行为分析:在 WhatIfVis 上,对基础模型(未经指令微调)和 SFT 模型进行测试。基础模型对视觉证据的敏感性不稳定;通过在 WhatIfVis 上进行监督微调 (SFT),模型能学习遵循提示中的意图,且泛化至其他领域。
- 重要层定位:采用激活修补 (activation patching),在给定意图指令(“使用/忽略视觉”)时,将中间层激活替换为相反指令的激活,观察输出变化,从而定位“视觉 vs 先验”权衡的关键层。实验表明,该权衡集中在架构特定深度,且跨六个模型一致。
- 可控子空间与 steering 向量:发现模型对视觉证据的依赖程度可沿一个学习到的向量连续调整。通过训练一个低维 steering vector(在意图条件激活的差异空间中),无需显式指令即可控制视觉敏感性,增强基础模型的可控性。
输出与启示
该方法输出:(1) 视觉属性重建精度;(2) 各模型在不同意图下的视觉上下文敏感性分数;(3) 关键层热图;(4) steering 后的可控性提升指标。与单纯分析视觉编码质量或依赖固定提示工程的工作不同,本研究将瓶颈定位于后感知的可控性不足,并通过激活修补与 steering 证明了可通过低维干预修复,为提升 MLLM 视觉忠诚度提供了可操作性强的工程路径。
实验
实验设计
作者构建了 WhatIfVis 反事实基准,覆盖 空间时间、颜色、计数、尺寸、重量 五个粗粒度维度。每个问题均包含相互矛盾的视觉证据与语言先验,强制模型在“看到”和“知道”之间抉择。实验分为三个阶段:
- 视觉编码可用性探测:从冻结 MLLM 的末层图像 token 重构粗粒度属性,验证视觉信息是否被保留。
- 上下文敏感性测量:给定显式指令(“请只依据图像回答”或“请忽略图像”),评估模型遵循视觉上下文的程度。对比 普通模型 与经 WhatIfVis 监督微调 (SFT) 的版本,并用 激活修补 定位关键层。
- 引导向量的可控性:在激活空间学习一个方向,通过加减该向量直接调整模型倾向于视觉或先验,无需任何意图指令。
关键发现
- 瓶颈后置:即使未微调的 MLLM 也能从末层图像 token 准确重构属性,说明视觉编码完好;失败源于 感知后利用阶段 而非视觉编码退化。
- 可控性差异:普通模型对“使用图像/忽略图像”指令响应不稳定;SFT 后不仅能显著提升指令遵循度,还展现出 跨域泛化(在未见过的维度上也更可控)。
- 架构定位:激活修补揭示,所有六款测试模型中,视觉-先验权衡集中于 架构特定的中间层,而非均匀分布。
- 低秩操控:学得的引导向量可在无任何提示词的情况下连续调节依赖偏好,其效果与显式指令相当,证明模态偏好被编码在一个 低维子空间 中。
与基线对比及深度解读
普通模型 (no SFT) 作为基线,其行为类似 “知道但看不见”——尽管视觉信息已编码,却无法有意识地遵循。这一缺陷与传统观点(视觉接地不足)不同,揭示出 元认知控制 的缺失。SFT 带来的改善不只来自拟合特定维度,更来自模型学会了分辨何时信任视觉,这解释了其跨维度泛化。
相对于仅提升视觉编码精度的思路,本工作指出:提升 MLLM 视觉可信度的关键可能在于 增加可控性,而非更强的感知器。引导向量的存在进一步提示,这类控制器能以极轻量方式外挂,可能成为工程实践中的有效干预手段。
行业影响
落地场景
多模态大模型(MLLM)在视觉问答、内容审核、商品信息提取等场景中常面临视觉证据与语言先验冲突的瓶颈。该研究揭示的 视觉上下文敏感性(visual context sensitivity) 问题直接影响任何依赖精确视觉判断的产品:
- 电商与内容平台:商品属性校验(颜色、尺寸、计数)、用户生成内容违规检测(血腥、暴力场景识别)中,模型可能被高频共现的文本先验误导,忽略图像实际信息。
- 自动驾驶与工业质检:交通标志或缺陷检测若依赖 MLLM 做解释时,需确保视觉输入优先级高于统计语言偏差,避免因罕见场景导致错误决策。
- 医疗影像辅助诊断:影像报告生成需严格以像素证据为准,否则可能引入训练数据中的虚假关联,造成漏诊或误诊。
商业价值
- 降本:通过监督微调(SFT)或激活操控向量(steering vector) 提升模型对视觉指令的服从度,可大幅减少人工二次校验成本。论文表明 SFT 后可控性显著提升且跨领域泛化,有限的标注数据即可修正行为。
- 增收与体验提升:在电商搜索、推荐理由生成中,更可靠的视觉对齐能减少“图文不符”投诉,提升转化率;内容审核中降低误删或漏放,维持社区生态健康。
- 风险控制:对于金融单据识别、合同关键信息提取等任务,强化视觉上下文敏感性可规避法律合规风险。
与现有产品/工作流的接口
- 即插即用的后期干预:无需重训基础模型,可直接在推理时对指定层应用学到的操控向量(steering vector),在视觉依赖和先验依赖之间连续调节。这适合轻量集成到现有 MLLM 推理 pipeline(如 vLLM/TGI 等框架)。
- 微调策略标准化:提出 WhatIfVis 基准 可作为模型选型或微调验收的标准测试集,帮助评估 MLLM 的视觉可靠性。微调仅需构造“使用视觉/忽略视觉”的指令数据,可复用现有 SFT 流程。
- 模型定位工具:激活修补(activation patching)分析出跨多种架构的关键层深度,为硬件优化、推理加速时的 layer-wise 剪枝或量化提供决策依据,避免损伤视觉控制能力。
具体落地用例
- 电商商品详情页自动生成:MLLM 需从商品图片中提取颜色、尺寸、数量等属性,但训练语料中的先验(如“苹果通常是红色”)可能覆盖实际图片中的绿色苹果。利用 steering vector 增强视觉遵从度后,可生成更准确的描述,减少退货率。
- 全球性社交媒体内容审核:当图片包含争议性符号但上下文文本无害时,模型需严格依据图片内容而非语言先验做出判断。通过 SFT 或向量操控,可动态调整审核松紧度,应对不同地区的合规要求,同时保持低误报率。
局限
- 论文仅考察了**粗粒度属性**(如颜色、计数、大小),对于细粒度视觉细节(如纹理、小目标识别)MLLMs 的视觉编码可能本身就存在衰减,因此结论的普适性受限。此外,**WhatIfVis** 是一个合成基准,问题形式简化,其视觉-语言冲突场景不能完全模拟真实世界的复杂分布,评测结果可能偏乐观。
- 图像重建实验仅在冻结的 MLLMs 上进行,未验证模型微调后视觉表示的 fidelity 变化,无法判断 visual instruction tuning 是否进一步改善了视觉编码。**操控向量**的学习依赖有监督的对比指令,跨任务、跨数据分布的泛化能力尚不明确,实际部署时可能需要重新收集数据。
- 研究聚焦于解码阶段的**利用瓶颈**,即模型“看到但不用”的问题,但未深入探讨视觉编码器本身的缺陷(例如早期视觉处理中的信息丢失或视觉 token 压缩带来的量化误差)。这对于完整定位 MLLMs 的视觉短板仍然是一个缺失环节。