INTACT: 无搜索世界模型的同构意图到动作学习
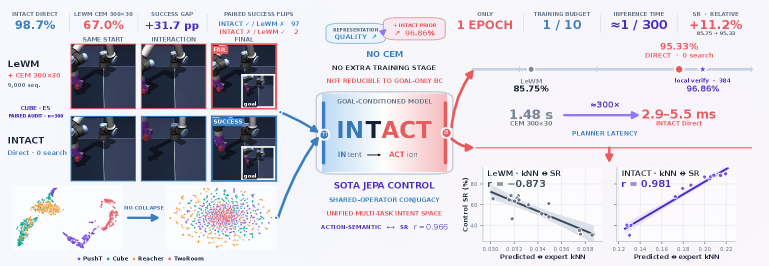
前向潜在世界模型预测动作如何改变场景,但仅能通过昂贵的测试时搜索为期望变化恢复动作。我们提出 INTACT(INtent-TO-ACTion),一个端到端 JEPA,将动作标注、无奖励的轨迹转化为可部署的意图到动作接口。 每个转移提供物理意图 z{t+1}-zt,未来目标提供部署意图 sg(zg)-zt。架构在局部与目标运动意图主干输入图之间同构,采用相同的四槽语法与共享参数,并通过同一预测器诱导的动作律语义(而非逐点潜在相等性)支持局部与目标运动意图族。INTACT 还提供从 RGB 证据到动作有效潜在意图坐标、以及从意图族到对应动作律族的完整迁移。不对称端点梯度固定物理后继并以未来目标为锚点,将表示学习与控制结合,无需逐点潜在匹配或全局线性动态。 所得坐标支持鲁棒的分布动作律:条件均值直接作为无搜索策略,采样仍可用于多样性或可选验证。在四个官方 LeWM 任务上,单轮零搜索模型达到 85.78%、100.00%、97.67%、97.89% 的成功率。以 Direct 计划为中心的可选局部 CEM 达到 96.86% 宏成功率,使用 384 个候选序列(而非 9,000 个),采样量减少 23.44 倍,并较纯 CEM 提升 16.00 个百分点。一个共享四任务编码器达到 89.39% E5 Direct 宏成功率,并在每项任务上优于联合训练的 LeWM;预测-专家动作族 kNN 以 r=0.954 跟踪 Direct 成功率。直接推理仅需 2.9–5.5 ms。
论文精读
TL;DR INTACT 通过同构意图-动作学习将世界模型转化为搜索免费的端到端策略,在四个机器人任务上以零搜索达到 85%–100% 成功率,直接推理仅需 2.9–5.5 ms。
问题
问题背景
在基于模型的强化学习中,世界模型通过学习环境动态来规划动作,但主流范式依赖前向预测——从当前状态与动作预测下一状态。当需要实现特定意图(如达到目标状态)时,必须通过昂贵的在线搜索(如 CEM、MPC)反向求解动作序列,这严重限制了实时性。
现有方法局限
- 逆动力学模型 直接学习从状态对到动作的映射,但要求状态-动作对充分覆盖,且难以处理动作多模态,泛化性弱。
- 潜在空间规划(如 Dreamer 系列)虽然在隐空间优化,每次决策仍需数百至上千次模型前传,无法满足低延迟需求。
- 度量学习或对比方法 试图学习动作不变表征,但常隐含全局线性假设或点对点约束(如欧氏距离匹配),无法捕获复杂非线性动力学。
- 这些方法普遍将表示学习与控制目标分离,导致学到的表征不能直接用作搜索-free 的策略,需额外对齐或微调。
为什么这个问题难/重要
- 技术挑战:动作多模态(同一状态变化可由不同动作序列实现)、高维视觉输入下的紧凑表示,以及部分可观测性,使得从意图(期望状态变化)到动作的映射高度非线性。模型必须理解动作语义,而非仅记忆状态关联。
- 工程价值:机器人操作、自动驾驶等场景要求毫秒级响应。INTACT 论文显示其 Direct 推理仅需 2.9-5.5 ms,而传统搜索方法需评估数千候选序列,功耗与延迟均不可接受。因此,搜索-free 的世界模型控制是迈向实用具身智能的关键一步。
行业类比
这与端到端自动驾驶绕过显式轨迹规划与搜索,直接从传感器数据输出控制指令类似,通过预构建的意图-动作映射极大降低计算延迟与系统复杂度。
核心洞察
- - **同构意图-动作学习**:INTACT 通过同构架构统一局部和全局意图处理,使模型可以从不同粒度的意图中学习一致的动作映射。与典型世界模型分别训练编码器和策略、或依赖前向搜索不同,INTACT 将局部变化意图和全局目标意图置于相同的输入图语法和共享参数中,预测器在两种意图之间同构,从而消除了测试时搜索的必要性,并实现了动作定律的跨尺度一致性。
- - **无搜索分布控制**:INTACT 学习分布动作定律,其条件均值可直接作为确定性策略,无需规划。传统世界模型常依赖 CEM 等搜索上千个候选序列,而 INTACT 仅需单次前向传播即可输出动作,推理时间降至 2.9--5.5 ms,且保留分布采样能力,兼顾多样性与确定性,为实时控制提供高效接口。
- - **无奖励联合学习范式**:INTACT 通过非对称端点梯度(固定未来目标锚点,梯度流入物理后继)联合优化表示和动作定律,无需奖励信号或潜在点匹配。相比基于互信息或对比学习的方法,这种简洁的监督设计学习到结构良好的意图坐标和鲁棒的分布动作律,为无奖励环境下的端到端世界模型训练提供了新思路。
方法
输入与目标
INTACT 的输入是无奖励的轨迹数据:原始 RGB 观测及对应动作序列,无需任何显式奖励信号。目标是将这些数据转化为一个可直接部署的 意图到动作(intent-to-action) 接口,消除前向世界模型所需的昂贵在线搜索。
核心模块:同构意图学习
意图坐标定义
模型在潜变量空间定义两类意图:
- 物理意图
z_{t+1} - z_t:局部运动变化,来自相邻状态。 - 部署意图
sg(z_g) - z_t:指向未来目标状态z_g的运动方向。
同构预测器
架构在局部和目标意图之间保持 严格同构:
- 使用相同的 四槽语法(四个输入槽位)处理两类意图,共享全部参数。
- 不要求逐点潜变量相等,而是通过同一个预测器诱导出 动作律语义(action-law semantics),使得不同意图族共享一致的动作映射。
- 这保证了从 RGB 证据到有效潜意图坐标,以及从意图族到对应动作律族的 完整性迁移。
非对称端点梯度
训练采用 非对称端点梯度:目标意图的终点(未来状态)被固定为锚点,仅对物理后继施加梯度,让表示学习与控制目标自然统一,无需为对齐潜空间而做点对点回归或强制全局线性动力学。
输出与推理
模型学习到 分布式动作律:对给定意图,输出动作的条件分布。其条件均值直接作为 搜索自由策略(Direct plan),推理耗时仅 2.9–5.5 ms。若需多样性或验证,也可从分布中采样(如配合 CEM)。
与同类方法的差异
不同于 LeWM 等需要大量测试时采样的前向世界模型,INTACT 通过同构意图学习直接建立从意图到动作的映射,训练一回合即达到 85.78%–100% 成功率,且一个共享编码器可同时服务多个任务。
实验
实验设计
在 四个官方 LeWM 任务 上评估 INTACT,采用 单任务 与 多任务 两种协议。利用无奖励的 action-labeled 轨迹进行端到端 JEPA 训练,直接构建 意图→行动 接口:给定当前状态与未来目标,直接输出行动,无需测试时搜索。可选地,将直接计划作为 局部 CEM 的中心以进行验证。评估指标包括成功率、采样效率、与专家动作的相关性及推理延迟。
关键发现
- 仅 一个 epoch 训练,零搜索模型即可在四任务上分别达到 85.78%、100.00%、97.67%、97.89% 的成功率,表明搜索已非必需。
- 以直接计划为中心的局部 CEM 将 宏成功率提升至 96.86%,且仅需 384 条 候选序列(原 CEM 需 9000 条),采样减少 23.44 倍,同时比纯 CEM 高出 16.00 个百分点。
- 多任务共享编码器达到 89.39% E5 Direct 宏成功率,并在 所有任务上超越 联合训练的 LeWM。
- 预测-专家动作族 kNN 跟踪 Direct 成功率的相关系数达 r=0.954,证实学习到的动作律与专家行为高度吻合。
- 推理仅需 2.9–5.5 毫秒,满足实时控制需求。
与基线对比的深度解读
相比于 LeWM,INTACT 通过端到端的意图坐标与同构预测器,从根本上消除了测试时搜索的开销,零搜索性能大幅领先。即便引入搜索,INTACT 的 CEM 变体仍以更少的采样实现更高成功率,证明其潜在表示与分布式动作律具有更高的决策效率。多任务实验中,共享编码器不仅未造成负迁移,反而使各任务性能全面提升,突显了意图坐标的泛化潜力。此外,分布式动作律的 均值可直接作为策略(无搜索),而采样分支则保留多样性,统一了控制中的确定性执行与随机验证两种范式。
行业影响
落地场景
INTACT 学习到的意图–动作映射可直接部署于需要快速反应与低计算开销的物理交互场景:
- 机器人操控:机械臂抓取、铰链物体操作、移动机器人导航,环境变化时无需重新搜索即可执行目标达成动作。
- 自动驾驶:端到端规划模块中,将自车意图(目标位姿、变道)直接映射为方向盘、油门、刹车指令,省去在线求解优化问题的步骤。
- 游戏 AI/NPC 控制:在开放世界游戏中,根据任务目标实时生成角色动作,大幅降低策略网络的推理延迟。
- 工业自动化:多任务产线中,一个共享编码器同时处理分拣、装配、包装等多种技能,快速切换任务,减少重训练成本。
商业价值
- 降本:消除测试时搜索(如 CEM、MPPI)使得部署推理仅需 3–5 ms,边缘设备(如嵌入式控制器、低算力工控机)即可运行,硬件成本降低;单次任务无需大量候选序列采样,采样量减少 23 倍,能耗与计算资源开销显著下降。
- 增效:零搜索策略使机器人对动态目标的响应速度达到毫秒级,提升产线节拍与自动驾驶的安全冗余;多任务共享编码器泛化至新任务时仅需少量微调,模型研发周期缩短。
- 体验提升:消费级机器人可更平滑地理解用户意图并执行自然动作,交互延迟降低,用户满意度提高;游戏 NPC 行为更智能且不破坏帧率。
与现有产品/工作流的接口
INTACT 以无需在线搜索的特性,可集成进现有端侧推理栈:
- 作为现有世界模型(如 Dreamer、TD-MPC)的意图接口插件,替换掉原有的规划器,仅保留编码器–预测器–Actor 管线。
- 与机器人中间件(ROS 2)结合,接收目标位姿或图像级目标,输出关节速度或末端执行器指令,通过标准 Action/Goal 消息类型对接。
- 对于已部署的模仿学习或强化学习策略,可用 INTACT 的意图坐标做特征增强,改善策略的目标条件化表示,无需改动底层控制接口。
具体用例:
- 仓储物流机器人:在一个动态分拣场景中,传送带上物体位置不断变化,INTACT 接收视觉目标(如“抓取红色包裹”),直接生成完整动作轨迹,无需每次重规划。共享编码器可同时处理抓取、推扫、放置三种技能,模型统一部署在 Jetson 边缘设备上,单个推理 4 ms。
- 仿真与数字孪生中的自动场景生成:游戏引擎或工业仿真器中,根据高层指令(如“将箱子从 A 货架移到 B 货架”)直接生成角色动画,省去花费数秒的路径搜索,支持大批量场景并行生成,用于模型训练数据扩增与产线虚拟调试。
局限
- 实验仅使用了三个随机种子,论文承认“Three seeds remain a coarse scaling estimate”,这限制了统计结论的可靠性,难以评估性能的方差与泛化稳定性。尤其在多任务和迁移场景下,少种子可能导致对方法鲁棒性的过高或过低估计,需要更大规模的种子实验来确认结论。
- 动作商(action quotient)仅在演示数据的支持范围内被识别,论文指出“The action quotient is identified only on demonstrated support”。这意味着当遇到与训练分布显著不同的状态或意图时,模型可能无法提供可靠的动作映射,限制了方法在开放环境或更广泛操作空间中的直接推广。
- 直接采用高斯分布建模动作输出虽然简单高效,但论文承认“Direct Gaussian control can hide multimodality”,即当真实动作分布为多模态时,高斯假设会丢失多样性,导致次优行为。对于存在多个可行方案的复杂任务,该方法可能需要更复杂的分布或采样策略,否则性能受限。