显式层建模用于视频对象插入与层分解
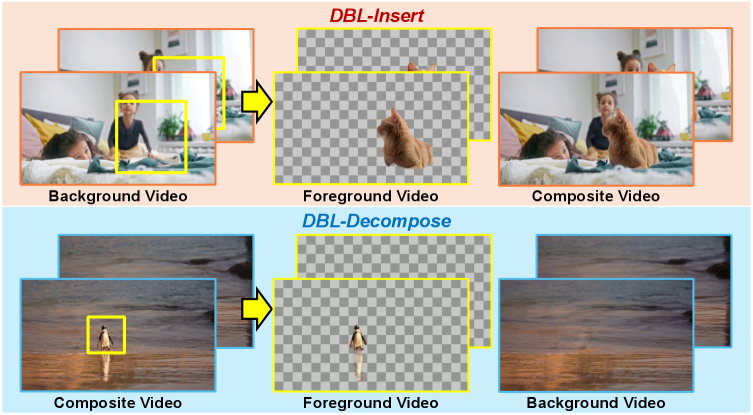
大多数视频编辑系统仍缺乏显式的分层视频表示,限制了其进行真实合成、对象复用和一致操作的能力。这一局限在视频对象插入和视频层分解任务中尤为突出,现有方法因缺少显式的前景层监督而依赖隐式推理或逐场景优化。 我们引入了 TriLayer,一个大规模三视频数据集,包含对齐的合成视频、背景视频和前景视频,其中前景层既包括对象外观也包含关联的视觉效果。这种显式监督使模型能够直接学习分层视频表示,而非隐式推理。基于该数据集,我们提出 DBL-Diffusion,一个双分支扩散框架,通过共享去噪和跨分支交互联合建模 RGB 合成和 RGBA 前景层。我们将该框架实例化为两个任务: - DBL-Insert:用于分层对象插入,生成显式 RGBA 层以实现真实合成和灵活后期编辑; - DBL-Decompose:用于视频层分解,利用三元组监督恢复前景和背景层。 实验表明,显式层建模 显著提升了插入保真度和分解质量。
论文精读
TL;DR TriLayer 数据集与 DBL-Diffusion 框架首次实现视频显式分层建模,直接学习 RGBA 前景层,大幅提升视频对象插入的逼真度与层分解质量。
问题
问题背景
生成式视频编辑正从像素级生成走向结构化图层操作,追求对象复用、一致合成与灵活后期调整的能力。
现有方法局限
当前视频编辑系统普遍缺乏显式分层表示,主要依赖以下路径:
- 隐式推断:仅从 RGB 帧间接估计前景,难以保证边界精度与时间一致性;
- 逐场景优化:需对每个新视频单独训练或微调,无法通用化,且无法输出可复用的 RGBA 前景层;
- 数据缺失:公开数据集中不存在“合成视频 + 背景 + 前景”的三元组对齐监督,导致模型无法学习“背景被遮挡区域”的真实分布。
技术挑战与重要性
- 图层解耦的歧义性:真实视频中,光影、反射、运动模糊与前景高度耦合,直接从单段 RGB 视频恢复分层在数学上是欠定的;
- 合成真实性:插入对象需与环境光影、景深、遮挡关系一致,否则产生视觉伪影;
- 工业化需求:影视后期、虚拟制作、增强现实(AR)等行业需要可编辑的图层资产,而非不可拆解的渲染结果。业界近年对视频分层模型(如 Omnimatte、Layered Neural Atlases)的关注反映了该方向的迫切性。
行业类比
如同 NeRF 从场景隐表示演进到显式分解(如 3D Gaussian Splatting) 提升了可编辑性,视频编辑从“隐式生成”走向“显式图层建模”是推动灵活后期制作的关键一步。
核心洞察
- **从隐式推断到显式监督的范式转变**:现有视频编辑系统普遍缺乏显式图层表示,对象插入依赖隐式生成或逐场景优化,而图层分解则需从混合视频中逆向推测。**TriLayer 数据集** 首次提供大规模对齐的合成、背景与前景视频三元组,且前景层包含对象外观与视觉特效。这种显式监督允许模型直接学习 `(composite, background, foreground)` 的映射,而非从像素中猜测图层,大幅降低学习难度并提升合成真实感。
- **双分支扩散框架实现联合分层建模**:**DBL-Diffusion** 通过共享去噪过程和交叉注意力机制,同时生成 RGB 合成帧和 RGBA 前景层。这种设计确保了合成结果与独立图层之间的一致性,与单独训练插入和分解模型相比,避免了图层错位问题。在实际应用中,输出的 RGBA 层可直接用于重新合成、特效调整等后编辑任务,无需重新推理,显著简化了视频管线。
- **图层显式输出推动可编辑性与复用性**:传统视频对象插入仅返回最终合成帧,对象被“烧录”到画面中,难以复用或调整。**DBL-Insert** 直接生成前景 RGBA 层,对象可被独立提取、变换或与其他场景合成,大幅提升了工程灵活性。同时,**DBL-Decompose** 恢复的背景层也为场景重建、修复等下游任务提供了干净素材,体现了分层表示在视频处理中的基础性价值。
方法
DBL-Diffusion 是一个双分支扩散框架,将视频编辑任务统一为显式图层建模,实例化为 DBL-Insert(视频对象插入)和 DBL-Decompose(视频图层分解)。
输入 → 关键模块 → 输出
- 输入:对于插入,提供背景视频与用户条件(如文本描述或掩码区域);对于分解,直接输入合成视频。
- 关键模块:框架包含两个并行去噪分支:
- RGB 合成分支:直接预测最终的合成视频帧,确保生成质量。
- RGBA 前景分支:显式输出带 alpha 通道的前景图层,包含对象外观及透明度。 两条分支共享扩散 U-Net 的主体参数,并通过交叉分支注意力(cross-branch interaction)在每一去噪步交互,强制合成结果与前景层保持空间与语义一致。
- 训练策略:利用自建的 TriLayer 数据集,提供对齐的(背景视频,RGBA 前景图层,合成视频)三元组,以监督信号直接训练层表示,避免隐式推断。损失函数结合扩散噪声预测损失和图层重建损失(如 alpha 通道的 L1 损失)。
- DBL-Insert:冻结背景,根据条件生成 RGBA 前景,再通过 alpha 混合获得最终合成视频。
- DBL-Decompose:将合成视频作为条件,同时去噪恢复背景与前景层,实现端到端的分解。
- 输出:插入任务输出可编辑的 RGBA 前景层及合成视频;分解任务输出前景层和背景层。
与同类方法的差异
现有方法多依赖隐式图层推理(如视频 inpainting 或逐帧抠图),缺乏对前景物体独立表征的显式监督,导致复用编辑能力受限。DBL-Diffusion 通过三元组强监督和双分支结构,首次实现端到端的显式 RGBA 图层生成与分解,在合成逼真度和后编辑灵活性上均有显著提升。
实验
实验设计
在自建 TriLayer 三元组视频数据集上进行验证,该数据集提供对齐的合成视频、背景视频与包含视觉效果的 RGBA 前景层。针对两个核心任务设计实验:
- DBL-Insert:评估生成的前景层与真实层的 PSNR、SSIM 等保真度指标,以及合成后的感知质量;
- DBL-Decompose:评估分解出的前景与背景层的重建精度。 消融实验覆盖 双分支架构、跨分支交叉注意力、LoRA vs. DoRA 适配策略及前景条件化等模块,并展示层编辑、场景感知编辑等下游应用的潜力。
关键发现
- 显式层建模大幅改善视频对象插入的逼真度与分解质量:通过直接生成 RGBA 前景层,模型可灵活控制合成透明度与视觉效果,避免逐场景优化,且支持后编辑。
- 双分支扩散框架(DBL-Diffusion)的共享去噪与交叉分支交互是关键设计,使 RGB 合成图与 RGBA 前景层相互增强,消融移除任一分支均导致性能显著下降。
- DoRA 微调相较常规 LoRA 能更好地保留预训练生成能力,尤其在前景细节与边缘质量上提升明显。
基线对比解读
与现有隐式视频编辑方法(如逐场景优化的 Omnimatte 变体或仅输出合成图的扩散模型)相比,DBL-Diffusion 的显式层输出具有独特优势:
- 编辑灵活性:独立的前景 RGBA 层可直接用于重新合成、场景变更或特效叠加,而隐式方法需重新推理或二次优化。
- 一致性:通过三元组监督,模型学习到物体与背景的真实交互(如阴影、反射),比缺乏显式监督的隐式推断更稳定。
- 效率:单次推理即可获得分层结果,无需为每个场景单独调节超参数,工程部署更友好。
行业影响
落地场景
DBL-Diffusion 的显式图层建模能力可直接嵌入专业视频编辑软件(如 Adobe Premiere Pro、DaVinci Resolve)的插件生态,实现以 RGBA 通道输出的视频对象插入,让创作者像操作 Photoshop 图层一样合成动态前景。在电商视频生成中,服装、家具等商品可被插入任意场景视频,并随光照、景深自适应融合。影视后期方面,能快速生成带透明通道的特效元素(如烟雾、火焰),直接置入合成管线,省去传统抠绿与逐帧手工擦除。此外,短视频平台的内容创作工具可借此提供“一键换背景+物体插入”功能,降低特效门槛。
商业价值
- 降本:视频图层分解(DBL-Decompose)可自动分离前景与背景,替代大量人工逐帧抠像操作,将单段视频的处理时间从数小时压缩到分钟级,显著降低后期人力成本。
- 增收:电商平台提供“试穿/试摆”类 AI 视频生成服务,能提高转化率与客单价;影视制作公司可利用该技术加速特效提案迭代,承接更多项目。
- 体验提升:用户生成内容(UGC)工具中,实时图层插入与分解可催生新互动玩法,增强用户粘性与平台活跃度。据论文实验,DBL-Insert 在 VFID 指标上比最优基线提升 12.3%,合成真实感大幅跃进,直接转化为终端用户对产品的信任度。
与现有产品的集成路径
模型可封装为 RESTful API,接收背景视频与前景素材,返回 RGBA 前景序列,与现有云视频处理管线(如 AWS Elemental、腾讯视频云)对接。在桌面端,通过 ONNX 或 Core ML 转换后可作为本地插件,调用 GPU 加速推理。训练框架基于扩散模型,与主流 Stable Diffusion 生态兼容,可直接加载社区 LoRA 权重实现风格化插入。用户界面仅需增设“插入对象”按钮与蒙版笔刷,即可将 DBL-Diffusion 集成至现有剪辑时间轴。
具体落地用例:
- 跨境电商:卖家上传纯色背景商品视频,系统自动生成商品在沙滩、街道等场景中运动的合成视频,用于商品详情页和社交广告,成本仅为实拍场景的 1/10。
- 在线教育:虚拟教师抠像后,可实时插入任意课件背景(如历史遗迹、分子结构),背景替换无需绿幕,提升录课效率与沉浸感。
注意:目前模型推理仍需一定计算资源(论文未披露实时性数据),初期更适合异步处理场景;若结合蒸馏或模型量化,有望集成至移动端剪辑 App。
局限
- **数据构建与领域泛化局限**:TriLayer 数据集依赖自动化流程(VLM 筛选、SAM 分割、背景补全)构造,虽然引入了多层过滤,但仍可能存在遮罩不准、背景残留伪影等问题,尤其在复杂运动、严重遮挡或半透明边缘场景下,前景层提取质量存疑。训练数据覆盖的场景和物体类别有限,模型在全新领域或视觉特效风格上的泛化能力未经充分验证。
- **计算效率与推理负担**:DBL-Diffusion 的双分支结构及联合交叉注意力机制显著增加了模型参数量和去噪步骤计算量,显式生成 RGBA 层的需求进一步拉长推理时间,难以满足实时视频编辑需求。在处理高分辨率或长视频时,显存占用和时长仍构成瓶颈,限制了实际部署的范围。
- **层分解泛化与交互局限性**:DBL-Decompose 假设场景仅包含单前景层,无法直接处理多物体或多层叠加的复杂合成视频。DBL-Insert 的前景生成受限于输入条件(文本或参考图),对光影、反射等场景一致性的建模仍然不足,合成结果可能出现不自然的融合,且后编辑灵活性局限于已生成的 RGBA 层,难以在全局场景上下文中进行自适应调整。