CoRT: 用于令牌级评分准则引导策略优化的反事实回放
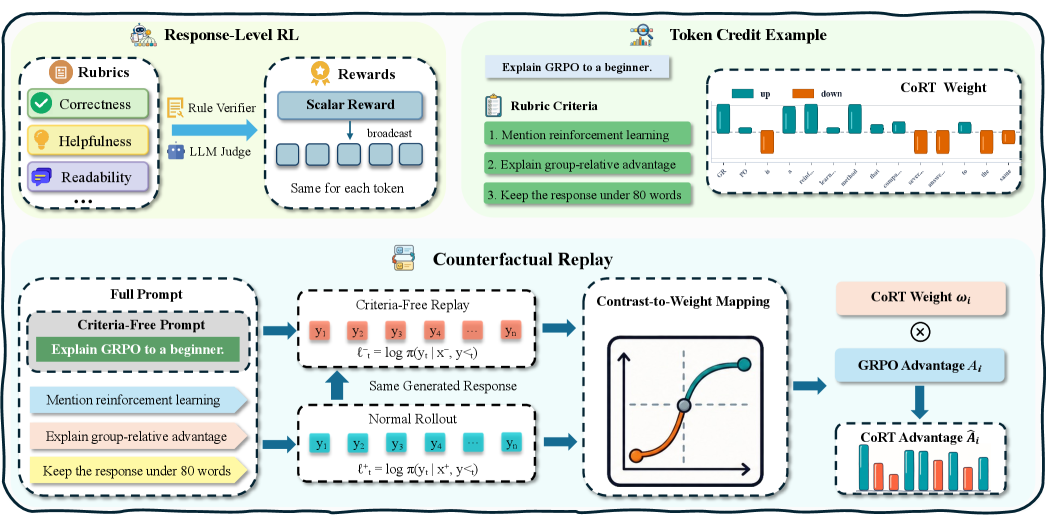
基于评分准则的强化学习(Rubric-based RL)通过对照显式标准评估模型输出,丰富语言模型训练。然而,在 GRPO 风格流程中,这些结构化判断被简化为标量响应级奖励,并转换为所有生成令牌均匀广播的响应级优势,缺乏在响应内分配信用的显式机制,即使不同准则对应不同片段、格式决策或语义选择。 我们提出 CoRT,一种用于评分准则条件 GRPO 的令牌级信用加权方法。CoRT 无需训练辅助令牌评分模型,而是使用 反事实回放(Counterfactual Replay)对同一采样响应,在原始准则条件提示与匹配的无准则提示下重新评分。由此产生的令牌级对数似然对比可作为对准则上下文依赖性的代理。CoRT 将这些对比映射到有界、响应归一化的权重,并用于将带符号的 GRPO 优势重新分配到各令牌,无需引入辅助评分器或改变响应级奖励。 实验覆盖指令微调模型和多种奖励粒度,结果显示 CoRT 在绝大多数比较中优于匹配的响应级 GRPO,平均提升 4.4 个百分点。该方法在避免单独相关性学习阶段的同时,与已学习的令牌级信用基线保持竞争力。这些结果表明,策略内部的反事实似然对比可提供有效的训练信号,用于响应内信用分配,同时保留 GRPO 的简洁性与稳定性。
论文精读
TL;DR CoRT 利用反事实重放产生 token 级似然对比,无需额外模型即可为 GRPO 注入细粒度信用分配,显著提升对准则的遵循能力。
问题
问题背景
基于规则的强化学习(Rubric-based RL)正成为对齐语言模型的重要手段,通过显式评估标准(如准确性、格式、完整性)提供结构化奖励信号。尤其在 GRPO(Group Relative Policy Optimization)等策略优化框架中,模型输出由多维度规则打分,再转化为标量奖励用于策略更新。
现有方法局限
当前 GRPO 流程将规则判定的结构化信息压缩为响应级标量奖励,并计算响应级优势(response-level advantage),再均匀广播至序列中所有 token。这种做法忽略了不同规则往往对应响应的不同部分:例如格式规范可能只与开头/结尾的标记有关,语义正确性针对特定内容片段。缺乏细粒度的 token 级信用分配(credit assignment),导致训练信号粗糙,模型难以精确定位哪些 token 对最终评分贡献更大,从而限制了对齐效率和对复杂指令的遵守能力。部分方法尝试引入辅助 token 评分模型,但需要额外的训练阶段和数据,增加了工程复杂度。
为何困难与重要
细粒度信用分配是 RL 领域的经典难题,在语言模型中尤甚,因为 token 之间高度耦合,且显式标注 token 级相关性成本极高。工业界对 RLHF(基于人类反馈的强化学习)的依赖日益加深,而高效利用多维规则反馈直接关系到模型在真实场景中遵循复杂指令的表现。忽视 token 级差异会导致训练不稳定、奖励信号浪费,甚至误导模型关注无关 token。因此,无需额外模型即可实现 token 级信用分配成为兼顾性能与工程可行性的关键方向。
行业类比
类似自动驾驶中的多传感器融合:全局决策(如变道)需精细定位各传感器数据(摄像头、雷达)对场景理解的贡献比例,而非简单平均;RL 训练同样需要将整体评分精细归因到每个 token 的决策贡献。
核心洞察
- 反事实回放提供了一种无需辅助模型的 token 级信用分配信号。CoRT 利用策略模型自身在带/无评分标准 prompt 下的对数似然差,作为 token 对评分标准依赖度的代理,避免了训练额外评分器或注意力分析的成本。与需要单独相关性学习阶段的方法相比,该信号直接从策略内部提取,更贴近模型的实际生成机制,且计算开销可控。
- 优势重分配机制在保持 GRPO 稳定性的同时注入细粒度反馈。CoRT 将 token 权重归一化后与 GRPO 响应级优势相乘,不改变总奖励与优势符号。这意味着现有 GRPO 训练流程无需修改超参或奖励函数即可集成,实现简单即插即用。实验中的平均 4.4 个百分点提升表明,该方法在提升性能的同时维持了 GRPO 的工程稳定性。
方法
输入
- 一个包含评分标准(rubric)的提示(prompt)与模型采样生成的响应。
- 一个无标准对照提示(criteria-free prompt),仅保留任务指令,移除所有评分标准。
反事实重放与 token 级权重计算
- 双提示评分:将同一个响应分别送入策略模型,在标准提示和无标准提示下计算每个 token 的对数似然(log-likelihood)。
- 计算对数似然对比:对每个 token,求
log p(token|标准上下文) - log p(token|无标准上下文)。该差值反映该 token 对评分标准的依赖程度:正值表示其在标准提示下更可能出现,与标准强相关。 - 权重映射与响应内归一化:将上述差值通过有界映射(如 sigmoid 或裁剪),并在整个响应上做归一化,得到每个 token 的权重 (w_t)(区间 ([0,1]),满足 (\sum w_t = 1) 或类似约束)。
优势重新分配与策略优化
- 原始 GRPO 为整个响应计算一个标量优势 (A)(基于响应级奖励在组内的相对排序)。
- CoRT 将 (A) 按 token 权重重新分配:token 级优势为 (A \cdot w_t)。与标准强相关的 token 将获得更大部分的优势信号((A>0) 时强化,(A<0) 时抑制),而无关 token 受影响较小。
- 重新分配后的 token 级优势直接用于策略梯度更新,不改变原始响应级奖励。
与同类方法的差异
与需要额外训练 token 评分模型(如学习 token 相关性)的方案不同,CoRT 完全利用策略模型内部的反事实似然对比,无需辅助网络或额外训练阶段,在保持 GRPO 简洁性与稳定性的同时实现细粒度信用分配。
实验
实验设计
实验在多种 指令微调模型(instruction-tuned models)上开展,覆盖不同 奖励粒度(reward granularities)。对比基线包括:
- 响应级 GRPO(response-level GRPO):将标量奖励广播到所有 token,作为 CoRT 的直接消融对象;
- 基于学习的 token 级信用分配方法(learned token-level credit baselines):需要额外训练 token 评分模型。
CoRT 在相同策略优化框架下,仅通过 反事实重播(counterfactual replay)引入 token 级权重,不增加辅助模型,也不修改响应级奖励值。
关键发现
- CoRT 在绝大多数比较中均优于响应级 GRPO,平均提升 4.4 个百分点(percentage points),表明 token 级信用分配对 rubric 条件化训练至关重要。
- 性能与需要独立相关性学习阶段的 learned token-level credit baselines 相当,但 CoRT 完全回避了额外的学习过程,保持了 GRPO 的简洁与稳定。
- 通过 策略内部反事实似然对比(policy-internal counterfactual likelihood contrasts)即可有效捕获 token 对 rubric 准则的依赖程度,无需外部标注或辅助模型。
深度对比解读
CoRT 的核心创新在于用 响应内 log-likelihood 差异 作为信用权重的代理,这是一种极低成本的细粒度信号。相比直接广播标量奖励的响应级 GRPO,CoRT 能将梯度引导至对评价准则重要的 token 区间,从而缓解 信用分配偏置(credit assignment bias)。而与学习型基线相比,CoRT 的优势在于 无额外训练阶段,这在高频迭代或算力敏感场景中尤为重要。实验同时验证了该方法在不同奖励粒度和模型规模下的泛化性,说明反事实回放是一种通用、稳健的 token 级信用分配策略,未来可与多种策略优化目标结合。
行业影响
落地场景
CoRT 适用于任何依赖 Rubric 驱动强化学习(rubric-conditioned RL) 微调大语言模型的业务场景。典型产品包括:
- 电商内容生成:依据多维度评分标准(准确性、卖点覆盖、合规性)自动生成商品描述或营销文案,CoRT 可对生成 token 进行细粒度信用分配,避免关键卖点遗漏。
- 智能客服与合规审核:在金融或医疗等受监管行业,模型输出需满足精确的格式和语义约束,CoRT 能强化关键 token 的对齐,减少不良输出。
- 教育自动评估与反馈:根据评分量规对开放式回答进行打分与建议生成,CoRT 有助于模型聚焦于内容质量相关 token,而非冗余客套话。
商业价值
- 降本增效:CoRT 无需训练辅助 token 评分模型,仅利用策略内部反事实似然对比,节省了单独标注或训练 token 级奖励模型的人力与算力成本。与标准 GRPO 相比,平均性能提升 4.4 个百分点,同等资源下获得更高模型质量。
- 体验提升:通过精准的 token 级信用分配,模型输出更贴合评分标准,减少遗漏或偏差,在内容审核、客服等场景直接提升用户满意度与业务指标(如转化率、合规率)。
- 快速迭代:方法即插即用,保持 GRPO 的简洁与稳定性,降低算法切换风险,适合频繁更新的在线业务。
与现有产品/工作流的接口
CoRT 作为对 GRPO 优势函数 的重分配模块,可无缝嵌入已有 RLHF 训练管线:
- 现有 GRPO 流程中,收集采样响应后,CoRT 使用原始 rubric 提示和无 rubric 提示分别进行反事实重放,计算 token 对数似然差;
- 将差分映射为归一化权重,对优势函数进行 token 级重分配;
- 替换原有统一的 response-level advantage,其余训练步骤(如 KL 惩罚、策略梯度)不变。 无需修改奖励模型或数据标注流程,可直接搭载在主流 RL 训练框架(如 TRL、OpenRLHF)上。
具体落地用例
- 电商平台自动生成商品卖点:某跨境电商平台使用 rubric 定义卖点完整性、语言流畅度和合规性。CoRT 微调后,模型能在生成描述时为卖点关键词(如 “防水”、“两年质保”)分配更高训练信号,避免遗漏,从而提升点击率与转化。
- 内容平台 UGC 质量评估:短视频平台用 rubric 评估内容标签准确性、社区规范符合度。CoRT 强化模型在标签区域和规范表述上的注意力,降低不合规内容误放,减少人工复审成本。
局限
- **criteria-free prompt 构造依赖**:CoRT 需要为每个 rubric-conditioned 提示构造一个语义匹配但不含评分标准的对照提示。这一步骤对改写质量敏感,若改写改变了原始提示的分布或引入额外信息,counterfactual replay 的似然对比将不可靠。对于细粒度、隐式或与任务强耦合的 rubric,构造高质量对照 prompt 可能非常困难,限制了方法在复杂指令或开放式生成任务上的直接适用。
- **早期训练稳定性风险**:counterfactual 似然对比直接取自当前策略的输出,训练初期策略不确定性高时,token 级别的对数似然差异可能噪声较大,导致 credit 权重估计不准确,进而使 advantage 重分配引入错误信号。论文使用调度和归一化策略缓解,但缺少在极端不稳定场景下的深入诊断,该方法在策略剧烈变化时的鲁棒性仍需验证。
- **任务与奖励粒度泛化未充分证明**:实验主要在指令微调模型和简单显式 rubric(如格式、长度)上评估,未覆盖复杂多维度奖励或需要深层语义判断的任务。与学习型 token credit 基线相比,虽然省去了额外训练,但在细粒度信用分配难度高的场景中,无参数的反事实方法可能不如专门训练的评分模型精准,且无法利用外部信号校准,其在通用 RLHF 工作流中的推广能力存疑。