MODUS: Decoder-Only Any-to-Any 多样化模态建模
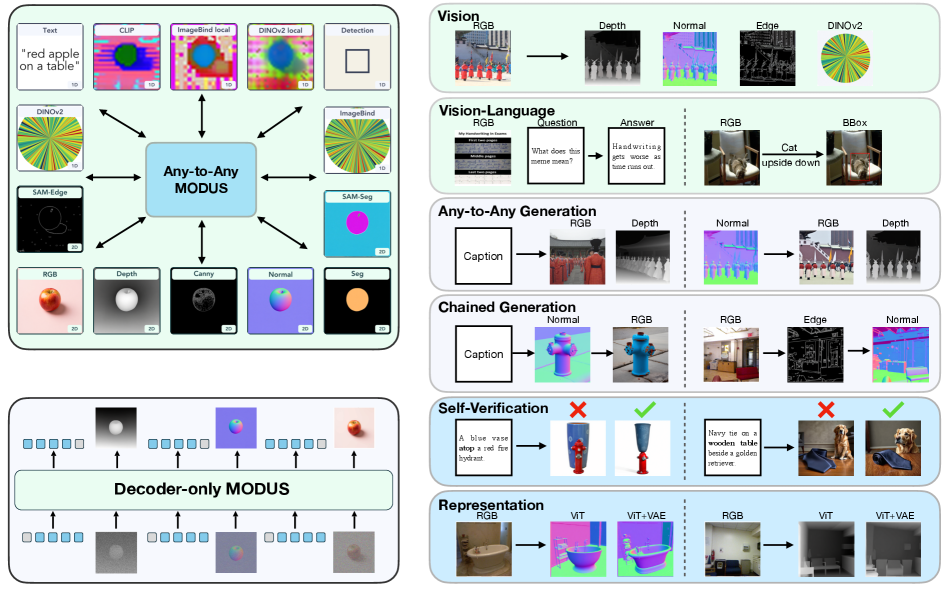
现有 any-to-any 模型通常使用 encoder-decoder 或 diffusion 架构从头训练,这限制了性能且无法利用强大的预训练 decoder-only 模型作为先验。本文研究 decoder-only 的 any-to-any 多模态建模,提出 Modus 模型。该模型对称处理所有模态,无需模态特定头、损失或任务管线,支持任意模态作为输入和输出。 Modus 支持链式生成(通过中间模态)和跨模态自验证(用生成的其他模态对自身输出评分)。实验表明,Modus 在多个基准上表现出色,与专门模型和多任务基线竞争,无需微调即可直接使用。所有材料已开源。
论文精读
TL;DR MODUS 提出首个 decoder-only 的 any-to-any 多模态框架,对称统一所有模态的输入输出,无需特定任务流水线,直接复用预训练大模型先验,性能比肩专家系统。
问题
多模态 any-to-any 建模 已成为视觉、语言乃至科学领域(如生态、天文)灵活感知与生成的核心范式,其目标是让单一模型处理任意模态的组合输入并预测任意模态的输出。
现有方法多采用 encoder-decoder 或 扩散架构,需为不同模态设计专用编码器、解码器或任务头,且通常从头训练,无法利用日益强大的预训练 decoder-only 模型 作为先验。这类架构限制了模态间的对称性与扩展性,每增加一种新模态都要修改网络结构,难以真正实现统一的 any-to-any 推理。
技术上,主要挑战在于如何将异构模态(图像、文本、深度图等)统一为一致的 token 表示,并让同一个 decoder-only 模型既理解生成条件又直接产生目标模态。这需要设计统一的 tokenization 方案、合适的训练目标以及高效的多任务采样策略。一旦突破,模型即可支持 链式生成(通过中间模态逐步推理)和 跨模态自验证(用生成的另一种模态对自身输出评分)等高阶应用,极大简化多模态 AI 系统的工程管线,因此备受业界关注。
类似 GPT 系列在 NLP 任务上的统一生成范式,Modus 希望将这种 decoder-only 的简洁与灵活带入多模态领域,用一个模型覆盖所有生成转换场景。
核心洞察
- 用 Decoder-Only 架构实现真正的 Any-to-Any 对称建模,打破以往 Encoder-Decoder 或 Diffusion 带来的模态隔离与从头训练限制。Modus 将所有模态统一 Token 化后送入同一个 Decoder,输入输出共享参数,无需任何模态专用 Head 或损失函数。这种设计不仅可以直接继承 LLM 等预训练 Decoder 的先验知识,大幅提升少样本泛化能力,还使得任意模态组合的输入输出成为自然行为,而非多个模型的拼凑。相比 CoDi 等基于扩散模型的 Any-to-Any 工作,Modus 避免了为每个生成任务单独维护去噪管线,架构更简洁,且能无缝接入语言模型的推理能力。
- 通过统一的 Tokenization 和 Timestep 采样策略,Modus 将跨模态生成、链式生成和自我验证统一在单一推理框架内,赋予模型超越独立生成的元能力。模型在训练时混合不同模态的序列并随机采样时间步,学会了在任意模态间转换,因此推理时既可以直接从文本生成图像,也可以先生成深度图再基于深度图生成图像,实现链式可控生成;还能用文本评分图像质量,或生成图像后自行用文本描述验证,形成自监督反馈回路。这种设计让同一个模型在多种生成范式间自由切换,为复杂 AI 系统提供了模块化、可组合的生成单元,而无需部署多个专用模型。
方法
Modus 方法
Modus 的核心设计是将所有模态统一视为 token 序列,通过纯解码器架构实现任意模态之间的对称建模。
输入处理:
- 每种模态(文本、图像、深度图等)首先被统一 Tokenization 方案转换为离散 token。
- 所有 token 被拼接成一个单模态混合序列,其中包含特殊标记指示模态边界与身份,但无专用的模态嵌入或编码器。
- 输入序列中同时可包含任意数量、任意组合的源模态 token,用于条件生成。
关键模块:
- 解码器-only Transformer(如基于预训练 LLM 的因果注意力架构)作为唯一骨干,对所有 token 执行自回归建模。
- 模型没有模态特定的输出头、损失函数或任务流水线;所有模态共享同一套参数,输出 token 由同一个 softmax 预测。
- 训练策略引入 Timestep Sampling,模拟扩散模型中的噪声级别,但在自回归框架下控制模态 token 的生成难度,使模型学会从部分信息中重建完整模态。
- 训练在自有大规模多模态数据集 Modus-Dataset 上进行,该数据集涵盖文本、图像、深度、语义分割等多种模态对。
输出生成:
- 推理时,给定任意输入模态组合,模型通过自回归解码逐步生成目标模态的 token 序列。
- 生成的 token 经对应模态的解码器(如 VQ-VAE decoder)还原为原始模态数据。
- 由于所有模态共享同一解码器,可灵活实现链式生成(如文本→图像→深度)或跨模态自验证(用生成的另一模态为自身输出打分)。
与同类方法的差异:与以往使用编码器-解码器或扩散架构、需要从零训练并包含模态特定组件的 any-to-any 模型不同,Modus 利用纯解码器架构对称对待所有模态,可直接继承预训练语言模型的先验知识,避免了复杂的模态特化设计。
实验
实验设计围绕 any-to-any 能力展开,评估框架包括:零样本生成(给定任意模态组合生成目标模态)、链式生成(通过中间模态间接生成目标)、跨模态自验证(模型用另一模态为自己的输出评分)以及视觉表征组合。实验在统一架构下进行,没有针对特定任务调整头部或损失函数,直接检验预训练的统一解码器在多种输入输出组合上的表现。
关键发现表明,Modus 无需任务专用模块即可实现较强的开箱即用性能。在多个基准上,单一模型与专门任务模型(如专用图像生成器、文本生成器)性能相当,并优于部分多任务基线。链式生成和自验证能力进一步证明其模态对称建模的有效性,模型可将生成任务分解为更小步骤并通过自身评分改进结果。
与基线对比显示,传统 any-to-any 模型多采用编码器-解码器或扩散架构,且需从零训练,而 Modus 利用强大预训练的解码器作为先验,避免模态专用头,展现出更灵活的多模态推理。尽管不总是超越最先进的专用系统,但作为统一的解码器式方案,其在多任务、多模态场景的通用性和竞争力为实际工程部署提供了新思路,降低了维护多个专用模型的复杂性。
行业影响
落地场景
Modus 适用于所有需要多模态理解与生成的平台,用一个统一模型覆盖任意模态的组合输入输出。
- 内容生产与创意工具:在短视频、社交平台中,用户输入一段文字或草图,Modus 可直接生成配图、音频、乃至视频片段,减少人工后期,加速创意迭代。
- 电商与营销自动化:商品数据常包含文本描述、图片、买家评论等。Modus 能实现“文本→商品图”“图片→营销文案”“多模态→多模态”的链式生成,甚至通过跨模态自验证来提高内容准确性。
- 自动驾驶与机器人:多传感器数据(相机、激光雷达、文本指令)的互为输入输出,可统一于一个模型,避免多模型管线对接。Modus 的任意模态到任意模态能力,适合缺失传感器下的模拟重建。
商业价值
- 成本大幅降低:Modus 消除了为每个模态组合搭建专用模型的需求,训练、部署、维护的实例数量显著减少。企业不再需要为每种可能的输入输出对维护一个流水线。
- 体验与效率双提升:用户交互更自然——上传一张图即可获得文字解释、风格变换、语音解说等多模态结果。链式生成允许通过中间模态(如图→分割图→3D 模型)逐步精炼,提高复杂任务的成功率。
- 先发优势与灵活性:基于 decoder-only 架构,可直接利用预训练大模型(如 Llama)的权重,避免从零训练,从而快速构建多模态产品,缩短上市时间。
与现有产品/工作流的集成
Modus 作为一个统一的 decoder-only 模型,与当前 LLM 推理框架(如 vLLM、TGI)天然兼容,可轻松作为通用多模态后端服务嵌入现有技术栈。
- 替换专用模型管线:原先由 CLIP、DALL·E、TTS、ASR 等分别处理的任务,可由 Modus 单一 API 接管,简化网关与调度逻辑。
- 数据闭环支持:其跨模态自验证机制(如文本生成→图像生成→反向验证文本的一致性)可直接集成到质量审核环节,自动过滤低质量多模态输出。
- 微调与适配:企业内部少量多模态数据即可微调出垂类版本,无需为每个新模态重新设计头网络或损失函数。
具体用例
- 社交媒体内容工厂:平台提供“图文转短视频”功能,Modus 根据文案和配图,先扩展出分镜脚本(文本),再生成对应分镜画面,最后合成带语音解说的短片,无需人工介入多个工具。
- 虚拟试穿与商品展示:电商场景下,用户上传一张试穿参考图和一张服装白底图,Modus 直接输出服装穿在身上的效果图,同时生成商品卖点文字和材质说明,实现从输入到完整商品页的端到端流水线。
局限
- **模态覆盖范围有限**:当前 Modus 主要实验于图像、文本、深度等视觉-语言相关模态,尚未系统验证音频、视频、点云等连续高维模态的任意-任意建模能力。模型对模态的统一离散 tokenization 依赖 VQ-VAE 等有损编码器,可能丢失关键细节(尤其在高频纹理或时序信息上),影响生成保真度,也限制了其直接扩展到非视觉模态时的通用性。
- **训练策略与数据混合高度工程化**:Modus 依赖多阶段训练、时间步采样策略以及专门构建的 Modus-Dataset,这些组件对性能至关重要,但调优过程涉及大量超参数。实际复现或迁移到新领域时,数据配比和阶段切换的合理性可能成为主要瓶颈,且缺乏充分的理论指导,更多依赖经验试错。
- **自回归生成效率瓶颈**:作为纯 decoder-only 模型,Modus 以自回归方式逐 token 生成输出,对于图像等高维模态,token 数量通常成百上千,推理延迟显著高于扩散模型等非自回归方法。尽管论文提到了链式生成和自我验证等新应用,但未深入探讨推理加速方案,在大规模在线服务场景下实用性受限。