Shieldstral
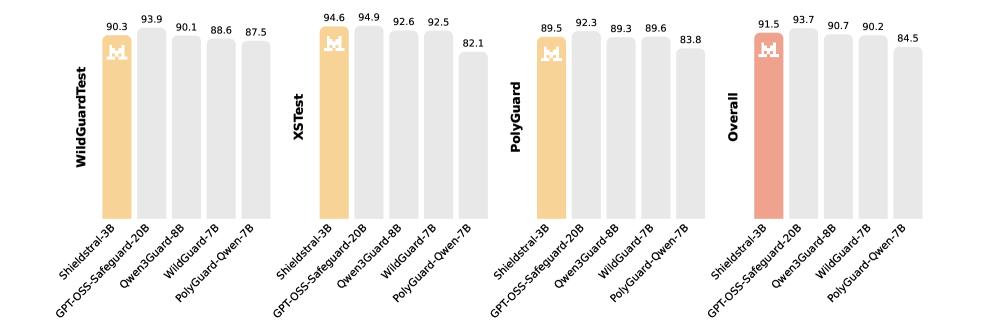
我们提出 Shieldstral,一个 3B参数 的策略自适应多模态安全分类器。它在文本安全基准上匹配或超越近7倍规模的模型,并在多模态安全分类上达到最新最优。 Shieldstral 将内容审核建模为 二元问答任务。这种简单公式将多样化的审核任务统一为单一的是/否问题,使得具有不同分类法的异质安全数据集可以在一个训练框架下合并。 我们展示了数据构建配方,涵盖约 5410万样本 的整理和生成,以及一个 细粒度评估集 用于评估策略适应性。这些使得一个小型自适应模型能够匹配或超越更大的模型。
论文精读
TL;DR Shieldstral 以 3B 参数将多模态内容审核统一为二元问答,融合 54.1M 异构安全数据,实现政策自适应,性能匹配或超越 7× 规模大模型,达成文本与多模态安全分类新 SOTA。
问题
问题背景
随着大语言模型与多模态模型在各类应用中的深度部署,内容安全过滤 已成为不可或缺的基础设施。护栏模型 负责检测模型输入输出中的有害、偏见或违规内容,确保生成结果符合安全标准,其性能直接影响业务合规性与用户体验。
现有方法的局限
当前多数护栏模型采用 固定分类法 进行内容安全判断,即预定义一组安全类别(如暴力、色情、仇恨言论等),将任务视为多标签或多类别分类。这种做法存在两个显著的技术瓶颈:
- 数据异构难以统一:公开安全数据集使用的分类体系各不相同,标签粒度、定义边界差异巨大。固定分类法模型无法直接混合这些异构数据训练,造成数据利用率低下,也限制了模型对罕见安全类型的覆盖面。
- 缺乏政策适应性:真实部署中,安全标准会随应用场景、地区法规或产品迭代而调整。固定分类模型面对新定义或重新划分的类别时,必须重新标注数据、全量微调甚至重新训练,无法通过简单配置策略实现灵活适配。模型本质上将“任务定义”与“推理能力”耦合,丧失了泛化到未见策略的能力。
技术挑战与重要性
安全审核的难点在于 策略本身是动态的、多源的且充满歧义。行业需要的不仅是一个判别器,而是一个能够 理解自然语言策略描述并据此做出二元判断 的智能体。这要求模型具备较强的指令遵循与跨任务泛化能力,而传统分类器架构未能显式建模“任务定义”与“内容”之间的交互。此外,多模态内容(文本 + 图像)的加入使得对齐不同模态的语义空间变得更加复杂,进一步提升了对模型统一表征能力的要求。业界对于既能维持轻量化部署,又能随时按需切换安全策略的通用审核基础设施有着强烈需求。
行业类比
这类似于内容分发平台需要同一套算法同时遵守多个市场的不同内容政策,而传统方案却只能为每个市场独立训练和维护一个专用模型,导致运维成本与响应延迟居高不下。
核心洞察
- 将安全分类任务转化为二分类问答(binary QA)使模型天然具备政策适应性。与固定类别分类器不同,Shieldstral 将所有安全判别映射为 yes/no 问题,从而能在训练阶段融合多种异构安全数据集,并在推理时仅通过改变问题模板即可适配新政策,无需重新训练。这解决了现有 guardrail 模型面对多变部署需求时必须重训或无法泛化的根本瓶颈。
- 大规模对比数据构建证明小模型可通过高质量数据配方超越大模型。Shieldstral 仅有 3B 参数,却在文本安全基准上与近 7 倍大的模型持平或更优,核心在于约 54.1M 样本的精细加工:对比正负例生成、跨验证过滤、VL reranker 硬负例挖掘等策略,在统一的二元决策空间中强化了分类边界,使得小模型也能学到稳健的安全概念,为产业界追求低延迟、低成本的安全模型提供了可复现的数据工程范式。
方法
输入与任务统一
Shieldstral 将多种内容安全审核任务统一为二值问答:给定一段文本(或文本+图像)以及一个描述安全政策的查询(query),模型输出 yes(违规)或 no(安全)。这种设计使其能灵活适配不同组织定义的安全分类法(taxonomy),无需为每套类别体系单独训练模型。
训练数据构建
数据构建围绕三个核心步骤:
- 模板化统一:为所有异构安全数据集设计统一的 instruction / query 模板,将原始标注转化为“是否符合 X 政策?”的 yes/no 格式。图像数据同样通过 query 变异和标签统一来转换。
- 对比样本筛选与生成:通过正负样本匹配、类别平衡和交叉验证过滤,确保训练数据质量;同时使用 LLM 根据目标分类法重写样本,生成与原样本语义相似但类别不同的对比数据,提升模型对政策细节的敏感性。
- 多模态硬负例生成:利用视觉语言模型的 reranker 筛选混淆样本,并主动生成硬负例(外观相似但违反政策的图文对),强化细粒度判别能力。
模型架构与训练
Shieldstral 基于一个 3B 参数的多模态基础模型(从实验结果推断可能为视觉语言模型),在统一后的 54.1M 样本上进行微调。训练采用 LoRA 等参数高效方法,并引入模型合并(从多个 LoRA 变体平均权重)来提升泛化能力。消融实验表明,LoRA 微调在策略适应性上优于全量 SFT,模型合并进一步稳定了跨政策表现。
输出与策略适应
推理时,输入端同时包含待审核内容和当前生效的安全政策(以自然语言问题形式),模型输出 yes/no 预测。通过改变查询中的政策描述,同一个模型无需重训即可适应全新的安全分类法。
与同类方法的差异
与基于固定类别集合的 guardrail 模型(如 Llama Guard 系列)不同,Shieldstral 不依赖预定义类别名单,而是以 QA 范式动态理解政策语义,从而在跨政策泛化与模型规模效率上取得显著优势。
实验
实验设计
Shieldstral 将安全审查任务统一为二进制问答 (Yes/No),在此框架下整合了来自公开安全数据集的约 54.1M 条样本,覆盖文本和多模态内容。训练时采用对比样本构造与生成,并划分出细粒度评估集来测试策略可适应性 (policy adaptability)。模型基于 3B 参数,使用 LoRA 或全量微调(论文未明示)以及模型合并技术。
关键发现
- 在文本安全基准上,Shieldstral 可匹配甚至超越参数量近 7 倍 的基线模型。
- 在多模态安全分类任务上,Shieldstral 刷新了最佳水平 (SOTA)。
- 通过统一的任务形式,小模型成功整合了原本分类法各异的数据集,展现出强大的跨策略泛化能力。
与基线对比的解读
传统安全护栏模型多采用固定类别分类,无法适配不同部署场景的安全策略。Shieldstral 的问答式二分类框架天然支持策略注入,无需为每个新策略重新训练模型。相比大型固定分类模型,Shieldstral 不仅参数量低、推理成本小,而且通过数据融合与对比训练弥补了规模劣势,在多个任务上超越大模型。这表明,在安全审查领域,任务统一与数据质量 可能比模型规模更为关键,为实际部署提供了轻量、灵活且高效的替代方案。
行业影响
落地场景
Shieldstral 作为一个轻量级(3B 参数)、策略自适应的多模态安全分类器,可无缝嵌入多种 AI 驱动的内容生态:
- 社交媒体平台(文本 + 图像)的实时内容审核,动态适配不同地区政策而无需重新训练。
- 大语言模型问答系统的 Guardrail 层,在输出前对回复进行安全二分类,阻止有害、偏见或违规内容。
- 电商平台评论与商品图片的合规过滤,确保展示内容符合品牌安全与法律要求。
- 教育科技产品中过滤不当课件或学生交互内容。
商业价值
- 降本:仅 3B 参数,推理成本远低于通用大模型,支持 CPU/边缘部署,大幅降低安全审核的基础设施支出。
- 增效:通过二进制问答统一多任务,将异构安全数据集合并训练,减少为不同客户或政策定制多个专用模型的重复开销。
- 体验提升:策略自适应能力可在不牺牲响应速度的前提下,灵活对齐不同业务线的内容标准,减少误杀与漏放,维护健康的社区生态。
- 合规避险:及时拦截非法或有害内容,降低平台面临的法律与声誉风险。
与现有产品 / 工作流的接口
Shieldstral 提供标准化的 安全分类 API,极易集成进 MLOps 栈:
- 作为 LLM 推理管道中的后置过滤微服务,例如在 vLLM 或 NVIDIA Triton 推理服务器上部署,调用
/v1/check端点。 - 与现有 guardrails 框架(如 NVIDIA NeMo Guardrails、Guardrails AI)组合,作为可插拔的二进制安全评估器,覆盖多模态输入。
- 在 RAG 系统中,对检索文档进行预过滤,防止不安全知识进入生成上下文。
具体落地 Use Case
- 全球内容分发平台:某视频分享 App 需遵守数十个国家的不同言论标准,使用 Shieldstral 作为统一安全层,运维团队只需动态下发政策标签,模型即可切换判定边界,避免为每个地区独立部署模型,极大简化运维。
- 企业级 AI 助手:某跨国银行内部客服系统集成 Shieldstral,在回答客户理财问题时,实时检测并屏蔽含诱导投资、歧视性或泄露隐私的生成内容,保障合规性和客户信任。
局限
- 论文通过统一的二元问答框架整合异构安全数据,但依赖于大规模训练数据(约54.1M样本)的精心策展与生成。构建过程涉及模板设计、对比样本生成、重排序过滤等多个步骤,数据配方高度定制化,当部署环境的安全分类法或应用场景与训练数据差异较大时,可能仍需大量额外标注数据才能保持效果,限制了开箱即用的迁移能力。
- 将内容审核简化为二元分类(是/否)虽然高效统一,但损失了细粒度信息。现实场景中,安全审核往往需要识别危害类别、严重程度或给出解释,单纯的是/否判決无法满足这类需求,可能需要在后处理阶段引入额外模块,增加了系统复杂性。此外,模板化的二元问题可能对模糊边界案例的区分能力不足。
- 论文强调策略自适应,但评估可能基于预定义的分类法变化(如安全类别的增删或重定义)。面对完全未知的新类型攻击或违反政策的内容时,模型能否真正自适应仍存疑。另外,多模态评估虽达到SOTA,但实验主要覆盖文本,图像部分的鲁棒性和跨模态一致性分析尚不充分,实际多模态应用中的泛化能力有待验证。