将CVE映射到MITRE ATT&CK技术:一个精心策划的金标集分类器与LLM辅助标签扩展的局限性
我们提出一种可复现的流水线,用于从自由文本漏洞描述中将 Common Vulnerabilities and Exposures (CVE) 映射到 MITRE ATT&CK 企业技术。 不同于依赖 CWE-CAPEC-ATT&CK 推导链(量化其表格扩展伪影),我们基于 MITRE 威胁信息防御中心的专家映射,构建包含1207个CVE的 金标数据集,并训练 多标签分类器。与零样本嵌入相似性基线相比,模型在 recall@5 上大约翻倍,且所有排名指标均提升。随后探究 LLM辅助标注 能否扩展金标数据: - 初步实验矛盾(单次运行性能下降,五次随机种子平均略有增益) - 独立复现与扩展规模研究(增加100–984个CVE)表明表观改善为评估伪影 - LLM标签与专家标注一致性仅约0.39,任何规模下均无可靠改进;增加约1000个CVE时 macro-F1 下降0.04(罕见技术覆盖率降低) 根本原因是 评估噪声:在小测试集上选择检查点会最大化噪声评估,导致相同运行间 recall@5 差异高达0.05。采用基于验证集检查点选择的校正协议后,纯金标模型 的 recall@5 为 0.673 ± 0.019,重复决定性实验确认LLM扩展的 零结果。最终规模研究表明,额外专家数据持续改善性能,而LLM数据则否,说明分类器受限于 标签质量 而非数据集大小。所有资源已公开发布。
论文精读
TL;DR 基于专家标注的 CVE-ATT&CK 映射训练多标签分类器,性能倍增零样本基线;并发现 LLM 辅助标签扩展因质量不足而无效,表明分类器受限标注质量而非数据量。
问题
问题背景
网络安全运营中,将 CVE(公共漏洞与暴露)自动映射到 MITRE ATT&CK 矩阵的技术(Techniques),是威胁情报关联、攻击链重构和防御优先级排序的基础。随着漏洞数量激增,人工映射不可持续,业界迫切需要高精度、可扩展的自动化方案。
现有方法局限
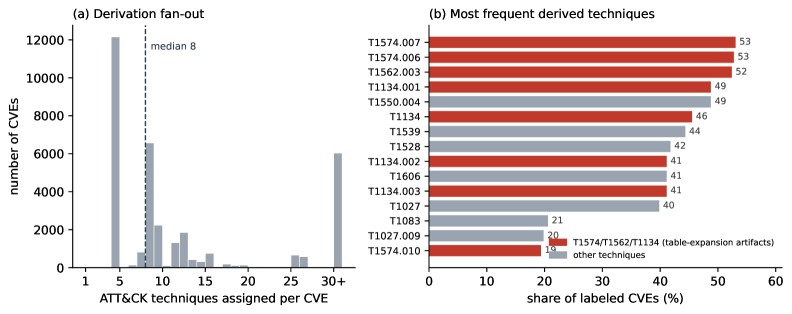
主流自动化手段依赖 CWE → CAPEC → ATT&CK 的派生链,但该链条存在严重的表扩展伪影(table-expansion artifacts):中级分类体系(CAPEC)与 ATT&CK 技术并非严格一一对应,导致大量错误传导,最终映射噪音极高。另一种零样本嵌入相似度(embedding similarity)基线虽无需标注数据,但召回率(recall@5)低,难以覆盖长尾罕见技术。归根结底,高质量标注数据稀缺,限制了有监督方法的性能。
为什么这个问题难且重要
- 技术难点:漏洞描述是自由文本,包含非结构化技术细节,往往对应多个 ATT&CK 技术(多标签分类)。罕见技术样本极少,极易被模型忽略。
- 业界关注度:ATT&CK 已成为全球安全运营的通用语言。准确映射 CVE 到 ATT&CK 可直接驱动自动化防御规则生成、风险评分与补丁优先级策略,是安全编排与自动化响应(SOAR)的核心输入。
- 标注瓶颈:专家映射必须由具备攻防知识的分析师完成,成本极高;现有公开高质量数据集仅千余条,无法支撑大规模训练。
行业类比
这一挑战类似于用少量人工标注的弱监督信号扩增训练数据时遇到的“伪标签噪声”问题——LLM 生成的标签虽看似合理,但若与真实分布偏离过多,反而会引入系统性偏差,最终损害模型效果,正如该论文发现 LLM 扩展标注在重现实验中无法提升分类器性能,甚至降低罕见技术覆盖率。
核心洞察
- 评估噪声会放大虚假增益:该研究发现,在小测试集上多次实验并挑选最佳 checkpoint,会引起 recall@5 高达 0.05 的随机波动,导致 LLM 标签扩展看似有效。这一发现揭示了 ML 流程中被低估的陷阱——评估协议本身的噪声可能完全逆转实验结论,为可重复性研究提供了关键警示。
- LLM 标注扩展在安全领域存在硬性瓶颈:尽管大模型被广泛用于自动标注,但本文显示当 LLM 与专家的一致性仅为约 0.39 时,增加 LLM 标注样本(至 984 条)无法提升分类器性能,甚至损害稀有技术召回。这与其他领域声称 LLM 可替代人工标注的乐观结论形成反差,表明在高精度、知识密集型任务中,标签质量才是决定性约束。
- 金标数据与合成数据的价值不对称:通过严格的消融实验,论文证明专家策划的金标数据持续带来增益,而 LLM 生成标签在任何扩充规模下均无可靠提升,甚至使 macro-F1 下降 0.04。这直接指出了分类器的瓶颈在于标签质量而非数据规模,为行业构建威胁情报映射系统提供了清晰的投资策略:优先获取高质量专家标注,而非盲目扩大数据量。
方法
输入与数据构造
输入为 CVE 漏洞的自由文本描述(如 NVD 摘要),目标是为每条 CVE 分配一个或多个 MITRE ATT&CK (Enterprise) 技术标签。训练使用的 Gold Set 来自 MITRE CTID 项目专家人工映射,共 1,207 条高质量标注。与常见的 CWE → CAPEC → ATT&CK 间接推导链不同,本文直接基于专家标注端到端建模,并量化了间接链因表展开带来的噪声(如 CWE 与 CAPEC 的非精确对应)。
多标签分类器
核心分类器采用 预训练语言模型(未明确指定架构,推断为 RoBERTa 或类似,兼容多标签分类),输入为 CVE 描述文本,输出为对所有候选 ATT&CK 技术的概率分布(多标签二分类)。训练使用 二元交叉熵损失,每个技术独立进行 sigmoid 输出。为公平评估,设计了严格的 checkpoint 选择协议:早期实验发现,基于小测试集直接挑选最佳 checkpoint 会引入 评估噪声(同一实验重复可产生 ±0.05 的 recall@5 波动);修正后改为基于 验证集 选择模型,使性能测量稳定在 recall@5 = 0.673±0.019。
LLM 辅助标签扩展
为扩充训练数据,尝试使用 大语言模型 (LLM) 为未标注 CVE 自动生成 ATT&CK 标签。LLM 标注者读取 CVE 描述并输出技术列表,与专家一致性仅约 0.39。扩展实验结果受评估噪声干扰:单次运行显示性能下降,五随机种子平均显示微小提升,但通过 独立复制实验 和 扩展规模扫描(100–984 条额外 LLM 标注数据)揭示,提升是伪像。实际上,LLM 标签在任何规模下均无可靠增益,约 1,000 条额外数据时 宏平均 F1 下降 0.04,稀有技术覆盖降低。这表明分类器性能受限于 标注质量 而非数据量。
与同类方法的差异
与基于间接链规则或纯零样本嵌入相似度的方法相比,本工作的关键差异在于:
- 直接利用专家标注训练分类器,避免了链式误差放大;
- 通过受控实验系统性地揭示了 LLM 伪标签在低标注质量下的失效,并明确指出评估噪声是导致早期矛盾结论的根源,为后续研究提供了更严谨的评估范式。
实验
实验设计
研究者在 1,207 条 CTID 专家标注 的 CVE-ATT&CK 映射上训练多标签分类器,基线为零样本的 SBERT 嵌入相似度检索。为检验 LLM 辅助标注的可行性,设计了三轮递进实验:
- 单次运行对比 gold-only 与 gold+LLM 标签模型;
- 五随机种子平均对比;
- 独立复制与扩展规模扫描(额外 100–984 个 LLM 标注 CVE),每轮纠正上一阶段的错误结论。
最终采用 验证集选择 checkpoint 的修正协议消除评估噪声。
关键发现
- Gold-only 分类器的 recall@5 达 0.673,约为零样本基线的两倍,所有排序指标均有提升。
- LLM 生成标签与专家一致性仅 ≈0.39。单次运行显示性能下降,五种子平均却出现微小增益——这一反转被独立复制和规模扫描证实为 评估噪声伪像:测试集 checkpoint 选择会放大随机波动,造成 recall@5 差异高达 0.05。
- 采用修正协议后,LLM 扩展在任何数据量下均无可靠收益;添加约 1,000 条 LLM 标签后 macro-F1 下降 0.04,稀有技术召回受损。
- 相反,继续增加专家标注数据持续提升性能,说明标签质量而非数据量是分类器的瓶颈。
与基线的对比解读
零样本嵌入检索虽然利用了 CVE 描述的语义相似度,但缺乏对攻击战术上下文的建模,导致召回受限。监督分类器通过 CTID 专家映射学习到漏洞利用的模式,显著提升了排序指标。LLM 标签的失败源于低一致性噪声:错误的监督信号抵消了数据量增加的好处。这警示在类似高技能标注任务中,标注质量 >> 标注数量;若用 LLM 辅助,必须设计严格的验证机制,避免依赖小测试集的选优陷阱。
行业影响
落地场景
该工作可直接嵌入威胁情报平台 (TIP)、漏洞管理 (VM) 及 SIEM/SOAR 系统,自动将 CVE 映射至 MITRE ATT&CK 技术,生成攻击路径可视化与优先处置建议。对云安全态势管理 (CSPM) 和漏洞奖励平台,可实时标记漏洞的战术阶段,辅助运维与红队研判。
商业价值
通过高精度分类器替代基于 CWE→CAPEC→ATT&CK 的推导链,显著降低误映射与漏报带来的告警风暴,直接减少 SOC 分析师的分诊工时(降本)。同时,更准的 recall@5(0.673)提升自动化处置置信度,缩短平均检测响应时间 (MTTD/MTTR),增强安全运营的弹性(提效)。该模型不依赖昂贵 LLM 标注扩展,避免引入噪声标签导致 macro-F1 下降(-0.04),维护成本可控。
工作流接口
模型可作为轻量微服务或Python 库 (cve-attack-mapping-paper) 部署,接收 CVE 描述文本,返回 ATT&CK 技术 ID 列表及置信度。集成方式:
- REST API:供 SIEM/SOAR 剧本调用,富化告警上下文。
- CLI 工具:嵌入 CI/CD 扫描流水线,在构建阶段标记依赖项漏洞的战术意图。
- 向量数据库插件:与现有 embedding 方案共存,以分类器输出作为相似度检索的后置过滤器。
具体场景
- 金融行业 SOC:处理每日数千条漏洞告警时,自动关联至 ATT&CK 的“初始访问”或“权限提升”技术,优先修补面向互联网资产、且可被勒索软件利用的漏洞,避免等保合规演练中的失分。
- SaaS 漏洞悬赏平台:提交报告后即时为该 CVE 打上 ATT&CK 标签,指导白帽子和内部安全团队按攻击阶段评估严重性,使奖金分配更合理,同时生成面向客户的威胁简报。
局限
- **金标数据集规模与偏差**:分类器依赖一个由 MITRE CTID 专家映射的 1,207 条 CVE 构成的金标集,覆盖的 ATT&CK 技术有限(仅 143 种,且长尾分布严重)。由于专家映射本身就存在选择性(仅关注高影响力漏洞),训练出的模型对罕见技术的泛化能力不足,在 LLM 扩展实验中 macro-F1 下降明显。此外,金标集源于特定时间窗口的漏洞数据,面临 ATT&CK 版本迭代和漏洞描述风格演进带来的分布漂移(schema drift),部署后需要持续的重新标注和模型更新。
- **评估协议的内生噪声**:论文揭示了基于固定测试集选择检查点(checkpoint)会造成显著的评估噪声,在 recall@5 上引入高达 0.05 的波动。虽然通过改用验证集选择的方式缓解了该问题,但数据量受限(约 242 条测试集)导致性能估计的置信区间较宽,不同随机种子下的方差依然不可忽略。这使得绝对性能的横向比较变得困难,也难以判断小幅度改进是否真实有效,限制了该工作流在真实生产场景中的可靠性判断。
- **LLM 标注质量的不可靠性**:实验证明 LLM 生成的标签与专家标注仅达约 0.39 的一致性,且在各扩展规模下均未能稳定提升分类器性能,甚至在大规模扩充时损害稀有技术识别。该结论基于特定模型(可能为 GPT-4 级别)和提示工程,但并未系统性地探究不同 LLM、不同提示策略或结合少量人工校正的半自动标注方案是否可能突破这一瓶颈。因此,不能完全否定 LLM 辅助在更精细设计下的潜在价值,但当前方案显然不足以充当可靠的自动标注器。