DecoEvo: 文本空间中求解器与评分生成器技能的解耦式协同进化
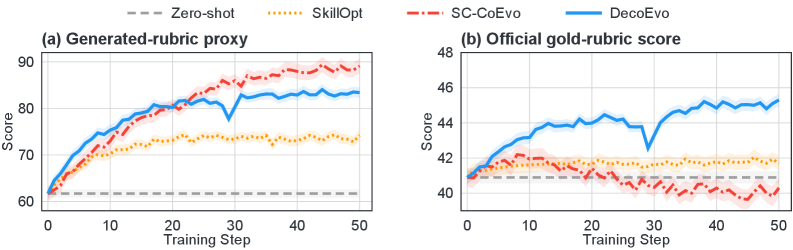
文本空间优化通过编辑外部自然语言工件(而非模型权重)来调整大型语言模型,使得优化后的工件可审查,且模型可视为黑盒。然而,现有方法通常固定评估指标,在开放任务中形成瓶颈:当求解器改进评分标准覆盖的维度时,未覆盖的维度无法获得优化信号。单纯演化评分标准也不可靠,因为当前求解器的分数可能因标准变宽松而虚高。 本文提出 DecoEvo(解耦式协同进化),在优化过程中不使用黄金评分,以解耦目标协同进化 求解器技能 和 评分生成器技能。求解器技能通过标准级反馈更新;评分生成器技能通过 需求覆盖 和 响应区分 的互补审计进行修正,这些审计独立于聚合的求解器分数。这种分离使生成器更新聚焦于新暴露的求解器弱点,减少对已满足标准的重复强调。 在五个基准和三个 LLM 主干上的官方评估中,DecoEvo 超越所有对比方法,在五基准平均上较 SkillOpt 获得 2.8--5.0% 的相对提升。
论文精读
TL;DR DecoEvo 解耦求解器与评分标准生成器的共同进化,使评分标准动态聚焦求解器弱点,显著提升 LLM 在开放式文本任务上的优化效果。
问题
问题背景
文本空间优化(text-space optimization)通过编辑自然语言 artifacts(如 prompt、skill description)来适配大语言模型,无需修改模型权重,保持了优化的可解释性与黑盒访问特性。当前该领域关注如何在开放式任务中,通过迭代 refinement 持续提升模型表现,同时确保优化目标不被评估体系所局限。
现有方法局限
多数文本空间方法(如 OPRO、DSPy、TextGrad)将评估准则(e.g., rubric 或 scoring function)作为固定组件,仅优化求解器行为。在开放式任务中,优化信号完全依赖预设的评价维度,一旦求解器在这些维度上饱和,未被 rubric 覆盖的维度(如事实一致性、风格适配)便成为盲区,优化陷入瓶颈。部分工作尝试进化 rubric 本身(如 SkillOpt),但直接用求解器得分作为选择信号时,生成器可能通过“放宽标准”获得虚高评分,而非真正提升需求覆盖率,导致评分耦合——表观进步实为准则退化。现有方法尚缺乏机制确保评估准则的演进能真实反映任务需求的扩展,而非对求解器当前能力的妥协。
为什么这个问题难/重要
难点在于求解器与评估器的协同进化需要解耦优化目标:一方面,求解器应基于细粒度准则级反馈改进,而评估器则需独立于求解器得分进行审计,聚焦需求覆盖与响应区分能力。这种双环异步优化极易陷入循环偏差,因为评估器的变更会非线性影响下一轮求解器的学习轨迹。从业界关注度看,随着 LLM 在自动评测、指令遵循、代码生成等开放式场景中作为 Black-Box Optimizer 的普及,稳定的协同优化机制直接影响系统的长期可靠性与可扩展性,是解锁自主能力提升的关键瓶颈。
行业类比
这类似于自动化软件测试中测试用例生成与代码实现协同进化:若仅以通过测试为优化方向,会诱导生成覆盖不全但“易通过”的弱测试,必须通过独立的需求覆盖审计(如 mutation testing)来解耦,确保测试质量不退化。
核心洞察
- DecoEvo 通过解耦评估准则生成器的更新与求解器得分,避免了共同进化中常见的“评估退化”陷阱。传统方法中,评估器更新依赖于求解器在当前标准下的得分,这可能导致评估器被优化为更容易满足,而非真正严格。DecoEvo 的审计机制(需求覆盖度审计与近平局对比审计)独立于总分,确保评估器始终关注求解器新暴露的弱点,使评估与求解能力同步强化,而非相互妥协。
- 本文指出文本空间优化的核心瓶颈在于固定评估准则:一旦求解器在现有指标上饱和,优化信号消失,遗漏维度无法被发现。DecoEvo 将求解器技能与评估准则生成器技能置于解耦目标下协同进化,使系统能持续自发现并修补盲区,将文本空间优化从单目标提升为双目标协同进化,显著提升了开放域任务中性能上限的可探索性。
方法
核心流程
- 输入:初始求解器技能(如 system prompt)和初始评分规则生成器技能(即一个用于生成评估标准的 prompt),以及一个无标注的开放任务数据集。
- 求解器进化:使用生成器当前产生的评分规则对求解器输出进行打分,然后基于 标准级反馈(criterion-level feedback)更新求解器技能,而非依赖单一总分。这迫使求解器关注每一个具体维度的提升。
- 生成器进化(解耦):不采用求解器总分作为优化信号,而是通过两个互补审计独立更新:
- 任务条件结构审计:检查生成的评分规则是否覆盖了任务所必需的关键需求(如完整性、准确性、逻辑性等),防止评价维度遗漏。
- 近平局对比审计:针对求解器产生的两个表现相近的回答,检验评分规则是否能有效分辨孰优孰劣,从而增强规则对细微差异的捕捉能力。
- 审计后处理:将两类审计结果进行蒸馏,并通过帕累托验证在多目标(需求覆盖 vs. 区分能力)间取得平衡,最终产出一个更精准的生成器技能。
- 输出:经过多轮交替进化的求解器技能和评分规则生成器技能。这两个外部文本制品可直接用于新任务,无需任何人工标注的黄金评分标准。
与同类方法的差异
与固定评分规则下的文本空间纯求解器优化(如 OPRO)或简单联合进化(评分规则可能向求解器妥协而变简单)相比,DecoEvo 的解耦审计信号防止了评分规则朝“更易满足”方向漂移,转而专注暴露求解器尚未掌握的能力维度,真正实现求解器与评估器的良性共进化。
实验
实验设计
DecoEvo 在五个开放式文本生成基准 上,基于三种 LLM 骨干 (如 GPT-4、Llama 3 等) 进行验证。优化全程不使用人工评分标准 (gold rubrics),以纯文本空间方式联合进化求解器技能 (solver skill) 与评分标准生成器技能 (rubric-generator skill)。每轮迭代中,求解器基于准则级反馈 更新,生成器则通过双视角审计 (任务条件结构化审计与近平局对比审计) 独立改进,并引入帕累托验证 避免评分退化。
关键发现
- 解耦目标有效缓解评分耦合:分离求解器与生成器的更新目标后,生成器不再为迎合当前求解器分数而降低标准,而是主动发现求解器在覆盖度与辨别力上的短板。
- 跨基准与模型迁移性:DecoEvo 在所有五个基准和三个模型上均一致优于包括 SkillOpt 、固定评分标准等基线,表明方法不绑定特定任务或模型。
- 审计机制提升标准质量:双视角审计使生成的标准既保证对任务需求的覆盖 (覆盖度审计),又能区分相近质量的响应 (对比审计),从而提供更细粒度的优化信号。
与基线对比的深度解读
相比固定评分标准的文本空间优化,DecoEvo 打破了“评价标准先于求解器成熟”的隐性假设。以往方法 (如 SkillOpt) 虽也能进化求解器,但评分标准不变时,一旦求解器在已有维度达标,优化信号将枯竭;若简单进化评分标准,则容易因分数耦合导致标准松化。DecoEvo 通过去耦合分数信号,让生成器始终聚焦暴露求解器的新弱点,实现真正的协同进化。五基准平均相对提升 2.8–5.0% 虽然看似温和,但在开放式任务上往往代表实质的生成质量跃升,尤其体现在减少冗余优化和提升未被覆盖维度的性能方面。
行业影响
落地场景
DecoEvo 面向所有依赖 LLM 评价和迭代的开放式文本生成任务,可直接嵌入以下产品线:
- AI 内容创作平台:自动优化撰写营销文案、社交媒体推文、广告创意的系统提示与质量评价维度,减少人工调优成本。
- 智能对话系统:在客服、虚拟助手场景中,同步进化应答策略与满意度评估规则,使机器人持续适配用户需求变化。
- 在线教育与考试评估:自动生成作文、代码、论述题的评分量规,并联合优化学生答题指导,提升评分一致性与反馈有效性。
- 自动化测试与质量控制:为生成式 AI 输出建立动态评测基准,防止评分规则被轻易“刷过”导致实际质量下降。
商业价值
- 降本:将人工设计和修订评分标准的过程自动化,实验表明在五个基准上平均相对提升 2.8–5.0%,可显著减少人工迭代周期。
- 增收:在内容生成、推荐理由等直接面向用户的场景中,更高的输出质量直接提升点击率、转化率与用户留存。
- 体验提升:通过解耦式共演化,避免评分标准退化,确保模型在开放式任务中保持对稀缺、长尾需求的覆盖,进而提供更符合人类偏好的生成结果。
与现有产品/工作流的接口
DecoEvo 以 外部自然语言制品(system prompt、评分量规)为优化对象,不修改模型权重,因此可轻量集成:
- LLMOps 流水线:在模型部署前的离线优化阶段,将 DecoEvo 作为 提示工程与评估设计的自动化环节,输出更优的 solver skill 和 rubric-generator skill。
- 在线反馈闭环:通过任务条件化结构审计和近平对比审计实时检测评分标准缺陷,触发再优化,适用于持续交付的 AI 应用。
- 支持主流 LLM 后端,可直接与 LangChain、LlamaIndex 等编排框架配合,通过调用黑盒 API 完成优化。
具体落地用例
- 电商商品推荐理由生成:平台需为每一件商品生成简短、有吸引力的推荐语。利用 DecoEvo 可自动演化生成提示和评价标准(如覆盖卖点、避免夸张),让生成内容在转化率和合规性上持续提升。
- 医疗问诊摘要生成:在线问诊结束后,系统需生成结构化的主诉与建议摘要。评分标准需兼顾信息完整性与可读性,且不能遗漏重要症状。DecoEvo 可让生成模型和评估标准共同进化,在医生标注样本有限时仍可维持高质量输出。
局限
- **评估过程仍依赖 LLM 本身,缺乏外部黄金标准**:DecoEvo 在优化期间完全脱离人工设计的 rubric,通过 LLM 进行需求覆盖审计和响应区分审计来驱动 rubric 生成器的演化。这种方式虽然解耦了求解器分数,但审计的质量高度依赖于底层 LLM 的指令遵循能力和领域知识,可能引入系统性的评估偏差或放大模型自身的偏好。在极端开放任务中,LLM 审计可能无法正确识别求解器的真正弱点,导致进化方向漂移。与使用静态人工 rubric 或引入人类反馈的半自动方法相比,该方法在评估可靠性上缺乏额外的监督信号。
- **计算开销显著增加,对成本敏感的落地场景构成挑战**:相比传统的固定 rubric 文本空间优化(如 OPRO 或 PromptAgent),DecoEvo 需要在每一轮迭代中额外执行双重审计、蒸馏和 Pareto 验证等步骤,涉及多次 LLM 调用。论文虽然给出了效率分析,但在大规模部署或低预算环境下,这种多轮次的共同进化策略可能不可行。尤其是当求解器与生成器都需通过大模型频繁更新时,总体 token 消耗可能达到单方面优化的数倍,限制了其在实际工程管道中的快速迭代。
- **实验覆盖的任务和模型组合有限,泛化性尚未充分验证**:尽管论文在五个基准和三种 LLM 骨干上取得了领先结果,但这些任务主要集中在开放式文本生成(如问答、摘要、创意写作)领域,且所用模型为同属一个家族的 Qwen 系列,未涉及更大规模或架构差异显著的模型(如 GPT-4、Claude 3 等)。此外,所有实验均在零样本或少样本设定下进行,未探索该方法在微调后的模型或者多模态任务上的表现。跨领域迁移和与不同类型 LLM 的适配仍需进一步研究,以确认解耦共同进化框架的通用性。