新主张还是似曾相识?重新思考多模态自动事实核查的“无污染”动态评估
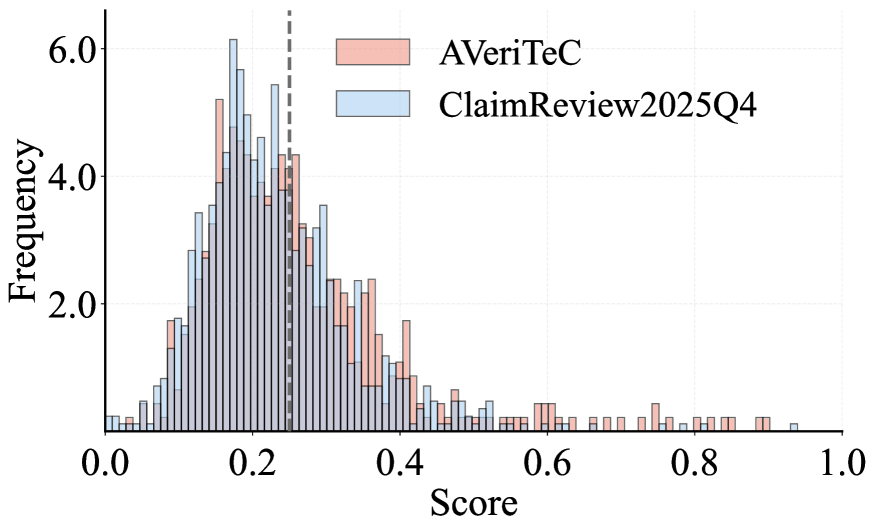
多模态自动事实核查(Multimodal Automated Fact-Checking, MAFC)通过检索和推理外部证据来验证主张。然而,大多数现有静态基准面临污染风险:它们主要包含过时主张,这些主张无需外部证据,仅凭LLM的内部知识即可验证。这可能导致性能估计膨胀,无法反映模型对需要最新信息的新主张的真实能力。 为应对这一问题,新兴的动态基准收集LLM知识截止日期后发布的主张,假设它们未被污染。本研究通过实验重新审视该假设,考察了SOTA静态基准AVeriTeC以及我们新构建的动态基准ClaimReview2025Q4中的污染风险及其对MAFC评估的影响。实验得出16项发现,突出三个关键结果: 1. 动态评估减少了但并未消除污染风险:17.09%–29.30%的截止日期后主张仍可能被污染; 2. 许多新发布的主张可直接验证,或通过综合截止日期前的多个公开知识片段验证; 3. 污染可导致MAFC性能出现统计显著的膨胀,Macro-F1最多提高11.34分,并扭曲系统排名。 基于这些发现,我们在严格控制污染的条件下重新评估了SOTA LLMs。本研究为可信的MAFC评估提供了实用指南。
论文精读
TL;DR 这篇论文实证揭示了多模态事实核查的动态基准测试仍存在严重数据污染,尽管声明时间在模型知识截止后,仍有近三成可能被模型记忆,导致性能虚高和排名失真,并提出了可信评估指南。
问题
多模态自动事实核查(MAFC)正从静态基准向动态基准(dynamic benchmarks) 演进,旨在通过收集 LLM 知识截止日期之后的新声明,规避训练数据泄露导致的评估失真。但本文发现,这种“截止日期后即无污染”的假设并不充分,动态基准中仍有17%–29% 的声明可能被污染。
根本原因是许多新声明可通过组合截止日期前已公开发布的多条独立知识推理得出,无需依赖完全未见的证据,这使得 LLM 能绕过检索直接回答,造成污染(contamination)。污染会显著虚增性能指标(Macro-F1 最高上升 11.34 分),并扭曲系统排名,导致对模型真实泛化能力的误判。
消除污染之所以困难,在于它不限于简单的数据重复,而是涉及知识重组与推理:LLM 可能在训练中学会了若干相互独立的陈述,当这些陈述组合恰好能推出某个新声明的真值时,该声明实质上也被污染了。这意味着仅以发布日期为过滤条件,无法保证基准的“清洁性”。业界对可信赖的 MAFC 评估需求迫切,若评估体系不可靠,将直接误导技术研发方向与产品部署决策。
这一现象类似于大型语言模型基准测试中的数据沾染问题:测试集若与训练集存在信息重叠,即使样本完全不同,模型也可能通过归纳拼接获得不公平优势,这要求评估方法必须从纯粹的时间隔离升级为对知识来源的精细拆解与控制。
核心洞察
- - **动态基准的“免污染”假设在实践中崩溃**:即使将知识截止日期之后的声明作为评估样本,仍有 17%–29% 的声明可能通过 LLM 的内部知识或跨证据合成被验证,这颠覆了当前仅依赖发布时间构建无污染评估的流行做法。与先前工作将动态基准视为污染解药不同,本研究首次量化并揭示了污染风险残留,强调必须设计证据依赖性验证指标和更严格的污染审计来保证 MAFC 评估的保真度,否则动态基准仍会虚增模型性能。
- - **污染诱导的 MAFC 性能扭曲是系统性且统计显著的**:在静态 AVeriTeC 和新建的 ClaimReview2025Q4 上,污染导致 Macro-F1 最高膨胀 11.34 分,并改变了系统排名,这意味着基于受污染基准进行模型选型或迭代将严重误导技术决策。本文提出的严格控制污染的重评框架,为构建可信的高风险事实核查系统提供了验证范式,尤其对需要实时核查突发新闻的应用场景,污染识别应成为评估流水线的必选步骤,而非事后补救。
方法
方法概览
该工作围绕多模态事实核查(MAFC)中的知识污染问题,提出一套污染检测→基准构建→影响量化→受控重估的评估方法论。
输入与核心定义
- 污染的定义:在 MAFC 中,一条声明若能被 LLM 仅依赖其内部知识(不访问外部证据)正确验证,则认为该声明被污染。这区别于传统 NLP 任务的训练数据泄露:污染源自模型预训练语料中已包含与声明等价的公共知识。
- 输入:已有静态基准 AVeriTeC 以及作者新构建的动态基准 ClaimReview2025Q4(来源于 ClaimReview 事实核查语料,选取 2025 年 Q4 声明,确保其发布日期晚于主流 LLM 的知识截止日期)。
关键模块
污染检测流水线
- 内部知识生成:给定一条声明,仅向 LLM 提供声明文本(不含外部证据),要求其生成裁决(Supports / Refutes / Not Enough Info)以及支撑性证据片段。
- 证据提取与对齐:使用另一 LLM(如 GPT-4o)将生成的证据与标准事实核查报告中的证据进行语义对齐,实现自动比对。
- 污染判定准则:若 LLM 仅凭内部知识给出的裁判结果与被广泛认可的事实核查结论一致,则标记为 “潜在污染” (考虑模型固有不确定性的阈值筛选)。
基准构建与污染评估
- 通过上述流水线,分别计算静态基准(AVeriTeC)和动态基准(ClaimReview2025Q4)中的污染比例,发现动态评估虽大幅降低污染(静态 >60%),但仍有 17.09%–29.30% 的声明被 LLM 内部知识覆盖。
污染影响量化
- 对比 MAFC 系统在全量测试集 vs. 严格去污子集上的性能(Macro-F1),发现污染可导致高达 11.34 点的性能膨胀,并改变不同 LLM(如 GPT-4o、Claude 3.5、Gemini 1.5 等)的系统排名。
输出与应用
- 产出 16 条实证发现,其中包括:动态基准仍存在污染的原因是许多“新”声明可通过截止日期前公开的多个知识片段合成验证;污染对“Not Enough Info”类别影响最为显著,因为 LLM 倾向于依赖内部知识而拒绝承认证据不足。
- 基于去污后的测试集,对 SOTA LLM 进行重新评测,提供更可信的 MAFC 能力报告。
跟同类方法的差异:以往工作假定知识截止日期后的声明自动无污染,本研究首次系统展示了该假设的脆弱性,并提出了一套可操作的污染检测与受控评估框架,为构建可信的 MAFC 评测基准提供了实用指南。
实验
实验设计
研究围绕四个研究问题 (RQ) 展开:
- RQ1: 检测静态基准 AVeriTeC 与自建的动态基准 ClaimReview2025Q4 中声明的污染程度,其中动态基准的声明发表于主流 LLM 知识截止日期之后。
- RQ2: 分析污染成因,判断新声明是否可通过截止日期前的公开知识合成来验证。
- RQ3: 量化污染对 MAFC 评估指标与系统排名的影响。
- RQ4: 在严格污染控制条件下重新评估 SOTA LLM,建立可信基线。 实验采用统一的污染检测流水线:利用 LLM 内部知识判断声明是否无需外部证据即可验证,并结合人工标注验证。
关键发现
- 污染并非动态即可消除: 即便在动态基准中,仍有 17.09%–29.30% 的声明潜在污染,仅依靠时间截止无法完全隔离。
- 污染根因是知识可合成性: 许多新声明可由截止日期前的多条分散的公共知识推理合成,而非单一记忆。
- 性能膨胀显著: 污染导致 Macro-F1 最高膨胀 11.34 点,并扭曲系统排名,使某些模型获得不公正的优势。
- 受控评估揭示真实能力: 在剔除污染声明后,SOTA LLM 的性能普遍下降,排名发生实质变化,原基准的“最优”模型可能不再领先。
与基线对比及解读
传统静态基准 (如 AVeriTeC) 因包含大量可被 LLM 内化知识直接验证的旧声明,导致评测结果高估模型能力。动态基准降低但仍未根除污染,凸显仅靠时间戳策略的局限。真正可信的 MAFC 评估需结合声明知识可合成性检测与严格的污染控制。这一发现对构建下一代基准具有指导意义:不能仅依赖发布日期,而应针对每条声明的证据独立性进行过滤,从而获得更真实的模型排名。
行业影响
落地场景
该工作直接服务于多模态自动事实核查 (MAFC) 系统的研发与部署,可嵌入到内容安全、信息可信度评估等产品线:
- 社交/内容平台:自动识别图文帖子的不实信息,减少人工审核工作量;动态基准可驱动模型持续适应新出现的谣言。
- 新闻聚合与搜索引擎:为用户搜索结果提供“声明真实性”标记,增强信息透明度。
- 企业品牌与舆情监控:针对品牌相关的虚假声明进行快速响应,降低声誉风险。
- 电商合规:自动核对商品描述中的宣传话术与外部证据是否一致,提前拦截违规内容。
商业价值
- 降本:污染受控的评估帮助选择真正可靠的模型,避免因评估误导而部署高维护成本的脆弱系统;动态基准的采集与检测流程可自动化,减少人工构造数据集的成本。
- 增收/体验提升:更可信的事实核查结果能提升平台公信力,增加用户粘性与广告主信任;在电商场景中,减少虚假宣传纠纷可降低退换货率与客服负担。
- 风险控制:识别并消除静态基准的内部知识污染,防止模型依赖过时信息做出错误判断,降低因虚假信息传播导致的监管与法律风险。
与现有产品/工作流的接口
该研究提供的污染检测流水线与动态基准构建指南可直接集成到现有 MLOps 栈:
- 评估阶段:在模型上线前,用
Contamination Detection Pipeline扫描待评测的数据集,剔除或标记潜在污染样本,获得更真实的性能预估。 - 数据飞轮:周期性采集知识截止日期后的新声明(如通过 Google Fact Check Tools API),自动构建动态基准,持续监控模型退化情况。
- 证据增强:结合检索增强生成 (RAG) 架构,将污染检测作为证据重组的前置步骤,引导模型优先使用外部新鲜证据而非内部记忆,提升核查的事实一致性。
具体落地用例
- 社交媒体事实核查扩展:Twitter/X 社区笔记机制可引入该评估框架,确保贡献的笔记模型在无污染测试集上公平比较,防止系统排名被内部知识误导。例如,若某 LLaMA 变体在 AVeriTeC 上 Macro-F1 虚高 11 个点,实际部署后召回率可能大幅下降,动态检测可提前暴露问题。
- 医疗健康信息辟谣:公共卫生机构发布新研究后,相关 claims 可能已被预训练数据污染。用该方法构造“严格污染受控”的评估集,选择真正需要外部文献支持的核查模型,避免模型仅靠过时的预训练知识给出不可靠的医学声明判定。
局限
- **污染检测方法依赖 LLM 质量**:本文的污染检测依赖 LLM 生成证据并评估可验证性,但不同 LLM 的偏差和能力差异会引入系统误差。尽管作者采用多数投票和多种模型集成以降低单点失效风险,但对于需要复杂多模态推理的声明,检测准确率仍然受限。此外,污染边界的定义(基于 LLM 的“内部知识”截止日期)本身就存在模糊性,这使得污染标签的客观性难以完全保证,可能影响后续定量分析的严谨性。
- **数据与时间范围的局限**:动态基准 **ClaimReview2025Q4** 仅覆盖 2025 年第四季度的声明,样本量和时间跨度都较为有限。污染风险可能随知识截止日期后的时间推移而呈现非单调变化,短期快照无法刻画完整趋势。同时,基准源自单一事实核查聚合平台(ClaimReview),领域和来源多样性不足,结论向其他类型声明(如社交媒体多模态帖子)的泛化能力存疑。
- **评估生态与系统泛化性**:实验主要在少数高性能 LLM(如 GPT-4o、Gemini)上进行,未覆盖参数量较小的模型或专门设计的 MAFC 系统,也未分析不同检索策略对污染的交互影响。严格的污染控制评估通过剔除含污染声明来实现,但这可能非均匀地改变基准难度分布,引入选择偏差,从而影响模型排名的可比性。此外,缺乏对在线更新场景的讨论,使指导原则在持续变化的真实部署环境中的实用性有待进一步验证。