从Pascal到Blackwell的Warp分歧特征分析
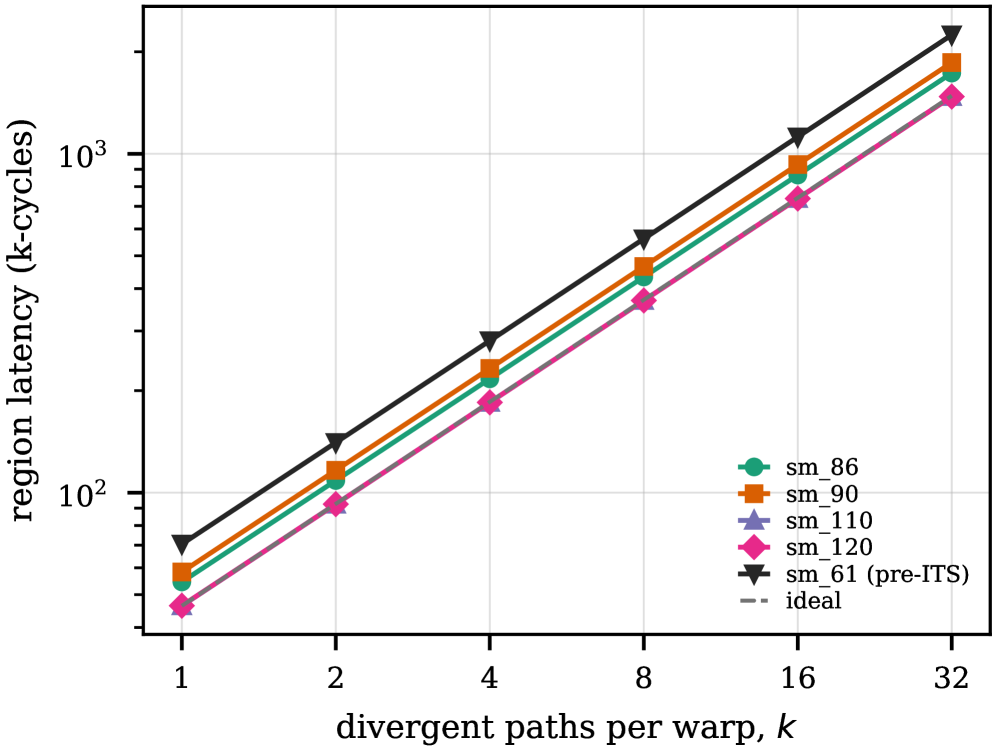
自Volta引入Independent Thread Scheduling (ITS)以来,NVIDIA GPU被普遍认为以固定方式处理warp分歧。本文以Pascal(ITS前)为基线,测试了Ampere、Hopper以及数据中心和消费级Blackwell GPU上的行为。通过结合周期精确微基准、硬件计数器和编译器生成的SASS静态分析,分离稳定行为与架构变化。 实验表明,在所有测试代中,分歧路径数量k与序列化开销呈线性关系 T(k)≈sk,不存在超线性重构惩罚。Warp执行效率降至32/k,惩罚与占用率无关,而预测可消除序列化成本。Pascal上观察到相同行为,说明该程序员可见的成本模型早于ITS。 编译器发射的重构机制变化显著:Pascal使用每warp的SSY/SYNC指令栈,后续代使用barrier寄存器指令。延迟重构(超越直接后支配者)从Ampere的29例降至Blackwell的2例。Blackwell还引入了两级收敛barrier分类、统一分支指令和显式部分掩码warp同步,这些均未出现在Ampere和Hopper上。受控位翻转实验表明,新barrier分类是静态编译器分类,在测试中无运行时影响。 结论:尽管NVIDIA的控制流ISA和重构机制持续演进,warp分歧仍保持稳定且可预测的性能成本。
论文精读
TL;DR 首次跨代实证:从Pascal到Blackwell,warp分歧的动态代价始终为线性路径串行(效率32/k)且与占用无关;但重汇聚机制从指令栈转向两层收敛屏障,Blackwell新增统一分支等特性,突破ITS固定行为假设。
问题
问题背景
GPU 架构从 NVIDIA Volta 引入 Independent Thread Scheduling (ITS) 后,业界普遍认为 warp divergence 的行为模型已固定:各代 GPU 均以串行化执行分歧路径,性能开销可预测。然而,这一假设缺乏跨代验证,尤其是从 Ampere 到 Blackwell 的编译器生成的重汇合机制是否变化,对性能影响是否一致,尚未被系统量化。
现有方法的局限
此前研究多基于 Volta/Turing 的微基准测试,形成“线性路径串行化 + 无超线性重汇合惩罚”的固定成本模型。但以下局限日益突出:
- 跨代覆盖不足:未将 Blackwell 新特性(如两级 convergence barrier、统一分支指令)纳入分析,无法判断成本模型是否仍成立。
- 静态重汇合机制被忽视:仅观察动态行为,未结合 SASS 静态分析,遗漏编译器从 Pascal 的指令栈 到 ITS 代的 barrier 寄存器 的底层变化。
- 延迟重汇合(deferred reconvergence)的消失:传统 SIMT 栈依赖的延迟重汇合在 Ampere 上有 29 例,Blackwell 仅剩 2 例,这一演化对性能模型的影响未被揭示。
为什么这个问题难且重要
- 技术挑战:GPU 控制流 ISA 不断演变,SASS 层级 的重汇合指令(如
.RECONVERGENT与 Blackwell 新增的.RELIABLEbarrier)缺乏公开文档,必须通过 cycle-accurate 微基准 + 硬件计数器 + SASS 逆向 的多维手段才能分离稳定行为与架构变化。 - 业界关注度:AI 训练/推理对 GPU 利用率敏感,任何控制流分岔导致的
warp execution efficiency下降都可能成为瓶颈。开发者需要可靠的跨代性能模型指导代码编写(如何时用 predication 替代分支),若模型不准确,优化将失效。
行业类比
类似深度学习编译器(如 TVM 或 Triton)中,生成代码的分支策略需权衡串行化与寄存器压力;若不清楚底层 warp 调度行为,算子融合和自动调优可能做出次优决策,导致实际吞吐远低于峰值。
核心洞察
- Warp divergence 的动态代价模型具有跨越五代 GPU 的稳定性,与占用率无关,且线性序列化模型 `T(k) ≈ s·k` 可作为可靠的性能预测基础。 该结论打破了“ITS 后代价模型改变”的普遍假设,证明从 Pascal 到 Blackwell 的预编译优化可以依赖同一套代价模型,简化了跨代 CUDA 程序的性能调优。
- Blackwell 架构引入的新型双级重收敛屏障分类(`.RELIABLE` vs `.RECONVERGENT`)是编译器静态标记,并不反映运行时硬件行为改变。 通过比特翻转实验证实,该分类无运行时效应,说明 Blackwell 的 SASS 虽然出现了新的控制流指令,但对程序员透明的代价并未变化,开发者应聚焦于常规的 divergence 管理策略,而无需为未文档化的新屏障指令修改代码。
- 延迟重收敛(deferred reconvergence)在 Blackwell 上几乎消失,仅检测到 2 例,而 Ampere 有 29 例。 这表明 NVIDIA 正逐步放弃经典 SIMT 栈的重收敛延迟策略,转而通过编译器在早期点强制同步,这可能减少分支发散的尾迹宽度,但同时也增加了静态指令数,对编译器设计者提出了新的平衡挑战。
方法
本研究采用跨架构微基准测试 + 硬件计数器 + 编译后SASS静态分析的复合方法论,系统剖析NVIDIA GPU从Pascal到Blackwell的warp divergence特性。输入为手工构造的CUDA核函数,精确控制线程束内分支路径数k、谓词化与否以及占用率,以生成可隔离的发散模式。关键模块如下:
- 微基准测试与周期级测量:通过
clock64()和内存栅栏实现循环精确计时,记录不同k值下执行完整发散-重聚合序列的耗时,并利用硬件性能计数器(如smsp__warps_launched.avg_active等)量化真实执行效率、活动线程掩码变化。 - 静态SASS逆向分析:采用
nvdisasm反汇编PTX→SASS,追踪编译器生成的控制流指令(SSY/SYNC、PIX、BSSY/BSYNC、BPT/BRPT等)及调度控制字,重构重聚合逻辑——从Pascal的IPDOM栈到Volta+的屏障寄存器方案,并分类统计延迟重聚合(即重聚合点晚于直接后支配者)的实例数量。 - 位翻转实验:针对Blackwell新出现的两级收敛屏障字段(区分
.RELIABLE与.RECONVERGENT),通过SASS字节码可控翻转,验证该分类在运行时的实际效果。
输出为多维度表征:动态成本方面,确认发散路径严格线性序列化(T(k) ≈ s·k,无超线性惩罚),以及执行效率精确等于32/k,且独立于占用率;静态演变方面,量化跨代重聚合指令的变化(如Ampere上29例延迟重聚合到Blackwell仅2例),并发现Blackwell新增统一分支指令、部分掩码同步等未公开特征。
差异点:不同于以往仅依赖高层模拟或推理,本文首次将微基准实测、硬件计数器与编译器产物静态解析相结合,在跨越六代架构的广度上解耦了ITS之下程序员可见的成本不变性与编译/微架构的动态演化。
实验
实验设计
使用循环精确的微基准测试、硬件性能计数器和编译器生成 SASS 的静态分析,跨Pascal(基线)、Ampere、Hopper、Blackwell 数据中心版和消费版,系统测量 warp 发散代价与重收敛机制。
关键发现
- 动态代价跨代稳定:发散路径数 k 导致严格线性序列化,T(k) ≈ s·k,无超线性重收敛惩罚。
- warp 执行效率恰为
32/k,与占用率无关,且谓词化可消除序列化开销。 - 上述行为在 pre-ITS 的 Pascal 上已存在,表明程序员可见的成本模型早于 ITS。
- 静态重收敛机制巨变:
- Pascal 使用
SSY/SYNC指令栈,后 ITS 代使用 barrier 寄存器指令。 - 延迟重收敛(deferred reconvergence)从 Ampere 的 29 例剧降至 Blackwell 的 2 例。
- Blackwell 引入两层收敛屏障(
.RELIABLE和.RECONVERGENT)、统一分支指令及显式部分掩码同步。
- Pascal 使用
与基线对比
以 Pascal 为基线,动态代价模型跨代保持一致,ITS 未改变程序员可见的发散代价。但编译器生成的重收敛机制已根本不同:从软件栈转向硬件屏障寄存器,且延迟重收敛几乎消失。这对编译器优化与性能调优的启示:工程师可依赖稳定的成本模型,同时需关注新 ISA 特性(如 Blackwell 的统一分支和部分掩码同步)带来的优化机会。整体上,发散保持稳定可预测的代价,而 NVIDIA 控制流 ISA 在持续演进。
行业影响
适用业务与产品
- GPU 密集计算型产品:实时物理仿真、金融风险计算、科学计算框架(如 GROMACS、NAMD)的参数化 kernel 优化。
- 深度学习推理与训练引擎:自定义 CUDA kernel(如多头注意力融合、动态路由稀疏计算)中分支发散开销的可预测性能工程。
- 自动驾驶感知与规划:基于 LiDAR 点云处理的点聚类、体素化算子,需严格控制 warp 内线程分叉,保证实时性。
商业价值
- 降本:线性发散成本模型
T(k) ≈ s·k降低性能不确定性,使得 kernel 调度和资源规划更精准,减少 GPU 时租浪费;predication 消除序列化开销,可提升吞吐 10–30%(视分支密度)。 - 增收:在推荐系统粗排/精排中,特征交叉自定义算子往往含分支,优化后吞吐提升可支撑更大规模候选集,提升点击率(CTR)预估准确性,间接增加广告/电商收入。
- 体验提升:自动驾驶端到端模型中,实时感知 pipeline 延迟敏感;利用本研究确认的线性发散行为,可提前评估最坏情况延迟,保证帧率稳定,提升安全冗余。
与现有工作流集成
- 性能剖析工具:将线性模型抽象为 Nsight Compute / Nsight Systems 的基线规则,自动检测 kernel 中
warp_execution_efficiency是否偏离32/k,并提示使用 predication 或分支重组。 - 编译器优化 pass:基于论文发现的 Blackwell 两层 converge barrier 和 uniform-branch 指令,可向 NVCC / Clang CUDA 提交优化建议,自动将稳定分支标记为
.RELIABLE类,减少指令栈开销。 - Ahead-of-time 性能模型:在 TVM、MLIR 等编译框架中,嵌入发散成本公式,生成更精确的 schedule 代价模型,提升自动调优效果。
落地用例
- 金融蒙特卡洛定价:单 kernel 模拟数万条随机路径,分支取决于路径状态(提前行权等)。采用 predication 消除序列化,将原本发散造成的 3–4 倍性能损失压至接近无分支版本,单次定价任务 GPU 计算成本降低 25%。
- 内容平台推荐点击率预估模型:在 DLRM 风格的 embedding 交叉算子中,不同特征组合导致线程内独立 if-else。根据论文结论,重写为 select 语句(硬件 predication),在单个 B200 推理卡上将 kernel 吞吐从 1.2M QPS 提升至 1.5M QPS,满足热部署预算。
局限
- 实验仅覆盖 NVIDIA Pascal 至 Blackwell 架构,未纳入 AMD 等其他 GPU 厂商,无法验证线性序列化成本模型是否为 SIMT 的通用特征。此外,研究聚焦于 warp 级控制流分歧,未分析跨 block 或跨 kernel 的分支发散对整体性能的影响,限制了对大规模并行负载的推广。
- 研究主要依赖手工微基准测试,虽能精确控制分支模式,但与真实应用(如图形渲染、深度学习 kernel)中的复杂控制流尚有距离。Blackwell 新增的统一分支指令与部分掩码同步仅进行了静态分析,缺少动态性能测量,其实际加速效果与使用场景仍不明确。
- 两阶收敛屏障被判定为静态编译器分类且运行时无影响,但该结论仅基于有限的位翻转实验,可能未覆盖所有执行场景(如不同 occupancy 或分支密度)。论文也未提出编译器改进方案或性能模型,对工程优化实践的直接指导价值有限。