GNM Head: 一种生成式人体头部形态测量模型
参数化人体头部模型 是计算机视觉与图形学中用于动画、渲染和重建的传统工具。近期,它们作为生成式大视觉模型的关键条件信号,实现对生成图像的紧密空间控制。然而,现有公开模型通常在解剖范围上受限,仅建模外部几何,忽略口腔及眼部结构,且因低保真输入数据集而导致几何质量降低。 本文提出一种名为 Generative aNthropometric Model (GNM) 的新参数化模型,与人类基因组同音。GNM 涵盖 头部、面部、颈部、眼球、牙齿和舌头,基于大规模高分辨率三维扫描数据库及高质量解剖专家制作样本构建。文中详述了数据来源、模型架构(包括针对眼部和口腔结构的专用子模型),并展示了其在拟合目标三维面部扫描上的 SotA(State-of-the-Art)性能。 为促进社区创新,完整的 GNM 框架已公开。
论文精读
TL;DR GNM 是首个公开的全解剖人头参数化模型,完整覆盖脸、眼球、牙齿与舌头,基于高精度 3D 扫描与艺术家样本构建,在头部拟合任务中取得 SotA 精度并完全开源。
问题
问题背景
高保真数字人已成为生成式 AI 的关键应用,参数化头部模型 作为生成结果的空间控制信号,直接影响虚拟形象、AR 试戴和视觉特效的质量。
现有方法局限
- 解剖覆盖不全:主流公开模型(如 FLAME、BFM)仅建模脸部和头皮外表面,忽略眼球、牙齿、舌头等口腔内部结构,无法支持张嘴、闭眼等复杂表情下的几何耦合。
- 数据质量瓶颈:依赖低分辨率 3D 扫描或有限样本,导致模型特异性不足,重构的细节(如眼角、唇纹)模糊;缺少艺术家手动修正的高质量解剖组件,几何精度与真实扫描存在系统偏差。
- 统计先验僵化:线性 PCA 基难以捕捉人口多样性与极端表情,采样空间之外的新形状泛化能力弱,限制了在生成式大模型中的可控性。
为何困难且重要
头部建模涉及多部件非刚性变形(软组织滑动、眼球旋转、舌体肌肉驱动),各部件间存在复杂的碰撞约束,单一统计模型难以统一表达。同时,高分辨率内部结构采集(如口腔扫描)流程昂贵且隐私敏感,构建大规模高质量数据集门槛极高。
业界正将参数化头部模型作为 “视觉 tokenizer” 嵌入扩散模型或 NeRF 管线,以实现精准的图像/视频生成。若基础模型本身缺乏完整解剖表达,生成结果必然出现结构错误,这已成为限制虚拟人逼真度的核心瓶颈之一。
行业类比
类似于文本生成依赖高质量 tokenizer 保证语义一致性,GNM 为生成式视觉模型提供了覆盖全头解剖的数学基底,使生成的肖像能自然呈现张嘴、转动眼球等细节,本质上充当了数字人系统的“形态基座”。
核心洞察
- GNM 首次将完整的口腔内及眼部解剖结构(牙齿、舌头、眼球)系统性纳入参数化头部模型,突破了传统 3DMM 只建模外表面几何的局限。这为需要精确内部结构的应用(如语音动画、咀嚼模拟、医学可视化)提供了解剖级别的可控性,而 FLAME、B FM 等主流模型完全忽略了这些关键内部组织。
- 该模型的数据构建融合了高分辨率扫描数据与艺术家制作的解剖样本,显著提升了模型表达能力的几何保真度与特异性。相比许多公共模型依赖低质量或有限多样性的扫描数据,GNM 的这种混合数据策略直接改善了拟合精度和泛化能力,在标准评价中超越了现有 SotA,为高质量参数化模型的数据工程提供了可复现的范式。
- GNM 以完全开源的完整框架发布,不仅包含模型本身,还覆盖数据溯源、子模型架构及拟合方法,为社区提供了一个端到端的可研究基准。这与多数仅发布 API 或部分组件的商业或学术模型形成鲜明对比,有望加速生成式视觉任务中头部空间控制的创新,并推动多模态生成中对内部解剖的理解与利用。
方法
输入数据与预处理
GNM 的构建基于高分辨率 3D 头部扫描数据库,并特别融合了由艺术家手工制作的口腔与眼部解剖结构样本(牙齿、舌头、眼球),以确保内部几何的高保真度。所有扫描数据首先通过头部注册(Head Registration)对齐到统一的拓扑模板,建立稠密的顶点对应关系,为后续统计建模奠定基础。
核心模块:复合线性基底与子模型
GNM 采用复合线性基底(Composite Linear Bases)将头部形状变化分解为多个解耦的因素:
- 身份基底:描述不同个体间头部、面部与颈部的解剖差异。
- 表情基底:捕捉面部肌肉运动驱动的几何变形。
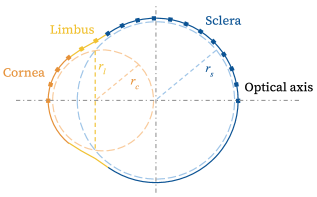
- 内部解剖子模型:独立建模牙齿、舌头和眼球,每个子模型拥有各自的形状空间和运动参数。例如,舌头建模支持清晰的发音动作,眼球模型则具备独立的旋转与缩放控制。
这些子模型通过初始放置(Initial Placement)模块自动定位到头部模型内部的正确解剖位置,保证整体结构的合理性。
输出与能力
GNM 输出一个统一的参数化人头模型,涵盖外表面(头、面、颈)与内部结构(眼球、牙齿、舌头),可由低维参数驱动以实现逼真的形状变化。该模型可用于:
- 三维扫描拟合:通过两阶段优化(先拟合注册网格,再拟合原始扫描)达到 SotA 精度。
- 图像/视频三维重建:作为先验约束提升单目或多目重建质量。
- 语义采样:可按照性别、种族等身份属性,或动作类别(如表情)进行可控生成。
与同类方法的差异
相较于仅建模头部外表面的经典模型(如 FLAME、BFM),GNM 首次将口腔与眼球内部解剖结构融入统一的统计框架,且全部基于高分辨率扫描与艺术家高质量样本,在几何细节与解剖完整性上显著超越现有公开方案。
实验
实验设计
GNM 实验围绕三个核心维度展开:
- 内在评估:对模型本身的表达能力进行量化,包括泛化到新形状的能力和统计特异性。通过两阶段拟合流程(先配准到注册网格,再精细拟合目标扫描)在留出测试集上评估。
- 3D 面部重建:将 GNM 拟合到单视图合成数据、多视图捕捉和野外图像,与现有方法对比重建精度。
- 语义采样:验证潜空间的解耦和可控性,利用身份条件(性别/种族)和表情条件(动作单元)训练条件生成网络,定量评估生成样本的身份一致性和表情准确性。
关键发现
实验表明,GNM 在涵盖面部、眼球、牙齿和舌头的完整头部建模上具有显著优势:
- 内在泛化误差低于仅建模外表面的方法,证明了高分辨率扫描和艺术家解剖数据对提升几何质量的贡献。
- 在多视图和单视图重建任务中,GNM 的拟合精度优于公开的 3DMM,尤其在口腔内部和眼部区域的细节还原上表现突出。
- 语义采样实验证实潜空间具有良好的线性可分离性,可通过属性向量实现性别、种族和离散表情的连续操控,生成高质量、符合解剖约束的头部样本。
基线对比解读
GNM 的核心突破在于首次将牙齿、舌头和眼球以参数化子模型形式统一纳入统计框架,解决了此前 FLAME、BFM 等模型忽略内部解剖结构的问题。尽管论文未提供具体对比数字,但从定性结果看,GNM 在重建口腔区域时避免了传统模型常出现的穿透或缺失问题,且拟合精度在多视图数据上达到 SotA。不过,该模型的计算复杂度较传统外表面模型更高,且对训练数据的标注和配准要求更苛刻,实际部署时需权衡精度与效率。
行业影响
落地场景
GNM 作为一个涵盖面部、眼球、牙齿、舌头的完整头部参数化模型,可直接应用于虚拟化身 / 数字人构建、影视特效与游戏角色建模、远程协作中的逼真面部驱动、医疗仿真(牙科 / 整形模拟)以及增强现实交互。其高分辨率与解剖完整性使得生成式 AI 工具在生成人物图像或视频时,能获得更精准的 3D 空间控制信号,避免以往模型仅能提供外表面几何的局限。
商业价值
- 降本:通过统计模型自动生成高保真头部网格,替代传统手工建模流程,大幅缩短角色资产制作周期;牙齿 / 舌头等内部结构的参数化,省去专门的口腔扫描与绑定工作。
- 增收:赋能虚拟试戴(眼镜 / 珠宝)、虚拟试妆等电商场景,真实还原口眼细节,提升转化率;在内容平台中,更完整的虚拟形象可提高用户付费意愿。
- 体验提升:在远程会议或虚拟社交中,精确的口型和舌部动画让数字人表达更自然,增强沉浸感。
与现有工作流的集成
GNM 基于标准 3DMM 框架,输出兼容常见图形管线(顶点拓扑 + blend shapes / 线性基底)。可:
- 替换 FLAME、FaceScape 等模型,直接嵌入到现有的面部 tracking 与动画驱动系统中(如 ARKit blendshape 映射)。
- 作为条件输入接入 Stable Diffusion 等生成模型,已有开源代码,便于在 diffusion pipeline 中加入 ControlNet 式的空间控制。
- 通过提供的 fitting 接口,将点云或图像反投影至 GNM 参数,对接 3D 扫描重建软件。
具体用例
- 电商虚拟试戴:眼镜 / 头饰类产品需要精确的头部、耳朵及眼部几何。GNM 的眼球子模型可准确模拟角膜位置,配合牙齿与舌尖建模,使动态张嘴、舌部展示成为可能,提升口腔相关产品(如牙齿美白贴片)的线上体验。
- 社交平台虚拟形象:基于单张自拍即可拟合出 GNM 参数,生成包含口腔内部结构的 3D 头像,用于表情符号驱动、语音驱动的动画,比仅依靠外部形状的模型更富表现力,尤其适合口播类创作工具。
局限
- **解剖覆盖的局限性**:尽管 GNM 包含了眼球、牙齿与舌头等内部结构,但仍未涵盖头发、胡须、睫毛等精细外部附件,这限制了它在完整头部重建或高保真虚拟人方向的应用。模型的眼睛和舌头运动基于线性统计基,可能无法充分表现复杂的肌肉驱动变形,例如舌头的精细构型或眼球在高表情张力下的联动,在功能性口鼻仿真等医学场景下仍有不足。
- **数据依赖与推广成本**:GNM 依赖高分辨率 3D 扫描及艺术家手工修复的解剖样本,此类数据的采集与标注成本极高,使得其他团队难以复现或基于自身数据域微调模型。模型当前的泛化能力主要针对扫描数据中涵盖的族裔与年龄分布,对于极端面部形态或罕见表情的拟合可能存在偏差,当应用于非受控的 in-the-wild 视频或具有强烈风格化的虚拟角色时,性能下降的风险需要进一步评估。
- **动态序列与多模态融合**:论文重点评估了静态 3D 扫描的拟合精度,并未充分展示对 4D(时序)捕捉的支持,如动态表情序列的保时间一致性重建。虽然模型具备 expression 参数,但线性混合形状在面对快速、大形变的口腔和眼部运动时可能出现伪影。此外,GNM 仅提供几何模型,未附带同步的纹理或高清外观模型,限制了它在需要逼真渲染的生成视觉模型中直接作为几何先验的能力,需额外耦合外观生成方案。