UltraViT: 面向大型视觉语言模型的延迟优化设备端视觉编码器
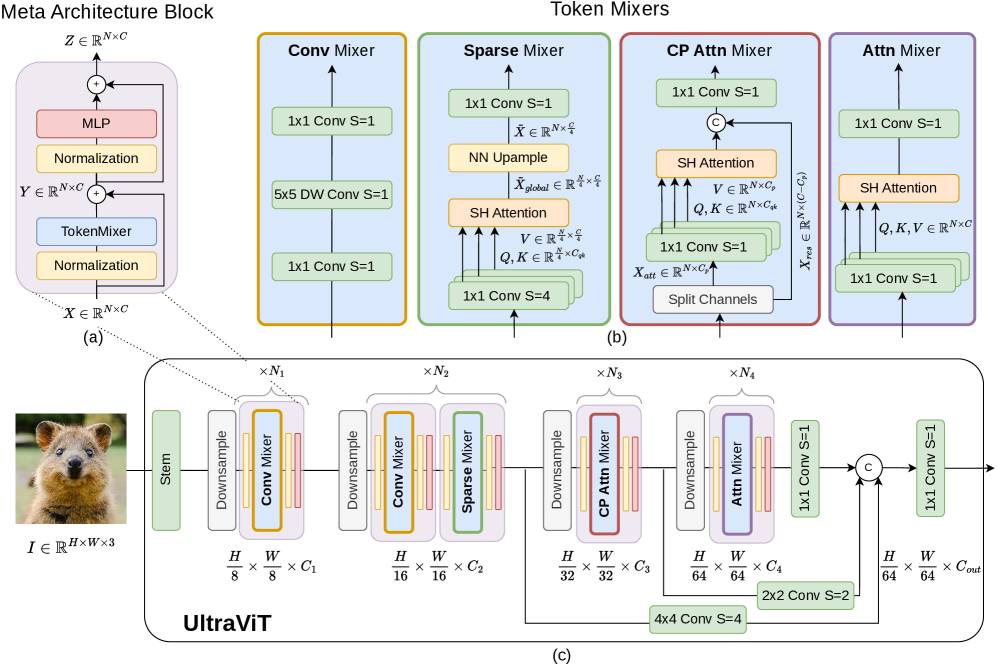
大型视觉语言模型(LVLMs)因巨大的计算开销而难以部署在资源受限的边缘设备上。现有压缩工作主要聚焦于视觉令牌减少或小型语言模型,但视觉编码器通常被忽视,仍作为庞大的特征提取器被直接使用。此外,尚无工作针对设备端延迟直接优化LVLM的视觉编码器。 本文提出UltraViT,一种专为设备端性能设计的视觉编码器。我们基于真实设备端延迟,系统性地设计了金字塔架构,在宏块级别策略性地集成和适配异构的空间混合器。为预训练UltraViT,我们提出新颖的两阶段生成式预训练策略:第一阶段通过密集蒸馏培养丰富的空间特征,第二阶段使用容量混合的冻结大语言模型进行直接生成式监督。与标准的对比学习和自监督学习相比,我们的预训练能更有效地为UltraViT实现高层语义基础,从而支持后续LVLM训练的生成式多模态对齐。 大量实验表明,我们的设备端延迟感知设计结合定制训练策略在高效LVLM编码方面达到了新高度,显著优于现有基于编码器的基线方法,同时设备端速度提升近1.7倍。
论文精读
TL;DR UltraViT 是首个专为端侧延迟优化的 LVLM 视觉编码器,通过异构空间混合器和生成式预训练,实现 1.7 倍端侧加速与 SOTA 性能。
问题
问题背景
大型视觉语言模型 (LVLMs) 在多模态理解上取得显著进展,但端侧部署仍受限于巨大的计算开销。当前研究主要聚焦于视觉 token 压缩或语言模型小型化,以降低整体推理成本。
现有方法局限
- 视觉编码器被忽视:多数工作将视觉编码器视为固定的、计算密集的特征提取器,直接沿用预训练 ViT 等通用架构,未针对 LVLM 多模态对齐与端侧延迟进行优化。
- 缺乏延迟感知设计:现有高效编码器如 FastViT、EfficientViT 未考虑真实设备上的异构算子延迟(如 Depthwise 卷积在高通 GPU 上比 MobileNet 慢 3 倍),且其预训练目标(分类、自监督)与 LVLM 的生成式多模态对齐目标不匹配,导致语义基座劣化。
为何该问题重要且困难
- 端侧延迟是真实瓶颈:视觉编码器在 LVLM 推理中占总延迟的 40-60%,若无法从硬件-算法联合层面优化,端侧多模态交互(如实时问答、拍照识物)将难以实用。
- 多目标权衡复杂:需同时满足低延迟、高分辨率保持、多尺度特征提供、异构计算单元高效利用,且要保持与冻结 LLM 的生成式语义对齐——这要求自顶向下的架构搜索与定制预训练策略。
- 业界高度关注:随着设备端 AI 芯片(如移动 GPU、NPU)普及,直接在端侧运行 LVLM 可保护隐私、降低云成本,成为手机/ IoT 厂商的核心竞争点。
行业类比
如同 MobileNet 对移动视觉识别带来的质变,LVLM 领域需要一种原生端侧可视编码器——打通从延迟感知架构设计到多模态生成式预训练的全链路优化。
核心洞察
- 设备端延迟直接作为视觉编码器架构搜索的优化目标,而非事后适配。UltraViT 在设计阶段即测量并模拟真实硬件延迟,以此指导金字塔结构与异构空间混合器(卷积、局部/全局注意力)的宏块级选择,形成专门为边缘设备定制的高效编码器。这不同于以往仅关注理论 FLOPs 或参数量的压缩方法,也区别于忽略视觉编码器、只压缩语言模型或 token 数量的方案,直接在物理约束下实现了精度与速度的均衡。
- 针对 LVLM 任务定制的两阶段生成式预训练,比通用对比学习或自监督方法更能赋予视觉编码器所需的语义基础。第一阶段通过密集蒸馏从大教师模型迁移丰富的空间特征,第二阶段使用容量混合的冻结 LLM 进行生成式监督,直接对齐视觉与语言模态。与 CLIP 等仅提供图像级对齐的预训练相比,该策略更好地保留了密集视觉细节并建立了高层语义联系,显著提升了后续多模态对齐的效率与效果,证明了 LVLM 视觉编码器的预训练应当与下游生成任务紧密耦合。
方法
UltraViT 方法围绕 延迟感知架构设计 与 生成式预训练 两大核心展开,输入为原始图像,输出为适配大视觉语言模型 (LVLM) 的高效视觉特征序列。
延迟感知的异构混合器架构
- 以 真实设备端延迟 为导向,采用金字塔层级结构,将网络划分为多个宏块 (macro-block)。
- 在每个宏块中,通过 块选择过程 动态集成 异构空间混合器,例如将轻量卷积与高效注意力机制按延迟-精度权衡进行组合,替代单一的重型操作。
- 这种 异构混合 设计打破了传统 ViT 用同构 Transformer 块的惯例,允许不同层根据其在特征金字塔中的位置选用最优局部或全局上下文建模算子。
两阶段生成式预训练
传统的对比预训练 (如 CLIP) 难以直接为 LVLM 的生成式对齐提供足够的高层语义基础,因此 UltraViT 采用新策略:
- 密集蒸馏 (Dense Distillation):第一阶段用大型预训练视觉模型作为教师,通过蒸馏损失让 UltraViT 学习稠密、丰富的空间特征表达,捕获细粒度视觉线索。
- 生成式预训练 (Generative Pre-training):第二阶段将 UltraViT 与一个 容量混合的冻结 LLM 连接,直接用语言生成任务(如图片描述)进行监督。该 LLM 可能混合不同容量分支,以平衡效率与指导能力。此步骤让视觉编码器直接学会生成 LLM 可理解的语义 token,省略了中间对齐层带来的额外开销。
整个流程输出的特征可直接送入后续 LVLM 的投影层与 LLM,实现端到端高效推理。
与同类方法的差异:现有工作多聚焦于压缩视觉 token 数量或缩小 LLM,而 UltraViT 是首个直接为设备端延迟优化视觉编码器架构及其预训练范式的方法,并通过生成式预训练替代传统对比学习,从根本上提升了视觉特征在 LVLM 中的语义可接性。
实验
实验设计从端侧设备真实延迟数据出发,构建了金字塔架构的视觉编码器,在 macro‑block 级别动态组合异构空间混合器(如窗口注意力、深度可分离卷积等)。对比基线涵盖现有高效视觉编码器(如 CLIP‑based 变体)以及 token 压缩方法。预训练采用两阶段策略:密集蒸馏培养局部细节与空间特征,再用容量混合的冻结 LLM 提供生成式语义监督;实验表明该方法在后续 LVLM 对齐训练中,语义锚定效果远超标准对比学习与自监督。
关键发现:UltraViT 在端侧设备上推理速度提升至 1.7 倍,同时在下游多模态任务上显著优于同计算量级的视觉编码器。这验证了基于实测时延的架构设计比单纯减少 token 或缩放语言模型更有效,也说明视觉编码器的效率是整个 LVLM 系统的瓶颈,需从软硬件协同视角优化。
相较于 token 减少方法(如 FastV、PruMerge),UltraViT 不损失 token 数量,而是通过细粒度计算分配保持表征完整性,从而在速度与准确率之间取得更优平衡,为端侧 LVLM 部署提供了新的架构范式。
行业影响
落地场景
UltraViT 使资源受限的边缘设备能够高效运行大型视觉语言模型(LVLM),典型场景包括:
- 智能手机实时理解:拍照问答、文档 OCR、饮食记录等应用,无需云端即可在毫秒级完成视觉语义抽取。
- AR/VR 设备:在轻量级头显上实现环境感知、手势指令的即时分析,支撑无延迟的混合现实体验。
- IoT 与机器人:如家用机器人通过本地视觉编码实现物体识别、导航,降低对网络的依赖并增强隐私。
- 车载系统:在座舱内以低功耗芯片运行视觉编码,支持驾驶员监测、交通标志识别等实时任务。
商业价值
- 降本:端侧推理大幅减少云端算力需求,尤其在大规模设备部署时,可显著降低服务器带宽及推理 API 调用费用。以十亿级活跃设备计算,边际成本优势明显。
- 体验提升:延迟从秒级压缩至亚秒级(约 1.7 倍速度),并支持离线运行,保证交互流畅性,增强用户粘性。
- 隐私合规:敏感数据(如医疗影像、人脸)无需离开设备,简化隐私审计流程,降低合规风险。
- 新业务可能:可向 OEM 厂商、应用开发者提供轻量化视觉引擎,或通过模型授权、定制调优服务开拓收入来源。
与现有产品/工作流的集成
UltraViT 定位为 LVLM 的即插即用视觉编码器,可与主流轻量级语言模型(如 Phi-3、Gemma-2B、Llama-3.2)无缝嵌合。集成路径包括:
- 模型交换:直接替换现有 Pipeline 中的重编码器(例如 ViT-L),保持相同的投影层与 LLM 接口,仅需重新进行一轮多模态对齐。
- 部署框架:支持 ONNX、ExecuTorch、TensorFlow Lite 等移动端推理引擎,配合量化工具(如 INT8 或 FP16)可进一步降低耗能与内存占用。
- 开发者生态:可封装为 Hugging Face
vision_encoder或 Core ML 组件,供社区直接调用,与现有 MLLM 微调脚本(如 LLaVA、Qwen-VL)兼容。
具体落地用例
- 电商直播实时商品标签:主播在移动设备上对商品进行展示,UltraViT 驱动本地视觉编码,在视频流中实时检测商品并生成结构化标签(类别、属性),无须上云也能实现毫秒级响应,支撑实时弹幕购物推荐。此方案使中小商家无需昂贵 GPU 集群即获得智能标注能力。
- 医学影像移动初筛:基层医疗机构或家庭场景中,患者通过手机拍摄皮肤镜、眼底或 X 光片,本地模型即时给出风险分级与关键区域标注。数据全程不出设备,满足 HIPAA/GDPR 隐私要求,同时避免网络不稳定导致诊断延迟,拓展了远程医疗的可用边界。
局限
- **设备端延迟与准确度之间的权衡空间尚未充分探索。** 论文主要聚焦于端侧延迟优化,但可能牺牲了高分辨率或复杂场景下的视觉表示能力。例如,金字塔架构中异构空间混合器的组合方式依赖于特定设备的延迟测量,在其他硬件(如不同 NPU 或 DSP)上的泛化性未经验证,实际部署时可能需要重新进行架构搜索。此外,两阶段生成式预训练依赖于一个容量混合的冻结 LLM,若 LLM 架构或规模发生变化,预训练策略可能需要重新设计,增加了迁移成本。
- **与 token 缩减类方法的比较可能不公平。** 实验虽然与 FastV、TokenPacker 等方法做了对比,但这些 token 缩减方法通常能与更强大的视觉编码器配合使用,而 UltraViT 作为一个编码器替换方案,优势主要体现在自身压缩率与速度上,如果与 token 缩减技术叠加使用,增益是否明显尚不清楚。同时,评测基准主要集中在 OCR 和通用 VQA,缺少对细粒度理解、多图推理等更高阶 LVLM 能力的测试,可能无法全面反映编码器的语义表征上限。
- **训练效率与资源需求未充分披露。** 论文强调设备端推理速度,但两阶段预训练(密集蒸馏+生成式监督)可能需要大量计算资源,例如使用容量混合的 LLM 进行生成监督可能意味着多模型蒸馏,这在实际工程中的训练成本不容忽视。此外,对比实验中使用的基线视觉编码器(如 SigLIP、OpenCLIP)通常已有大规模预训练,而 UltraViT 的预训练数据规模和配比未详细说明,其在小样本或分布偏移场景下的鲁棒性也有待进一步验证。