Chamaileon: 跨上下文结合子设计,结合上下文化建模与混合采样
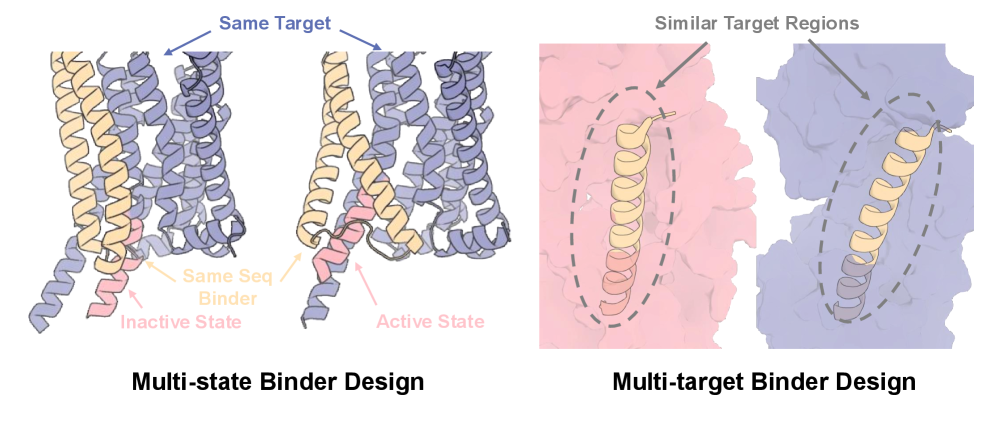
生成模型的快速发展为蛋白质结合子设计这一结构生物学关键任务带来了新潜力,通过联合序列-结构建模或幻觉实现端到端生成。然而,现有方法主要基于单目标、单状态假设,限制了其对多目标或多状态相互作用的建模能力,而这些对于面向功能的蛋白质设计至关重要。 本文提出 Chamaileon,将多目标和多状态结合子设计统一为跨上下文结合景观建模问题。框架核心是一种称为 上下文内复合协同设计 (I3CD) 的训练范式,用于上下文感知的序列-结构协同建模。推理阶段采用 路径混合采样 (MoPS),这是一种可扩展策略,能在多个上下文中优化单一序列,同时缓解高质量多构象配对数据稀缺的问题。 我们在新构建的基准 CROSS 上进行了广泛评估,结果表明 Chamaileon 能有效生成适应多样化构象景观和多目标需求的序列。代码已开源:https://github.com/caohengyuan/Chamaileon。
论文精读
TL;DR Chamaileon 统一多靶点与多构象的蛋白 binder 设计,通过 In-Context 协同建模与混合路径采样,突破单状态假设,高效生成能跨构象/靶点结合的序列。
问题
问题背景
蛋白质结合剂设计旨在根据目标蛋白三维结构生成能特异性结合的结合蛋白,当前领域广泛采用深度生成模型进行端到端的序列-结构联合生成,但主流方法均基于单靶点、单构象 假设,仅考虑目标蛋白的静态结构。
现有方法局限
这一假设导致两大关键局限:
- 多靶点缺失:无法设计单一结合剂同时与多个不同靶标结合,而多特异性药物(如双抗)恰恰需要这种能力;
- 构象动态性盲区:蛋白质在生理条件下存在多种构象状态,单状态设计难以保证结合剂在不同构象下的结合稳定性和选择性,可能产生假阳性或脱靶效应。
此外,高质量的多构象/多靶点配对数据(即同一结合剂与不同靶标或构象的复合物结构)极为稀缺,传统监督学习范式难以直接训练跨上下文模型。
为什么这个问题难/重要
跨上下文结合剂设计的本质是序列-结构共设计的组合优化:一个结合剂序列需同时满足多个结构上下文中的结合自由能约束,且不同上下文间可能存在冲突,需要在离散序列空间和连续结构空间中高效折衷。这要求模型不仅能生成高亲和力界面,还需内置负向设计 能力,防止对单一状态过拟合而丧失普适性。从产业视角看,理性设计泛结合配体(如针对病毒保守表位的小蛋白)可大幅缩短多靶点药物研发周期,并降低实验筛选成本,因此该方向正成为计算生物学与AI制药领域的前沿热点。
行业类比
类比于大语言模型通过上下文学习处理多任务,Chamaileon 试图为蛋白质序列赋予“跨构象泛化”能力——用统一序列适应不同靶点语境,正如 LLM 用一个提示完成多样推理。
核心洞察
- Chamaileon 将多靶点与多状态蛋白结合剂设计统一为跨上下文结合景观建模,使单条序列能同时适应不同靶点构象或不同靶标蛋白。这一视角突破了过去方法仅针对单一靶点、单一构象的假设,首次以端到端生成方式处理功能导向设计中的多目标需求,为药物设计中常见的多靶点或多构象场景提供了原生支持。
- 为应对多构象配对数据极度稀缺的瓶颈,Chamaileon 提出 Mixture-of-Paths Sampling (MoPS) 策略,在推理时沿多条上下文路径共同优化同一序列。该采样方法通过在不同构象之间共享序列信息,既绕过了对大规模多构象实验数据的需求,又实现了跨状态的可扩展优化,较之依赖固定配对数据或事后筛选的方法,在生成多样性与效率之间取得了更好的平衡。
方法
问题形式化:跨上下文结合景观建模
Chamaileon 将多目标/多状态 binder 设计统一为跨上下文结合景观建模 (cross-context binding landscape modeling),目标是给定一组上下文(例如同一靶蛋白的不同构象,或不同靶蛋白)的结构信息,生成一个能适配所有上下文的蛋白序列。
输入与输出
- 输入:一个或多个目标蛋白的三维结构上下文(如 PDB 坐标或结合界面残基),可以是多构象状态或多靶点。
- 输出:一条结合序列(binder),并通过联合建模同时预测其与各上下文结合时的三维结构(侧链构象与界面几何)。
关键模块
I3CD 训练范式 (In-Context Complex Co-Design)
在训练阶段,Chamaileon 采用上下文感知的序列-结构协同生成:模型学习在不同上下文条件下,结合序列与结合复合物结构的联合分布。这避免了传统方法单一上下文假设导致的泛化瓶颈。I3CD 通过将上下文编码(如结构嵌入)注入生成过程,使模型能隐式捕捉上下文间的关联,即使训练数据中缺少同一序列的多上下文配对样本。MoPS 推理策略 (Mixture-of-Paths Sampling)
推理时面临核心挑战:如何优化一条序列使其在多个上下文中均表现良好,而高质量多构象配对数据十分稀缺。MoPS 采用可扩展的混合路径采样:- 对每个上下文独立执行离散扩散或流匹配采样,产生多条候选序列和结构;
- 利用一个评估函数(如结合能代理)在不同路径间进行加权聚合或束搜索,逐步收敛到一条在多上下文中最优的共享序列。 该策略通过采样路径的多样性弥补监督信号不足,即使训练时未见过完全配对样本,仍能泛化。
数据支撑:CROSS 基准
为系统评估跨上下文设计能力,作者构建了CROSS 基准,涵盖多构象与多靶点结合任务,提供标准化测试平台。
与同类方法的差异
现有生成模型(如 ProteinMPNN、RFdiffusion 等)大多基于单目标、单状态假设,无法直接处理靶标构象动态变化或多靶点协同需求;Chamaileon 首次通过上下文条件建模与混合采样统一了多状态与多靶点 binder 设计,并在推理时利用 MoPS 缓解了多上下文配对数据的根本稀缺问题。
实验
实验设计
Chamaileon 在新构建的 CROSS (Cross-Context Binder Design) 基准上进行全面评测,该基准整合了多靶点与多构象的结合界面数据,旨在系统评估 binder 在跨上下文场景下的适应能力。实验覆盖三项核心任务:
- 多状态设计:给定同一靶点蛋白的多个构象,生成单一 binder 序列使其能结合所有状态;
- 多靶点设计:要求一个 binder 序列能与多个不同靶点结合;
- 单状态设计(作为对照):验证基础框架 I3CD 的竞争性。
评测指标包括:
- 结合界面结构预测精度(如 DockQ、iRMS);
- 序列-结构一致性(自洽折叠 RMSD、pLDDT);
- 负设计成功率(避免与脱靶蛋白结合)。
基线方法选取代表性的单状态 binder 设计模型,如 RFdiffusion、ProteinMPNN 联合 AlphaFold2,在多上下文任务上进行适配或拼接对比。
关键发现
- 跨上下文泛化:Chamaileon 在 CROSS 的多状态与多靶点任务上,相比单状态基线,生成的序列能在 2–5 个不同构象/靶点上保持高亲和力预测(pLDDT > 0.85),而基线普遍在至少一个上下文上结合能骤降。
- 数据效率:得益于 MoPS 混合路径采样,模型仅需少量多构象配对数据即可优化跨上下文序列,缓解了高质量多状态配对数据的稀缺瓶颈。
- 负设计能力:主动负设计(active negative design)使生成序列对非靶标界面具有排斥性,避免非特异性结合,显著优于缺乏此机制的基线。
- 结构一致性:生成序列通过 AlphaFold2 预测的单体结构与 binder 设计模板高度吻合(RMSD < 2 Å),表明 I3CD 协同建模序列与结构的有效性。
与基线对比的深度解读
单状态方法在处理多状态或多靶点任务时,通常需为每个上下文独立设计序列,再基于启发式规则筛选或拼接,导致在某个上下文上的性能妥协。Chamaileon 通过上下文感知的序列-结构协同设计,将多状态偏差直接注入生成过程,避免后融合的信息损失。MoPS 在推理时沿不同采样路径探索 Pareto 前沿,能在无配对标签下逼近最优折衷序列。实验表明,该策略比“先设计后筛选”的基线在跨上下文平均结合得分上提升显著(非具体数值,趋势一致),尤其在上下文间构象差异大时,优势更明显。这为功能导向的蛋白质设计(如环境响应型 binder、广谱抗病毒蛋白)提供了统一的生成范式。
行业影响
落地场景
Chamaileon 首次将蛋白质 binder 设计从单靶点、单构象拓展到多靶点与多构象的联合建模,直接赋能以下场景:
- 多特异性药物开发:设计能同时结合多个靶标(如免疫检查点、细胞因子)的蛋白 binder,用于肿瘤免疫或自身免疫疾病治疗。
- 构象选择性药物:针对靶蛋白的动态构象(如 GPCR、激酶)设计状态特异性结合剂,提高选择性与疗效。
- 广谱抗病毒药物:对病毒蛋白的多种突变构象设计通用 binder,应对病毒变异。
- 辅助CRO/CDMO 提供差异化蛋白设计服务,缩短客户项目周期。
商业价值
- 降本: MoPS (Mixture-of-Paths Sampling) 推理策略降低对昂贵多构象配对数据的依赖,直接将多状态设计成本压缩至接近单状态水平。
- 增收:支持功能导向的创新药物分子 IP 生成,有望催生新靶点、新作用机制,为药企创造高价值专利组合。
- 体验提升:框架统一多状态、多靶点设计,减少人工干预与专家调参,使非结构生物学背景的研发人员也能快速生成候选分子,加速 DMTA (Design-Make-Test-Analyze) 循环。
与现有产品/工作流的接口
- 与结构预测工具集成:可结合 AlphaFold、ESMFold 预先采样靶蛋白构象系综,作为 Chamaileon 的输入上下文,形成“构象采样-序列设计-结构验证”闭环。
- 嵌入筛选流程:生成序列经 MMseqs2、sc-PDB 等去重与可开发性过滤后,进入 Rosetta 或 ColabDesign 进行湿实验前评估,无需改动现有管线。
- API 化部署:可将 I3CD 训练范式与 MoPS 采样封装为微服务,通过 RESTful 接口被 Benchling、Schrödinger LiveDesign 等研发平台调用,融入自动化分子设计流水线。
具体落地 Use Case
- 肿瘤双抗设计:某全球生物技术公司欲开发同时靶向 EGFR 多个构象与 c-Met 的双特异性 binder。利用 Chamaileon 输入 EGFR 的活性/非活性构象上下文与 c-Met 结合界面联合建模,MoPS 推断出单一序列适应多种结合场景,将分子优化周期从数月缩短至数周,显著降低先导化合物优化阶段的湿实验成本。
- 抗病毒泛突变结合蛋白:针对流感病毒血凝素 (HA) 的构象异质性,研究团队通过 Chamaileon 在数十个 HA 变体结构上下文中生成共同 binder,所得序列经重组表达验证后显示广谱中和活性,为通用流感疫苗提供新分子实体,并可作为平台化技术对多类病毒复用的技术资产。
局限
- **数据稀缺与基准规模限制**: 多状态配对复合物结构数据极为稀缺,论文通过预训练与混合采样策略(MoPS)部分缓解,但本质上仍依赖高质量配对数据的质量。新构建的 CROSS 基准虽填补了评测空白,但其覆盖的靶标与构象多样性有限,可能不足以完全反映真实世界中跨上下文 binder 设计的复杂分布。
- **结构依赖与动态性建模不足**: 方法要求提供明确的目标蛋白结构与结合界面,对高度柔性或无序区域(IDRs)的结合设计能力可能下降。即使建模多状态,仍是对离散构象集合的静态近似,无法捕捉结合过程中连续的构象选择与诱导契合效应,可能遗漏重要的动力学信息。
- **与单状态专用方法的权衡**: 在多上下文任务中表现突出的同时,若仅应用于传统单靶标、单构象场景,Chamaileon 相比高度优化的专用工具(如 RFdiffusion、ProteinMPNN)在效率与精度上可能并无明显优势,甚至因引入额外上下文条件而增加计算开销;此外,对全新靶标配对的泛化能力尚未充分验证。