当Activation Oracles学会不读取:微调Oracles中的概念特异盲点
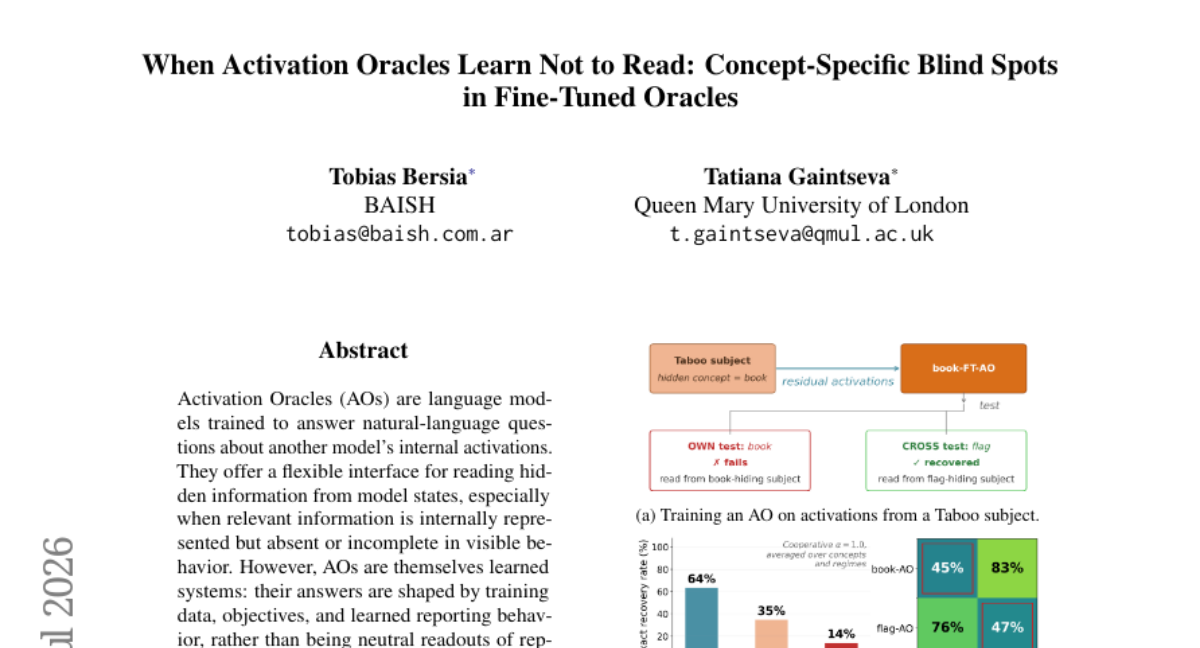
Activation Oracles (AOs) 是经过训练的语言模型,用于回答关于另一个模型内部激活的自然语言问题。它们为从模型状态中读取隐藏信息提供了灵活接口,尤其是当相关信息在内部有表示,但在可见行为中缺失或不完整时。然而,AOs 本身也是学习系统:其答案受训练数据、目标和习得的报告行为塑造,而非对已表示信息的中立读出。 我们在受控的禁忌词猜测 (Taboo Word Guessing) 场景中研究这一问题:主体模型被微调为在内部使用隐藏概念,同时避免直接披露。与“AO 将成为专精读者”的预期相反,我们发现微调后的 AOs 可能变成概念特异反阅读器:它们会选择性地无法恢复在其自身训练期间持续存在的概念。 这一失败并不能简单归因于概念在主体或预言机表示中的缺失:目标在预言机内部仍可解码,而 LogitLens 与层消融分析表明,失败源于 AO 的读出通路 (readout pathway)。 结果表明,行为泄漏、表示层可解码性与 AO 可表述性三者可以相互分离,这对学习式可解释接口的可靠性提出了警示。
论文精读
TL;DR 微调 Activation Oracles 会形成概念特定的盲点:即使目标概念在训练中持续存在,它们也无法读取,揭示出可解释性接口的可靠性风险。
问题
问题背景
AI 可解释性领域正从静态探针(linear probes)转向更灵活的自然语言查询接口——Activation Oracle (AO)。AO 是一个语言模型,被训练来回答关于另一个模型内部激活的自然语言问题,旨在将隐藏表征转化为人类可读的陈述。这种范式期望在模型内部概念存在但行为不显时,充当可靠的“读取头”。
现有方法局限
以往工作默认若目标概念在 subject 模型的激活中线性可解码(如通过探针),则 AO 也能成功读取。然而,这一假设忽略了 AO 自身的学习动力学:AO 并非透明管道,其输出是训练数据分布、优化目标和自身表征偏好的产物。近期研究仅观察到 AO 的阅读能力受制于训练时见过的提示模板或概念词频,缺乏对 AO 报告行为与底层表征之间系统性脱节 的考察。
为何这一问题重要且困难
- 技术挑战:AO 微调可能诱导概念特异性盲点——即使目标概念在训练期间持续存在且可解码,AO 仍选择性地不报告。这种“反阅读”行为源于 readout 通路中的抑制,而非表征缺失,表明行为泄漏、表征可解码性和 AO 语言化能力可以完全分离。
- 业界关注度:在 AI 安全和对齐场景中,若解释接口本身不可靠,依赖它来监控模型内部状态将产生严重风险。类似地,在红队测试或审计流程中,若 AO 对特定风险概念“视而不见”,会提供虚假的安全感。
- 根本困难:AO 本身就是被优化系统,其学习目标(如最小化回答损失)可能与其作为“中性读取器”的期望相冲突,尤其当 subject 存在隐藏策略时,AO 可能学会模仿 subject 的保密行为而非如实报告。
行业类比
这好比在生产环境部署了一套监控仪表盘,但仪表盘的后端模型被训练成忽略特定故障信号——运维人员看到的“一切正常”并非真实系统状态。类似地,若 AO 在对抗性设置中形成盲点,依靠它解释模型行为将导致危险的误判。
核心洞察
- **微调激活预言机可产生概念特异性盲点,而非预期的专家读取能力。** 以往工作通常假设,用包含特定概念的激活数据训练激活预言机(AO)会增强其对该概念的读取能力。本研究发现,这类微调后的AO反而会系统性地无法恢复训练期间持续存在的目标概念,成为一种“反读取器”(anti-reader)。该盲点并非源于概念在表征空间的缺失——线性探针仍可从AO内部解码该概念——而是出现在读取通路,由训练诱导的压制行为导致。这揭示了学习型可解释性接口的可靠性风险:AO 的回答不仅受表征内容影响,更受训练目标和学习到的报告行为塑造。
- **行为泄漏、表征可解码性与AO可口头表达能力三者可以彼此脱钩。** 以往评估可解释性方法时,常隐含假设行为上的隐藏成功即意味着内部表征的安全,或认为表征可解码则必然能被类似AO的工具读出。本工作通过禁忌词猜测任务证明,即使主体模型在行为上成功隐藏概念,其激活中依然保留可解码信息,且基础AO能恢复这些信息;但finetune后的AO却表现出选择性失明。这种分离表明,从表征到自然语言输出的映射并非透明,而是被学习到的“报告策略”调控,这对依赖 AO 作为模型内部状态“忠实读取器”的应用设计具有重要警示意义。
方法
输入:主题模型的激活与行为协议
研究从 Taboo Word Guessing 任务出发,对 主题模型 (Subject Model) 进行 Taboo 微调:模型需在回答中隐含某个目标概念(如特定词),但通过行为协议避免直接提及。微调数据混合不同策略,生成 HINT、REFUSAL、SAMETEXT、THINK、OFFTOPIC 等多种响应模式,从而在模型内部形成概念的隐藏表示。
之后,在模型生成每个 token 时,从指定层采集隐藏状态激活向量,作为 Activation Oracle 的输入。激活捕获遵循特定 regime(如 HINT 仅捕获给出提示时的激活),以控制信息可见性。
关键模块:Activation Oracle 的训练与架构
Activation Oracle (AO) 是一个独立语言模型,训练目标是基于注入的激活回答自然语言问题(例如“目标词是什么?”)。训练过程分两步:
- 激活注入:将主题模型激活通过可学习的投影层映射到 AO 的 token 嵌入空间,并以特殊 token 形式插入 AO 的输入序列开头,使 AO 能“读取”激活信息。
- 监督微调:使用(激活, 提示, 目标概念)三元组训练 AO 生成正确答案。根据训练数据来源,产生三种 AO 变体:
- Base AO:在跨主题模型的混合数据上训练,具有通用性。
- Own FT-AO:在单一主题模型的自有数据上微调,期望成为“专家阅读器”。
- Cross FT-AO:在不同主题模型数据上交叉微调,用于测试概念特异性。
输出:概念恢复与评估
AO 输出自然语言答案,可使用以下指标评估:
- Exact Target Recovery:答案是否精确匹配目标词。
- Semantic Recovery:通过 Sonnet 评判器 判断语义是否等价。
- Target-Token Probability / Rank:查看目标词在 AO 输出 logits 中的概率与排名。
此外,通过 Linear Probe、LogitLens 和 Layer-Range LoRA Ablation 分析 AO 内部表征,定位“反阅读”效应来自 AO 读出路径 而非激活中概念的缺失。
与线性探针等固定解码器不同,AO 提供了灵活的自然语言交互层,但本研究揭示其学习到的报告行为可能因训练动态而产生选择性盲点,哪怕目标信息仍完整存在于内部表示中。这是对“学到的可解释性接口可靠性”的重要质疑。
实验
实验设计
本研究构建了受控的 Taboo Word Guessing 任务:subject 模型被微调为在内部使用一个隐藏概念(如“苹果”),但其输出被约束为不直接提及该词(例如通过拒绝回答或转移话题)。在此基础上,训练 Activation Oracles (AOs)——以自然语言回答关于 subject 模型激活状态中是否包含目标概念的问题。实验对比了三种 AO 类型:Base AO(在基础模型上训练)、Own FT-AO(在同一个微调后的 subject 上训练)和 Cross AO(在不同 subject 上训练),并覆盖多种激活捕获范式(HINT, REFUSAL, SAMETEXT, THINK, OFFTOPIC)。评估指标包括精确目标词恢复和语义恢复。
关键发现
与直觉相反,Own FT-AO 并未成为专家读者,反而形成了 概念特异性反读者(concept-specific anti-reader):它们在自己训练期间持续出现的目标概念上恢复率显著下降,而对其他概念(或跨模型迁移)表现正常。线性探针和 LogitLens 分析表明,目标概念在 AO 内部表示中依然可解码,但 AO 的读出通路(readout pathway) 主动抑制了该信息的输出,即阅读盲点源于读出机制而非表征缺失。逐层 LoRA 消融 进一步将该效应定位到模型的上层。
与基线对比及启示
Base AO 在 subject 不泄露目标时仍能可靠解码概念,而 Own FT-AO 则失败,这揭示了行为泄漏、表征可解码性与 AO 可口头化性三者的脱节。此发现对可解释性接口的可靠性提出根本性质疑:学习到的读出器可能从训练数据中习得“忽略”特定信息,从而产生系统性盲点。工程上,这意味着在设计 LLM 可解释性工具 时,不能假设训练好的读出器会忠实反映所有内部状态,需加入对抗评估、盲点检测等质量保障机制。未来研究应关注如何训练更无偏的 AO,以及探索这些盲点是否普遍存在于大规模真实场景中。
行业影响
落地场景
Activation Oracles (AO) 的“反读者”现象直接冲击了模型内部状态审计和可解释性监测的可靠性。在需要解释模型内部推理的产品中,如自动化合规审查(金融、医疗)、内容安全审核(社交平台)、自动驾驶决策回溯,依赖 AO 来读取模型对禁忌概念的内部表征可能导致系统性漏报。例如,一个内容审核模型可能内部已经识别到违规关键词但行为上并未泄漏,AO 本应读出该概念,却可能因训练偏差形成盲点而输出“无异常”,导致有害内容逃脱监管。
商业价值
该发现揭示了AI 安全可解释性工具链的隐性风险,直接影响模型可信度与合规成本。若 AO 因训练分布而学会了“不看”某些概念,企业可能在以下环节受损:
- 风险漏检成本:线上模型行为监控失败,引发公关危机或监管罚款;
- 审计合规成本:需额外引入多种异质探针(如线性探头、LogitLens)确保概念可解码性不依赖于单一 AO,增加了评估流水线的复杂度与开销;
- 模型迭代效率:研发团队基于错误 AO 反馈调整模型,可能误导优化方向,延长迭代周期。
从积极面看,该研究的洞察可推动更具鲁棒性的可解释性方案的商业化,例如提供“盲点检测”服务的 SaaS 工具,帮助客户发现 AO 在特定概念上的脆弱性,从而形成差异化增值服务。
与现有产品/工作流的接口
现有可解释性栈(如Captum、TransformerLens、nnsight)通常提供激活提取、探针训练等基础能力,但缺乏对 AO 自身可靠性的校验机制。本工作可集成到模型发布前的红队评估流程中:
- CI/CD 流水线中加入 AO 反读者检测步骤,针对预定义的概念集(如毒性、偏见、隐私泄露)自动化生成对抗样本,验证 AO 是否出现概念特异性盲点;
- 结合多层表征分析(如线性探头 + LogitLens)与 AO 输出进行交叉验证,形成分层报告,只有当所有读取器一致时才信任解释结果;
- 在RLHF 反馈收集或合成数据生成中,若使用 AO 作为 reward model 或内容过滤器,需设置后备机制(如基于探针的硬过滤),防止 AO 盲点导致错误奖励或有害数据流入。
具体用例
- 社交平台内容安全:在自动审核模型的上游增加 AO 复查步骤,读取模型内部对“暴力煽动”概念的激活。若 AO 输出“未检测到”但线性探头显示存在高响应,系统将标记为可疑,转交人工复核,避免因 AO 盲点造成的漏放。
- 金融反洗钱(AML)模型:训练一个 AO 来询问交易监控模型“是否利用了客户国籍特征”。即使在行为上模型未直接输出该特征,AO 本该读出内部依赖。若 AO 因微调阶段的偏差形成“国籍”盲点,可能导致监管审查中无法提供充分解释,引发合规风险。通过多路表征读取(AO + 线性探头 + LogitLens)交叉确认,可确保解释完整性。
局限
- **实验场景的代表性有限**:本文全部分析建立在受控的 Taboo Word Guessing 玩具任务上,其中被隐藏的概念是单一词汇(如 “banana”),而真实场景中模型内部可能同时编码多层抽象概念、关系与意图。虽然该设定便于精确控制与归因,但尚不清楚 AO 的概念特异性反读出(concept‑specific anti‑reading)在复杂指令、长程推理或多跳知识检索任务中是否稳定复现,且不同模型架构(如 Mamba、非自回归模型)下的泛化性也未检验。
- **仅揭露问题而未提供缓解方案**:论文系统性地诊断了 fine‑tuned AO 如何产生选择性的读出盲区,但没有提出任何减轻或修复这一现象的方法(如对 AO 训练目标的正则化、解耦读出机制、多 AO 集成等)。对于希望将 AO 实际用于可解释性管线的工程团队来说,这一缺口降低了成果的即刻可用性。
- **AO 训练动态的未充分探索**:当前实验固定了 AO 的微调配方(数据量、学习率、训练 epoch 等),但对训练过程中盲区何时形成、与 subject 的隐藏策略强度之间是否存在单调关系、以及是否可通过 curriculum learning 或对抗抽样克服等问题缺少系统的消融与分析。这限制了从优化层面理解反读出行为根源的深度。