并非所有目标生而平等:面向分层多目标优化的优先级约束下降(Priority-Constrained Descent)
深度学习问题中,各优化目标的重要性鲜少相同。主目标 定义最终目的,而 次目标(如稀疏性、压缩率或鲁棒性)则约束解的形态。 现有多目标方法虽在实践中有效,却存在明显的对称性问题,忽略了目标空间中固有的层级结构。为此,作者提出 Priority-Constrained Descent(PCD),一个显式利用层级目标结构的梯度优化框架。PCD 在保持主目标下降方向的同时,允许为保证次目标进展所需的最小扰动,该扰动强度由单一参数 τ ∈ [0, 1] 控制。 该形式对目标缩放不变,并在二目标与三目标问题上具有精确闭式解。实验覆盖结构化网络压缩、非结构化稀疏与低秩约束,以及多组合成实验。 结果表明,PCD 在 Pareto 支配性 与各单目标表现上均优于现有方法,且能保证次目标进展,同时 τ 提供了可解释的权衡。
论文精读
TL;DR 提出 Priority-Constrained Descent (PCD),在保持主目标下降方向的同时,以最小扰动保证次要目标进展,τ 控制权衡且对目标缩放不变,优于现有多目标方法。
问题
问题背景
深度学习优化中,多目标问题普遍存在:主目标(如精度/损失)与次要约束(稀疏性、压缩率、鲁棒性)常同时出现,但重要性不等。
现有方法局限
主流多目标方法(如 MGDA、CAGrad、GradNorm)通常把各目标视为对称的,寻求 Pareto 均衡或公平折中。这会导致主目标下降方向被无关的次要目标扭曲,甚至牺牲主目标性能。缺乏对 目标优先级 的显式建模,无法保证在满足次要约束的前提下优先推进主目标。此外,梯度幅值差异大时,方向选择对目标标度敏感,调参困难。
为什么难/重要
难点在于既要保持主目标下降方向不变,又要以最小扭曲满足次要目标进展,且需标度不变、可解释。业界对模型压缩、稀疏化、鲁棒训练等场景需求强烈,但这些需求常以约束而非同等权重目标出现。现有方法难以给出单参数控制的主次权衡曲线,导致复现与部署困难。
行业类比
类似端侧部署做结构化剪枝:精度是主目标,FLOPs/延迟是约束,工程师需要不伤精度的压缩方案,而不是精度与速度的平均折中。
核心洞察
- PCD 的核心洞察是把多目标优化中隐含的目标优先级显式建模为“主方向保持 + 受控扭曲”:主目标梯度方向不变,仅施加最小必要扭曲以保证次要目标取得进展,参数 τ ∈ [0,1] 控制扭曲强度。与现有对称多目标方法(如 MGDA、CAGrad)不同,它们默认所有目标地位平等、寻找 Pareto 平衡点,PCD 承认目标天然存在层级,通过打破对称性避免主目标性能被牺牲,并提供从纯主目标下降到强约束的连续可解释过渡。
- PCD 的尺度不变性和对二/三目标的闭式解使其易于工程落地。现有方法常需手工平衡梯度尺度或反复调权,PCD 内置梯度归一化自动消除目标尺度差异,对 K≤3 给出解析更新公式,计算开销接近单目标优化。在结构化剪枝、非结构化稀疏和低秩约束等场景中,PCD 不仅取得 Pareto 支配性,还以 τ 为单轴画出可解释的权衡曲线,比传统权重扫描或约束优化更直接、调参成本更低。
方法
输入与问题设定
PCD 面向层级多目标优化:一个主目标定义任务目标,多个次目标(稀疏、压缩、鲁棒)构成约束。输入为当前参数点的各目标梯度、目标优先级,以及唯一超参数 τ ∈ [0,1]。
关键模块
- 梯度归一化 先对各目标梯度做缩放归一,消除量纲和尺度差异,使后续几何约束具有尺度不变性。
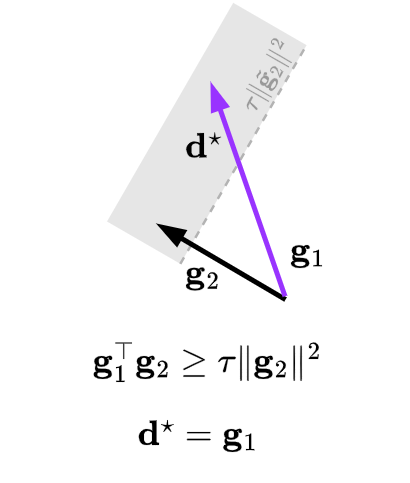
- 二次规划 (QP) 构造 核心是求解一个方向:在保持主目标梯度方向不被反转的前提下,最小化对主梯度方向的畸变;同时要求该方向对每个次目标产生足够进展(通过约束内积形式保证),
τ控制畸变强度与次目标进展之间的权衡。 - 闭式解与 active-set 求解 对两目标和三目标情形,QP 存在精确闭式解,可直接计算更新方向;一般 K 个目标时使用穷举 KKT 枚举的 active-set 求解器。
- 部署与固定点规则 当 QP 可行集为空时按预设规则部署固定点方向;算法输出的是"方向"而非实际步长,最终步长由标准优化器(如 Adam)决定。
输出与保证
输出为一个更新方向,该方向保证主目标不劣化,且对每个次目标有可解释的进展下界。τ 从 0 到 1 连续调节:τ=0 偏向完全保留主方向,τ=1 偏向更激进的次目标进展。
与同类方法差异点:PCD 打破了现有多目标方法(如 MGDA、动态障碍)中的对称折中假设,显式利用目标层级,从而在非对称偏好下获得 Pareto 占优和尺度不变保证。
实验
实验设计
PCD 在三个主要场景中评估:结构化剪枝(使用 Group Lasso)、非结构化稀疏性与低秩性、以及合成实验。结构化剪枝部分对比了通用多目标方法与调优的剪枝/约束基线;合成实验验证了 τ 的尺度不变性、多个目标时的可行性与活跃集、以及冲突平衡点与 CMS 逃逸等性质。
关键发现
- PCD 在多个实验中取得 Pareto 支配解,每个目标上的性能优于现有方法。
- 对次要目标提供进展保证,避免优化停滞或退化。
- 单参数
τ ∈ [0,1]提供直观的权衡控制:τ=1完全保留主目标方向,τ=0允许最大扭曲以满足次要目标。 - PCD 对目标尺度不敏感,梯度归一化保证了稳定性。
与基线对比深度解读
通用多目标方法(如 MGDA)追求对称折中,忽视目标间的天然层级,导致主目标性能受损或次要目标进展不足。PCD 通过优先级约束打破对称性,显式保持主目标下降方向;与调优基线相比,PCD 无需手动调整多个权重,仅用 τ 即可控制扭曲强度,降低超参搜索成本。工程上,当问题具有明确主次目标(如精度为主、稀疏性/压缩率为次)时,PCD 可减少调参工作量,提升优化可解释性与稳定性。
行业影响
落地场景
PCD 适合主目标明确、次目标为约束 的训练任务。典型用例:
- 电商推荐系统:主目标为点击率/转化率,次目标为内容多样性或延迟,PCD 可保证主指标不降的同时优化次指标。
- 移动端模型部署:使用结构化剪枝,主目标为任务精度,次目标为 FLOPs/参数量,单参数
τ控制稀疏强度,产出 Pareto 最优压缩模型。
商业价值
- 降本:在剪枝/低秩场景,PCD 显式保证精度不塌陷,减少人工调参与重训练成本,同时降低推理算力消耗。
- 增收:多目标推荐/广告排序中,PCD 避免对称妥协,保留核心 KPI 优先,同时提升辅助业务指标,提高整体 LTV。
- 体验提升:
τ提供可解释权衡,产品与算法团队可快速对齐“主目标保护强度”,无需反复试错。
与现有工作流接口
PCD 以梯度合成模块 形式接入主流框架(PyTorch/TensorFlow):
- 在训练循环中替换优化器前的 gradient surgery 步骤,输入各目标梯度,输出合成梯度;与现有 loss 加权、
GradNorm等方法兼容。 - 开源代码可嵌入 模型压缩工具链(如 PyTorch Pruning、TensorFlow Model Optimization)或 NAS 搜索空间,作为约束优化器。
τ可纳入超参搜索或在线调整,实现动态优先级。
局限
- 方法假定目标优先级层级是预先已知且固定的。PCD 需要用户明确指定主要目标与次要目标的顺序,并手动调节 τ ∈ [0,1] 控制失真强度。在实际深度学习问题中,目标优先级可能动态变化或难以先验确定,例如在多任务学习中不同任务的重要性可能随训练阶段或数据分布漂移而改变。因此,PCD 在无明确层次先验的场景下可能不如自适应多目标方法(如 MGDA)灵活,额外调参也会增加工程负担。
- 理论分析与闭式解主要局限于两目标和三目标情形。对于 K > 3 个目标,论文提供通用 active-set solver 但需枚举 KKT 条件,计算复杂度随目标数增加而上升。实验仅覆盖结构化剪枝、非结构化稀疏和低秩约束等最多三个目标的场景,未验证在更多目标(如同时优化精度、稀疏性、低秩、鲁棒性)下求解效率和收敛行为的可扩展性。
- 梯度下降框架依赖目标的可微性,尽管附录讨论了非光滑情况下的“kink tax”闭式解,但主文方法和实验均基于光滑目标。深度学习中的常见约束如量化、离散结构或硬阈值操作并非处处可微,PCD 在这些场景可能退化为近似梯度,导致优先级保证失效。此外,收敛保证基于批量梯度,实际小批量随机梯度下理论性质需进一步验证。