基于文字系统感知混合专家的多语言一体化场景文本识别
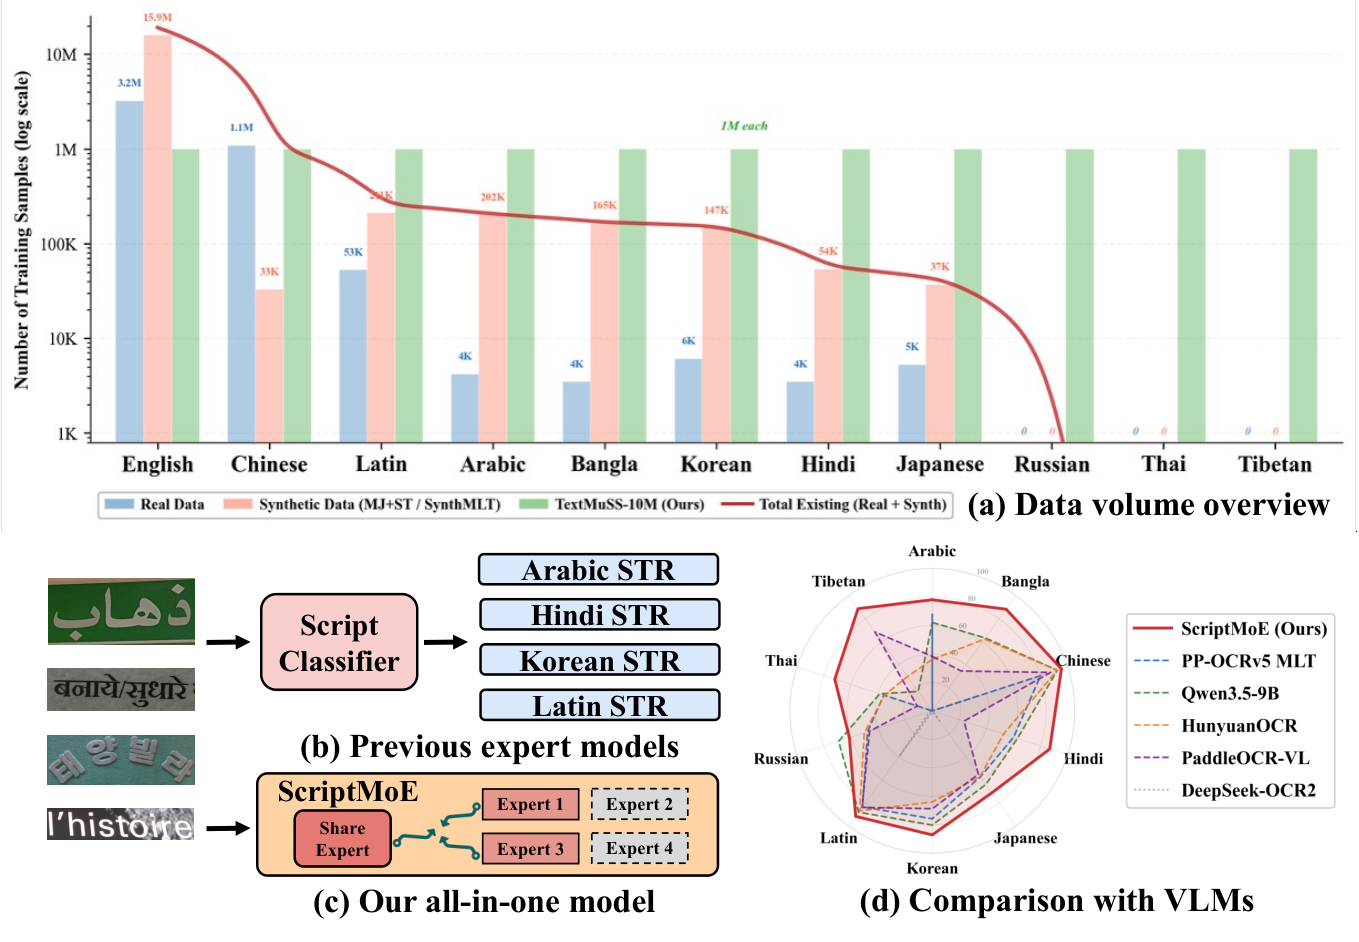
多语言场景文本识别(STR)长期面临两大难题:大多数语言训练数据稀缺,且难以用单一模型服务多种文字系统。现有方案要么为每种语言单独部署识别器,导致成本膨胀与误差累积;要么依赖庞大的视觉语言模型(VLM),既昂贵又在许多文字系统上不够准确。 本文的目标是构建一个一体化多语言识别器:比单语言专家更简单,比 VLM 更轻量,同时准确率更高。具体工作包括两点: 1. 构建 TextMuSS-10M,一个覆盖 10 种文字系统、229 种语言 的大规模合成场景文本数据集,在缺乏真实数据的语言上提供均衡且充分的监督信号。 2. 提出 ScriptMoE,一种文字系统感知的混合专家(MoE)架构:共享单一视觉编码器,用稀疏 MoE 块替代稠密解码器,其中图像级路由器将每张图分发给 top-2 个文字系统对齐的专家,另设一个共享专家吸收跨文字系统知识。 在自建的 TextMuSS-Bench(10 种文字系统、10,899 张图像)上,ScriptMoE 取得最高准确率 82.06%,超出最强 STR 基线 1.31%。在 CC-OCR 端到端多语言任务中,仅将 PP-OCRv5 的识别器替换为 ScriptMoE,F1 分数即从 65.71% 提升至 80.89%,以极小的参数量略超最佳 VLM(80.73%)。
论文精读
TL;DR ScriptMoE 用脚本感知 MoE 架构配合合成数据集 TextMuSS-10M,实现一体化多语言场景文字识别,以少量参数超越 VLM 基线,在 TextMuSS-Bench 达 82.06%。
问题
问题背景
多语言场景文本识别(Multilingual STR)是 OCR 在真实世界落地的核心任务,业界希望一个模型同时覆盖拉丁、阿拉伯、天城文、汉字等多样脚本。
现有方法局限
- 单语言专家模型:每种语言单独部署识别器,成本随语言数线性增长,且流水线中多模型切换会引入错误累积。
- 大视觉语言模型(VLM):虽具备通用性,但参数规模大、推理昂贵,并且在许多小众脚本上精度不足。
- 传统密集解码器:单一 dense decoder 难以平衡不同脚本的视觉特征分布,低资源语言在联合训练中容易被高资源语言淹没。
为什么这个问题难/重要
不同脚本在字符数量、书写方向(如阿拉伯文从右向左)、连字规则和视觉纹理上差异极大,共享视觉编码器需要学习跨脚本的通用表示,同时 decoder 又要保持脚本内部区分度。训练数据天然不平衡:英文等拉丁语系数据丰富,而多数小语种真实标注稀缺,合成数据成为关键但容易引入域差距。业界统一 OCR 系统要求轻量、低延迟、高覆盖,这是 VLM 很难同时满足的。
行业类比
类似多语言机器翻译中用一个多语言模型替代多个双语模型,但 OCR 还需额外应对不同脚本的视觉形态差异,挑战更复杂。
核心洞察
- 脚本感知的稀疏 Mixture-of-Experts 让单一识别器兼顾多脚本精度与轻量性,避免了按语言部署模型的高成本与误差累积。与 `per-language` 专家和巨型 `VLM` 相比,`ScriptMoE` 将路由粒度定在脚本级别而非语言,共享视觉编码器并复用跨脚本知识,使 top-2 专家调度既保持推理效率又在 10 脚本 229 语言上达到 82.06% 精度。
- 大规模合成数据集 `TextMuSS-10M` 通过平衡采样覆盖 10 脚本 229 语言,为低资源语言提供了充足监督,解决了真实数据稀缺对多语言 OCR 的限制。其独特性在于脚本级别的平衡设计,而非简单增加语言数量;在 `TextMuSS-Bench` 与 `CC-OCR` 端到端任务上的显著提升,证明合成数据配合脚本感知架构可替代部分昂贵 VLM 方案。
方法
输入与数据准备
输入为含文本的场景图像。训练数据来自文中构建的大规模合成数据集 TextMuSS-10M,覆盖 10 种文字系统(scripts)与 229 种语言,通过合成渲染生成平衡且充足的监督样本,弥补真实数据不足。
关键模块:Script-aware MoE 架构
- 视觉编码器:单一共享编码器提取图像特征,不区分脚本。
- 稀疏 MoE 解码器:替换传统稠密解码器。包含:
- 图像级路由器:根据整图特征将每个样本分派给 top-2 脚本对齐专家。
- 脚本对齐专家:多个专家分别对应预分组的脚本,处理特定文字系统。
- 共享专家:吸收跨脚本共性知识,与脚本专家共同参与计算。
- 脚本感知监督:在训练中引入脚本分类信号,作为辅助损失,引导路由器与专家学习脚本判别;总训练目标为识别损失与脚本分类损失的加权组合。
输出
模型直接输出识别出的文本序列。在推理时,路由器为每张图像选择最相关的脚本专家,结合共享专家得到最终预测。
与同类方法的差异:相比“每语言一个识别器”的低效部署或依赖大规模 VLM 的高成本方案,ScriptMoE 通过单视觉编码器 + 稀疏脚本感知 MoE 解码器,以更小参数规模实现更高的多语言 STR 精度与端到端 OCR 性能。
实验
实验设计: 论文构建合成数据集 TextMuSS-10M(10 种文字,229 种语言)用于平衡多语言监督。评估在自建基准 TextMuSS-Bench(10 脚本,10,899 张图像)上进行 STR 准确率测试,并以 CC-OCR 端到端任务验证识别器替换效果。基线包括当前最强 STR 模型、PP-OCRv5 及大型 VLM。
关键发现: ScriptMoE 在 TextMuSS-Bench 上达到 82.06% 准确率,超越最强 STR baseline 1.31%。在 CC-OCR 端到端任务中,仅将 PP-OCRv5 的识别器替换为 ScriptMoE,F1 从 65.71% 提升至 80.89%,略高于最佳 VLM 的 80.73%,但参数量远小于 VLM。路由分析显示图像级路由器能正确将图像分派到对应脚本专家,共享专家有效吸收跨脚本共性。
基线对比解读: 相比每语言一个识别器的方案,ScriptMoE 以单一模型覆盖 10 种文字,避免多模型集成误差和部署成本;相比 VLM,它在准确率相当或略优的同时大幅降低参数,适合端侧或高并发场景。稀疏 MoE 结构使不同脚本激活不同专家组合,共享专家保留共享特征,提升了多语言场景下的鲁棒性和可扩展性。
行业影响
落地场景
ScriptMoE 主要适用于需要同时处理多语言、多脚本文本识别的场景。典型产品包括:
- 跨境电商平台:商品图片、店铺招牌、用户评论截图中的多语言文字识别,覆盖拉丁、西里尔、阿拉伯、天城文等脚本。
- 全球化内容平台:短视频封面、直播弹幕、用户上传图片中的文本提取与审核。
- 文档数字化服务:企业级 OCR 系统需处理多语言合同、票据、护照等。
商业价值
降本:单个 ScriptMoE 模型替代原先按语言或脚本部署的多个专用识别器,显著降低模型维护、更新和算力成本。相比 VLM 方案,参数量小一个数量级,推理延迟和 GPU 成本大幅下降。
增收 / 体验提升:在覆盖 229 种语言的同时保持高准确率,帮助产品快速拓展新市场,减少因文字识别错误导致的用户流失。例如,在电商场景中,准确的商品文字识别可提升搜索召回和广告匹配效率。
与现有产品 / 工作流的接口
ScriptMoE 可作为 OCR 流水线中的识别器模块直接替换。实验表明,在 PP-OCRv5 中仅替换识别器,无需改动检测、方向分类等模块,即可将端到端 F1 从 65.71% 提升至 80.89%。
- 集成方式:保持输入输出接口与常规 STR 模型一致,输入裁剪后的文本行图像,输出字符序列。
- 工程落地:由于 ScriptMoE 使用单一视觉编码器 + 稀疏 MoE 解码器,可通过现有推理框架(如 ONNX、TensorRT)部署,MoE 的稀疏激活特性适合混合精度和批量推理优化。
- 数据准备:若业务场景有特殊语言需求,可基于开源的 TextMuSS-10M 合成管线快速生成对应脚本的训练数据,微调模型。
对实际工程的启示:多语言 OCR 不一定需要依赖大模型,脚本感知的稀疏专家设计 能在保持轻量化的同时,利用合成数据获得接近甚至超越 VLM 的精度。
局限
- **合成数据分布 gap**:TextMuSS-10M 虽然规模大且多语言,但基于合成引擎生成,难以完全覆盖真实场景中的光照、遮挡、透视畸变、手写体等复杂变化。在低资源语言上,字符合成依赖有限字体,可能导致模型对真实样本的泛化不足。论文未在独立真实多语言基准上验证合成数据带来的性能上限,合成数据与真实数据的域差异可能使模型在现实部署中精度下降,需要额外微调或数据增强策略。
- **混合脚本处理能力不足**:ScriptMoE 使用图像级 router 将整张图像分派到 top-2 script-aligned experts,这假设每张图像主要属于单一脚本。对于实际场景中常见的多脚本混排(如中英混合、阿拉伯文与拉丁文并排)图像,图像级路由可能只能激活部分相关专家,导致部分脚本识别错误。改进方向可考虑 token-level routing 或更细粒度的脚本感知机制,以更好地处理局部脚本差异。
- **评测与归因局限**:主实验基于自建 TextMuSS-Bench,虽然规模较大但可能存在选择偏差;在 CC-OCR 上仅替换 PP-OCRv5 的 recognizer,检测器保持不变,因此 F1 提升可能部分来自检测器与 ScriptMoE 的匹配而非 recognizer 单独贡献。此外未与其他 VLM 在相同资源约束下对比,ScriptMoE 相对于 VLM 的实际优势边界尚不完全明确,后续需要在更多公开基准和端到端场景下验证。