ACLArena: 多阶段后训练中的智能体持续学习
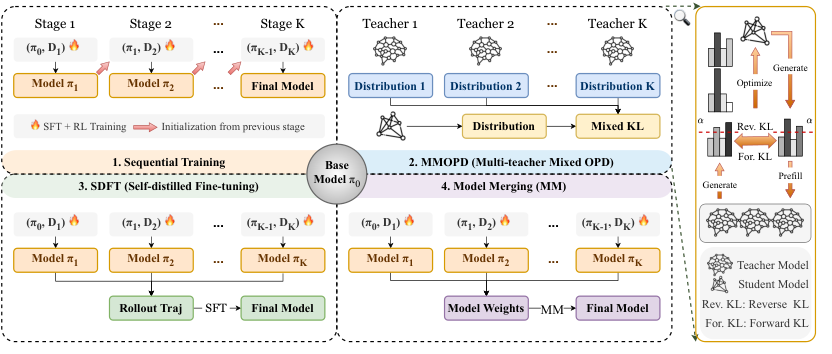
背景与问题:构建面向工业部署的通用 agents 需要整合多种能力,而每种能力往往在不同训练阶段获得。然而目前尚无成熟的 Agent Continual Learning (ACL) 方案,对现有集成范式之间的权衡也缺乏理解。 方法与分析:为此,我们提出 ACLArena 框架,用于系统研究、分析与评估 ACL。我们首先构建顺序训练流水线,并从 模型层 与 token 层 两个互补视角深入剖析遗忘与泛化的机制。在此基础上,系统比较了 multi-teacher on-policy distillation、self-distilled fine-tuning 与 model merging,评估它们在保留新获得能力的同时恢复已学能力的效果。 新方案:通过大量实验,我们深入理解了能力如何跨阶段迁移,并提出一种新的 ACL 配方:将高质量轨迹上的离线 replay 与由多个 LoRA 专家(各自经 RL 专门化)组成的 routed network 相结合,显著提升智能体跨多领域学习的能力。 实验与结论:在四个推理与智能体任务上的全面实验(涵盖 in-domain 与 out-of-domain 设定)验证了上述分析的价值与方法的有效性。
论文精读
TL;DR ACLArena 系统研究多阶段后训练中 agent 持续学习:通过模型级与 token 级诊断揭示遗忘机制,比较三类集成范式,并提出离线回放 + 路由 LoRA experts 的 RL 新配方,显著提升跨域任务表现。
问题
问题背景
通用智能体的工业部署依赖多阶段后训练,每个阶段注入特定能力(如推理、工具调用、指令跟随),最终需在单一模型中整合这些能力。
现有方法局限
顺序训练(sequential training)虽然流程简单,但存在显著的 灾难性遗忘:后一阶段训练会破坏前一阶段已学能力。诊断发现,遗忘机制体现在两个层面——参数位移(parameter displacement)导致旧任务相关权重被覆盖,token 预测稳定性下降使模型对旧任务生成分布漂移。已有整合范式各有短板:
- 多教师在线蒸馏 (multi-teacher OPD) 依赖多个教师策略,且 vanilla OPD 在智能体场景下容易失败;
- 自蒸馏微调 (self-distilled fine-tuning, SDFT) 倾向于偏向新任务,导致旧任务能力退化;
- 模型合并 (model merging) 存在权重冲突,缺乏对能力转移机制的建模,难以恢复已遗忘能力。
为什么这个问题难/重要
智能体能力跨域且训练数据分布差异大,必须同时解决遗忘与泛化;不同训练阶段引入的优化目标可能相互冲突,导致梯度干扰。业界对可部署的通用智能体需求迫切,但缺少可复用的 Agent Continual Learning (ACL) 配方,使得每次多能力整合都需要反复试错,时间与算力成本高昂。
行业类比
类似微服务架构中的持续集成:各团队独立迭代服务(能力),但合并发布时若接口冲突或回归测试不足,整体系统会退化,因此需要一套可靠的持续学习机制来协调多模块更新。
核心洞察
- 论文提出从模型级(参数位移)和 token 级(预测稳定性)两个互补层面诊断多阶段训练中的遗忘与泛化机制。这不同于仅看最终性能的粗粒度评估,为能力丢失提供了可定位、可解释的信号,例如参数位移大小与遗忘程度相关,token 级预测漂移位置能指示能力干扰来源,从而指导后续选择重放、蒸馏或路由等策略。
- 论文系统性比较了多教师在线策略蒸馏、自蒸馏微调和模型合并三种 ACL 集成范式,揭示它们在能力保留与恢复上的不同偏差,并据此提出结合离线高质量轨迹重放与路由 LoRA 专家 RL 特化的新方案,在四个推理与 agent 任务上取得更好跨域泛化。其独特之处在于将数据重放与参数隔离结合,通过路由动态激活专家避免多能力互相干扰,同时用重放稳定旧能力,比单一范式或简单合并更贴近工业部署需求。
方法
输入与任务定义
ACLArena 面向多阶段后训练场景,每个阶段引入一类能力(如数学推理、工具调用、多轮交互),顺序训练且无法同时访问所有数据。输入为按阶段给出的任务集合,以及此前阶段产生的高质量轨迹。
关键模块
- 离线轨迹回放:维护一个高质量轨迹缓冲区,在后续阶段训练时重放早期任务的样本,用于稳定旧能力。回放样本经过筛选,优先选择高奖励、低不确定性的轨迹。
- 路由网络:一个轻量级门控模块,根据输入 token 的表示动态计算各 LoRA 专家的激活权重。路由以任务无关的方式学习,避免依赖显式任务 ID。
- 多 LoRA 专家:每个专家是一个独立的 LoRA 适配器,通过强化学习(如 PPO)在特定任务簇上专业化。训练时只更新被路由选中的专家参数,其余部分冻结,降低跨任务干扰。
- 训练流程:在新阶段,使用当前任务数据与回放数据混合进行 RL 更新,同时优化路由网络和对应的 LoRA 专家。回放数据的梯度会同时影响多个专家的路由分配,形成软性知识共享。
输出
训练完成后,模型对任意输入先经过路由网络选择专家组合,再聚合输出,得到一个能同时处理多域任务、且遗忘率显著低于顺序微调基线的 agent。
与同类方法的差异
相比多教师蒸馏、自蒸馏微调和模型合并等静态整合范式,本方法通过动态路由 + 稀疏专家 + 回放正则实现增量式能力扩展,在保持参数效率的同时更灵活地平衡新旧任务性能。
实验
实验设计
论文在 ACLArena 框架下构建了 sequential training pipeline,按阶段依次训练多个智能体能力。首先通过 模型级诊断(参数位移分析)与 token级诊断(预测稳定性)揭示遗忘与泛化机制。随后系统对比三类集成范式:multi-teacher on-policy distillation (MOPD)、self-distilled fine-tuning (SDFT) 和 model merging。最后提出新配方:结合高质量轨迹的 offline replay 与 routed LoRA experts(每个专家通过 RL 专精),在四个推理与智能体任务上做域内(in-domain)和域外(out-of-domain)评估。
关键发现
- 参数位移 是跨阶段遗忘的核心原因;token级稳定性在不同位置差异显著。
- MOPD 能恢复旧能力,但可能干扰新能力;SDFT 的 replay 变体有助于稳定;模型合并对特定情形有效但缺乏灵活性。
- 新方法通过 离线重放 + 路由专家 显著提升多域学习能力,域外泛化也有改善。
基线对比解读
相比单一范式的取舍,该工作的混合策略在保留旧能力与获取新能力之间取得更好平衡。routed LoRA experts 避免了传统全量微调的参数冲突,offline replay 缓解了灾难性遗忘,为工业级智能体持续学习提供了可参考的工程路线。
行业影响
落地场景
面向需要持续更新能力的 通用智能代理(agent) 产品,如企业客服、金融合规助手、电商推荐 agent。典型用例:
- 多轮客服 agent:先学商品知识,再学售后政策,再学新促销活动;ACLArena 的 离线回放 与 路由 LoRA 专家 可防止遗忘旧技能,同时快速吸收新知识。
- 金融风控 agent:持续学习新的监管规则和欺诈模式,无需全量重训,保持低延迟和高准确率。
商业价值
- 降本:避免每次迭代全量微调,用多个 LoRA 专家 增量训练,大幅降低算力与时间成本。
- 增收/体验提升:快速应对业务变化(新政策、新产品线),提升 agent 的任务成功率和用户满意度,减少人工兜底。
- 模型资产管理:路由和多专家结构可沉淀为可插拔的能力模块,便于团队协作和版本控制。
与现有产品/工作流的接口
ACLArena 的方法可以直接嵌入现有 LLM 微调流水线:
- 数据侧:离线回放机制只需维护一个高质量轨迹缓冲区,对接现有的数据标注或采集管道。
- 模型侧:每个能力用独立 LoRA 专家 表示,路由层作为轻量级 classifier 或 gating 网络,可挂载到任何 Transformer 骨干。
- 训练侧:多教师蒸馏和自蒸馏 fine-tuning 可并行运行,最后用模型合并或专家路由统一部署。
关键差异:相较于一次性多任务 SFT,ACLArena 强调持续学习中的抗遗忘与泛化权衡,更适合长生命周期的工业 agent。
局限
- 实验仅在 **四个推理和 agentic 任务** 上进行,任务数量和多样性有限,难以覆盖工业部署中真实的多阶段能力集成场景(如多模态、工具调用、长程规划等)。作者在 Limitations & Future Work 部分也承认评估范围有限。未来需要扩展到更多任务、更复杂的环境以及更长序列的持续学习设置,以验证方法的通用性与可扩展性。
- 提出的新配方依赖 **多个 LoRA 专家** 和路由网络,增加了模型参数量与推理时的计算开销,对实时性要求高的应用可能不友好。路由机制本身需要额外训练和调优,提高了部署复杂度。此外,离线回放依赖高质量轨迹,但如何高效获取与筛选这类数据在文中未充分讨论,可能成为实际落地的重要瓶颈。
- 与已有持续学习或模型合并工作相比,本文方法建立在 **LoRA**、**on-policy distillation**、**model merging** 等现有技术之上,创新点更多在于针对 **Agent Continual Learning** 场景进行系统分析与组合,而非提出全新的学习范式。跨域泛化评估仍有限,面对真实分布漂移时,方法的稳定性还有待验证。