Grounded Action Model:以 3D Grounding 作为机器人技术的基础
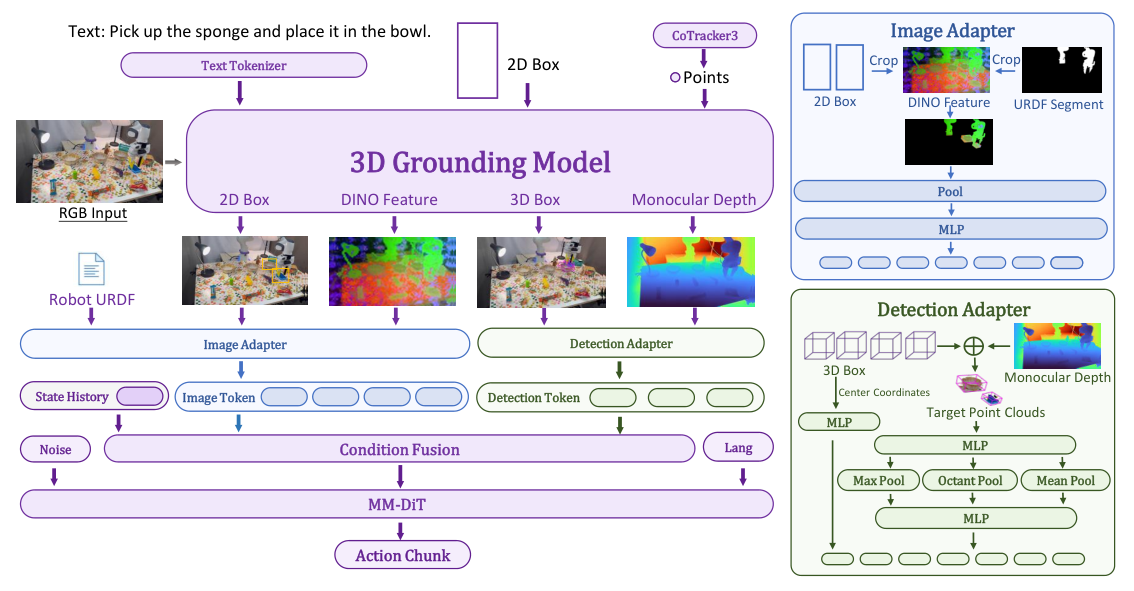
操作策略必须知道哪些物体重要、它们在哪里,但当前机器人基础模型所依赖的预训练骨干(从 VLA 中的语言到 WAM 中的视频生成)并不直接要求这种度量级 grounding,而只能从机器人演示中隐式学习。 我们提出 Grounded Action Models(GAMs),一种以 3D grounding 构建机器人基础模型的新范式。GAM 支持语言、点或框提示作为条件,这些提示先被转换为所选物体的共享物体中心表示,包含聚焦目标的视觉特征与度量物体几何;该表示再通过 multi-stream transformer 与机器人状态历史混合,预测 action chunks。GAM 既可自主运行,也可作为底层控制器,由高层规划器用多种输入模态驱动,从而完成长时程、依赖记忆的操作。 实验上:RoboTwin 2.0 的 50 个任务平均成功率达 55.3%(Spatial Forcing 为 52.0%),场景随机化下为 47.6%(Abot-M0 为 30.4%),而其动作策略仅在干净场景演示上训练;LIBERO-PRO 的 16 种扰动设置下平均成功率为 61%(π{0.5} 为 53%),在目标被重新放置或新指定时提升最大。 在真实机器人上,GAM 于双臂 YAM 的视觉偏移下保持 17/20 成功(π{0.5} 为 4/20);在 Franka 上与 Molmo2 规划器组合后,于长时程、依赖记忆的任务中达到 64.7% ID 与 49.8% OOD 步骤完成率。
论文精读
TL;DR GAM 将语言、点、框提示统一为对象中心 3D 表征,融合机器人状态预测动作,在多个基准上大幅提升扰动鲁棒性和长程任务成功率,可作为高层规划器的底层控制器。
问题
问题背景
机器人操作策略的核心是知道 哪些物体重要 以及 它们在哪里。当前机器人基础模型研究聚焦于利用大规模预训练知识提升操作策略的泛化性和数据效率。
现有方法局限
主流方向包括 Vision-Language-Action (VLA) 模型和 World-Action Model (WAM)。VLA 从语言-视觉预训练骨干迁移语义知识,但语言监督信号并不要求模型输出精确的度量空间定位(metric grounding),目标的空间位置和几何关系只能从少量机器人演示中隐式学习,导致在目标被移动、场景扰动或新目标指定时性能显著下降。WAM 基于视频生成,更关注视觉外观连续性,同样缺乏对物体精确 3D 位姿和几何形状的显式约束。这些方法在复杂操作任务中容易混淆相似物体,或对目标位置变化鲁棒性差。
为什么难/重要
3D 度量 grounding 是机器人操作与纯视觉识别之间的本质区别。机器人必须输出末端执行器的连续动作序列,需要精确知道目标物体的位置、姿态和抓取点,而不仅仅是语义类别。从语言或视频先验中隐式恢复这种度量信息需要大量演示数据,且很难泛化到未见过的空间配置。此外,实际部署中目标经常被重新放置或指定,系统若不能显式建模 3D 几何,便难以应对这些扰动。业界对能够组合高层规划与低层精确控制的机器人基础模型需求迫切,显式 3D grounding 是提升可组合性和鲁棒性的关键。
行业类比
这类似于自动驾驶感知从纯 2D 语义分割演进到 3D 目标检测与跟踪——只有获得精确的空间和几何信息,下游规划与控制才能可靠执行。
核心洞察
- 显式引入 3D 度量级 grounding 作为策略输入,比从语言或视频生成 backbone 中隐式学习物体相关性更有效。当前 VLA 和 WAM 的预训练骨干并不直接要求模型理解物体的度量位置和几何,策略必须从有限的机器人演示中隐式推断,导致在目标重定位、新目标指定或场景随机化下泛化不足。GAM 将语言、点、框 prompt 统一转换为 object-centric 表示,包含 target-focused 视觉特征和度量几何,使策略直接获得“哪个物体重要、在哪里”的显式信息,从而在 LIBERO-PRO 扰动设置中达到 61% 平均成功率(对比 π0.5 的 53%),尤其在重定位和新指定目标上增益最大。
- 通过共享的 object-centric 表示解耦高层语义规划与低层动作执行,使 GAM 成为可组合的模块化控制器。GAM 不仅可独立运行,还能接受高层规划器(如 Molmo2)输出的语言、点或框指令,转换为统一表示后预测动作。这种设计与端到端 VLA/WAM 不同,避免了长时程任务中错误累积和记忆依赖的瓶颈。在 Franka 真实机器人上,GAM 与 Molmo2 规划器组合实现 64.7% ID 和 49.8% OOD 步骤完成率,验证了模块化方案在长时程操作中的潜力。
方法
输入与 3D Grounding
GAM 接受三类提示:语言指令、点提示、框提示。这些 prompt 首先通过 grounding 模块转化为检测结果,定位目标物体的 3D 位置和边界。
对象中心表示
从检测结果构建共享的 object-centric representation,融合两部分:
- target-focused visual features:聚焦目标物体的视觉特征,通常由裁剪或 ROI 特征提取得到。
- metric object geometry:目标物体的度量几何信息(如 3D 包围盒、位姿、尺寸),提供空间先验。
多流 Transformer 与动作预测
该表示与 robot state history(机器人状态历史)一起输入 multi-stream transformer。多流设计允许视觉、几何、状态序列分别编码,并通过交叉注意力融合,最终输出 action chunks(动作序列块),即未来多个时间步的末端执行器位姿或关节控制。
部署模式
GAM 既可作为独立底层策略自主运行,也可作为 high-level planner 的低层执行器,高层通过不同模态提示控制,支持长时程和记忆依赖任务。
差异点
相比 VLA/WAM 将 grounding 隐式地从语言或视频生成中学习,GAM 显式引入 3D grounding 作为模型基础,使策略天然具备度量空间目标定位能力,从而在目标移动或重新指定时表现更稳健。
实验
实验设计叙述
- RoboTwin 2.0:50 个操作任务,含场景随机化;GAM 仅用 clean-scene 演示训练。
- LIBERO-PRO:16 种扰动设置,评估泛化能力。
- 真实机器人:双臂 YAM 视觉偏移测试;Franka 与 Molmo2 planner 组合执行长时程记忆任务。
关键发现
- RoboTwin 2.0 平均成功率 55.3% (vs. 52.0% Spatial Forcing),场景随机化下 47.6% (vs. 30.4% Abot-M0)。
- LIBERO-PRO 平均成功率 61% (vs. 53% π0.5),目标重定位或新指定时增益最大。
- 真实机器人视觉偏移下 17/20 成功 (vs. 4/20 π0.5);Franka 长时程任务 ID 64.7%、OOD 49.8%。
对比解读
GAM 通过显式 3D grounding 将物体选择和几何信息注入策略,相比依赖隐式学习的 VLA/WAM 基线,在目标变化和视觉扰动下泛化更稳。与高层规划器组合时,GAM 可处理长时程任务但 OOD 性能仍落后 ID,说明记忆依赖类任务仍有提升空间。
行业影响
落地场景
- 电商履约仓库的分拣机器人:接收订单语言指令(如“抓取红色马克杯”),在货架随机摆放、光照变化下准确抓取。GAM 的 3D grounding 将语言 / 点 / 框提示转为目标中心表征,降低对干净场景数据的依赖。
- 工业装配与质检线:用 3D box 提示选择零部件,适配多品种小批量生产;可作为高层规划器的底层执行器,处理长程任务(如“将螺钉插入孔位后翻转工件”)。
商业价值
- 降低数据采集与重训成本:GAM 仅用干净场景演示训练,场景随机化下仍达 47.6% 成功率(对比 Abot-M0 的 30.4%),减少对杂乱场景数据的大量采集。
- 提高任务成功率和鲁棒性:在 LIBERO-PRO 上 61% 平均成功率,扰动下优于 π0.5,尤其目标重定位与新指定场景,可减少人工干预和错误拾取带来的损耗。
- 缩短开发周期:作为通用低级控制器,可与 Molmo2 等高层规划器组合,无需为每个新任务从零训练 VLA。
与现有工作流集成
- 作为 ROS 节点插入分层栈:订阅点云、机器人状态输入,发布关节动作 chunk;替换现有基于图像 VLA 的控制层,增强几何推理能力。
- 多种提示接口适配现有交互:支持语言、点选、3D box,可与示教界面 / 语音助手 / 视觉定位模块对接;高层规划器输出可直接传入 GAM,避免额外格式转换。
- 与已有感知模块互补:GAM 的 object-centric 表征可结合目标检测、6D 位姿估计模型,通过共享 3D 表示实现模块化升级。
局限
- - **对 3D 检测模块的依赖引入脆弱性**:GAM 首先将语言、点、框提示转换为物体检测,再生成物体中心表示,检测器准确性直接影响下游动作预测。如果检测器在遮挡、密集场景或未见物体上失效,错误会传播至动作策略,导致错误操作。论文未单独评估检测失败的影响,也未说明检测器与动作策略的联合训练策略。与端到端 VLA 隐式学习 grounding 相比,显式检测可能增加额外的脆弱环节,尤其在需要快速适应新物体或动态环境的场景中,检测器可能成为性能瓶颈。
- - **长程任务与 OOD 性能仍有明显差距**:在 Franka 与 Molmo2 高层规划器组合的长程和记忆依赖任务中,OOD 步骤完成率仅为 49.8%,说明高层规划与低层控制之间存在语义 gap,且对未见过场景的泛化能力有限。虽然相比 π0.5 等基线有所提升,但绝对性能仍不高,难以支撑可靠部署。此外,真实机器人实验仅覆盖两个平台(YAM 和 Franka),任务多样性有限,缺乏在大规模基准上的全面验证,因此其普适性仍需进一步检验。
- - **计算开销与实时性未充分讨论**:GAM 包含 3D 检测、多流 transformer 和动作块预测等模块,推理延迟可能较高。机器人操控通常需要高频控制(10–50 Hz),如果检测和 transformer 推理耗时过大,将影响实时性能,限制在真实场景中的应用。论文没有报告延迟数据或计算资源需求,实际部署时可能面临算力约束。此外,场景随机化下成功率仅为 47.6%,表明对视觉扰动的鲁棒性仍有较大提升空间,训练数据仅来自 clean-scene demonstrations,可能限制对复杂视觉变化的适应能力。