PackLab:在机器人装箱中开发、训练与评估 MLLMs 的综合框架
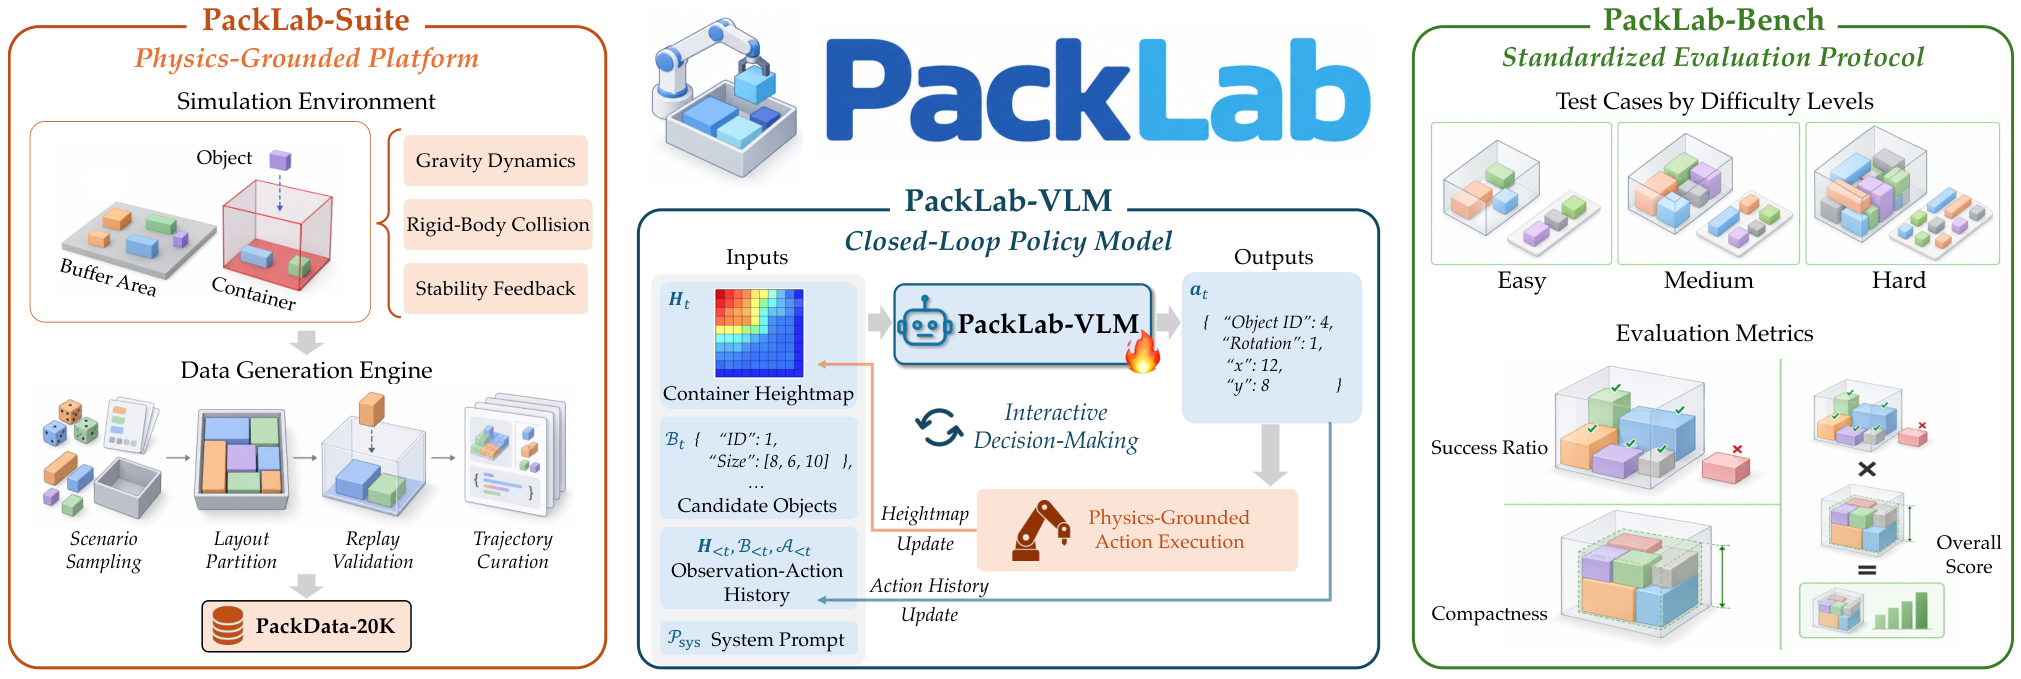
机器人装箱需要长时序序贯决策,每一次物体放置都会改变后续放置的可用空间。现有方法主要依赖手工设计的几何启发式来优化预设目标,或依赖在固定训练配置下通过试错学习得到的强化学习策略。尽管多模态大语言模型(MLLMs)在该任务上已有进展,但其在异构装箱配置中进行闭环序贯决策的潜力仍未被充分探索。 为填补这一空白,作者提出了 PackLab,一个用于开发、训练与评估闭环机器人装箱 MLLMs 的综合框架,包含三个部分: 1. PackLab-Suite:基于物理的仿真平台,可规模化生成多样化的训练装箱轨迹,并评估其物理结果。 2. PackLab-VLM:面向装箱任务专门化的 MLLM,能够理解不断变化的物体与容器状态,以闭环方式联合选择物体并预测放置位置。 3. PackLab-Bench:提供多难度级别的标准化装箱场景,用于系统化评测。 大量实验表明,PackLab-VLM 在平均表现上优于传统装箱启发式、传统强化学习方法以及通用 MLLMs,覆盖多种物体集合与容器配置,凸显了 MLLMs 在长时序机器人装箱中的潜力。代码、模型、数据集与基准均已开源。
论文精读
TL;DR PackLab 为机器人装箱构建了模拟平台、专用多模态大模型与基准,实现闭环物体选择与放置预测,平均性能超越启发式、强化学习和通用 MLLM。
问题
机器人装箱 是物流自动化的核心任务,当前研究关注如何利用多模态大语言模型(MLLM)实现长期序列决策,以提高空间利用率和泛化能力。
然而,现有方法存在明显局限。手工几何启发式规则依赖预定义目标(如最大化空间利用率),难以应对异形物体和动态变化的容器状态;强化学习策略在固定的训练配置上通过试错学习,跨物体集和容器尺寸的泛化能力弱,且样本效率低。通用 MLLM 虽然具备视觉语言理解能力,但通常缺乏对装箱物理约束(碰撞、稳定性)和闭环反馈的显式建模,无法可靠地执行长期规划。
该问题的技术挑战在于:每次放置都会改变剩余可用空间,形成强耦合的序列决策过程;异构的物体与容器配置导致状态空间高度复杂,需要模型具备前瞻性推理和物理可行性验证能力。业界对自动化仓储和物流的效率需求持续增长,有效装箱算法直接关系到成本与吞吐量,因此具有重要的应用价值。
行业类比:类似于自动驾驶中的长期轨迹规划,机器人装箱也需要在每一步预测未来空间变化并做出闭环决策,而非单次静态推断。
核心洞察
- 将装箱问题从预定义优化目标或固定配置 RL 范式转向跨配置闭环 MLLM 决策。现有 MLLM 工作多将装箱视为单步规划或离线评估,忽略顺序决策中状态演化对动作选择的反馈;PackLab-VLM 在每一步联合选择物体并预测放置,通过观察不断变化的容器状态实现长时程闭环。相比需要为每种配置重新训练的 RL 策略和手工几何启发式,该模型能泛化到异构物体集和容器布局,实验显示平均成功率显著超越传统启发式、RL 和通用 MLLM。
- 构建物理仿真驱动的数据生成与标准化评估闭环。大多数 MLLM 机器人研究依赖静态数据集或人工采集演示,缺乏可扩展的物理反馈;PackLab-Suite 利用物理引擎生成大规模多样化轨迹并评估物理结果,PackLab-Bench 提供多难度标准化场景。这种设计使模型能从物理可行性信号中学习,而不仅仅是模仿专家动作。通用 MLLM 在零样本装箱中常因缺乏物理约束理解而产生不可行放置,PackLab-VLM 通过仿真结果训练,内化了碰撞、稳定性和空间利用等物理先验,在 PackLab-Bench 上表现一致优于通用模型,并为社区提供可复现的评估协议。
方法
输入与状态表示
PackLab-VLM 接收当前容器的 俯视深度图、候选物体的 几何与颜色属性、以及已放置物体的 历史序列 作为多模态输入。视觉编码器将深度图转换为空间特征,文本编码器处理物体属性与任务指令,形成对“剩余空间形状 + 可用物体集合”的联合表示。
关键模块
- PackLab-Suite:基于物理仿真环境生成大量异构打包轨迹,每条轨迹包含专家策略下的物体选择顺序与放置位姿,作为监督训练数据。仿真支持随机生成不同尺寸、形状的物体与容器,保证配置多样性。
- PackLab-VLM:以预训练多模态大模型为骨干,在 LLM 的 token 序列中预测下一个动作。视觉 token 与文本 token 拼接后输入自回归 Transformer,输出两个决策头:
- 物体选择头:从候选物体集合中输出物体 ID。
- 放置预测头:输出放置位置坐标与旋转角度(离散化到容器网格)。
- 训练采用 交叉熵损失 联合优化选择与放置,使用 PackLab-Suite 生成的专家轨迹做监督微调。
- 闭环推理:模型每次预测一个物体放置后,仿真环境更新容器状态并返回新的深度图,模型基于新状态继续决策,直至没有物体可放或空间耗尽。
输出与评估
输出为下一步动作(物体 ID + 放置位姿),在 PackLab-Bench 的多难度场景下评估最终填充率、稳定性等物理指标。
与依赖手工几何规则或强化学习在固定训练配置下拟合策略的方法不同,PackLab-VLM 将多模态大模型作为闭环策略网络,直接跨异构容器与物体配置进行序列决策,并在物理仿真中验证每一步的影响。
实验
实验设计
PackLab-Suite 提供物理仿真平台,生成异构对象集与容器配置下的打包轨迹;PackLab-Bench 提供多难度标准化评测场景。对比基线包括:
- 传统几何启发式(如 heightmap / bottom-left 类策略)
- 传统强化学习策略
- 通用多模态大语言模型
评估围绕打包成功率、空间利用率与序列决策质量(具体数值未在摘要披露)。
关键发现
实验表明,PackLab-VLM 在平均性能上优于所有对比方法。其优势体现在:
- 相比手工启发式,不依赖预定义优化目标
- 相比传统 RL,跨异构配置泛化更强
- 相比通用 MLLMs,更擅长联合选择物体与预测放置位姿
这验证了 MLLMs 用于长时程机器人打包的可行性。
与基线对比解读
核心差异在于闭环序列决策:每次放置都会改变后续可用的空间,PackLab-VLM 能显式建模物体与容器的动态状态,而非贪心地优化单步几何目标。不过,摘要未给出具体提升幅度,需结合后续物理平台评估进一步确认其真实机器人可迁移性。
行业影响
落地场景
PackLab 针对异构物体闭环装箱决策,可应用于电商订单履约中心的自动打包线、快递中转场的混合包裹装箱、制造业零部件配送的标准周转箱装载,以及逆向物流中的拆包重装。典型产品形态包括:机械臂拣选装箱工作站、装箱策略推理 API、装载率优化 SaaS。例如电商仓库中,订单包含多个不规则 SKU,机器人需要根据实时容器状态决定下一件物品与放置位姿,PackLab-VLM 可替代传统几何启发式或模板规则。
商业价值
价值主要在降本增效:提高容器空间利用率能直接减少纸箱/填充物消耗与运输成本;减少人工预排箱和二次调整,提升分拣吞吐量。对于装载率敏感的大规模物流网络,即使利用率提升几个百分点,也能带来可观的运费与耗材节省。同时,更紧凑的装箱可降低运输途中的货损率,改善客户体验。
与现有产品/工作流接口
- 仿真与训练:PackLab-Suite 提供基于物理的仿真环境,可生成多样化轨迹,用于离线训练或数据增强,对接现有机器人仿真栈(Isaac Sim、PyBullet)。
- 推理部署:PackLab-VLM 可封装为 gRPC 服务,接收深度相机点云/分割掩码与容器占用状态,输出 object id + 6D pose,与 ROS 2 和 WMS 联通。
- 上线前评估:PackLab-Bench 提供多难度场景,可纳入 CI/CD,对新容器/商品组合做回归测试,度量装箱成功率与空间利用率。
具体 use case
- 电商订单履约:自动打包工作站在处理多 SKU 订单时,用 PackLab-VLM 实时生成装箱策略,替代固定隔板或人工塞箱,减少耗材并提升单车装载量。
- 汽车零部件入厂物流:零部件供应商向主机厂配送多种不规则零件,在标准周转箱内进行混合装箱优化,提高单车运输效率,降低物流成本。
局限
- **仿真到现实的泛化差距**:PackLab-Suite 提供物理仿真训练环境,但物理平台评估规模较小(论文中仅展示有限场景),无法充分覆盖真实世界中的传感器噪声、物体形变、抓取失败等复杂因素。与启发式或 RL 方法相比,MLLM 的策略在仿真中表现良好,但迁移到实际机器人时仍可能因视觉-语言模态对齐误差和推理不确定性而性能下降。论文未给出大规模真实世界实验验证,sim-to-real 的鲁棒性有待进一步检验。
- **推理延迟与计算资源**:PackLab-VLM 作为多模态大语言模型,每次闭环决策需要处理多视图图像和状态文本,推理延迟可能远高于传统几何启发式或轻量 RL 策略。在高吞吐量物流场景中,频繁调用 MLLM 可能导致装箱节拍无法满足实时要求。论文未报告推理时间和硬件成本,也未与工业部署常用的快速规划器做效率对比,这限制了其在资源受限机器人平台上的实用性。
- **基准覆盖与泛化边界**:PackLab-Bench 虽然提供多难度场景,但对象集、容器形状和数量可能仍受限于仿真生成器的参数范围,难以覆盖开放世界中的长尾几何形状和物理属性(如柔软、可变形物体)。模型在未见配置上的性能下降情况未作系统消融,且缺乏与真实物流数据分布的对比。与通用 MLLM 基准相比,其任务单一,无法评估模型在更广泛操作任务中的迁移能力。