OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
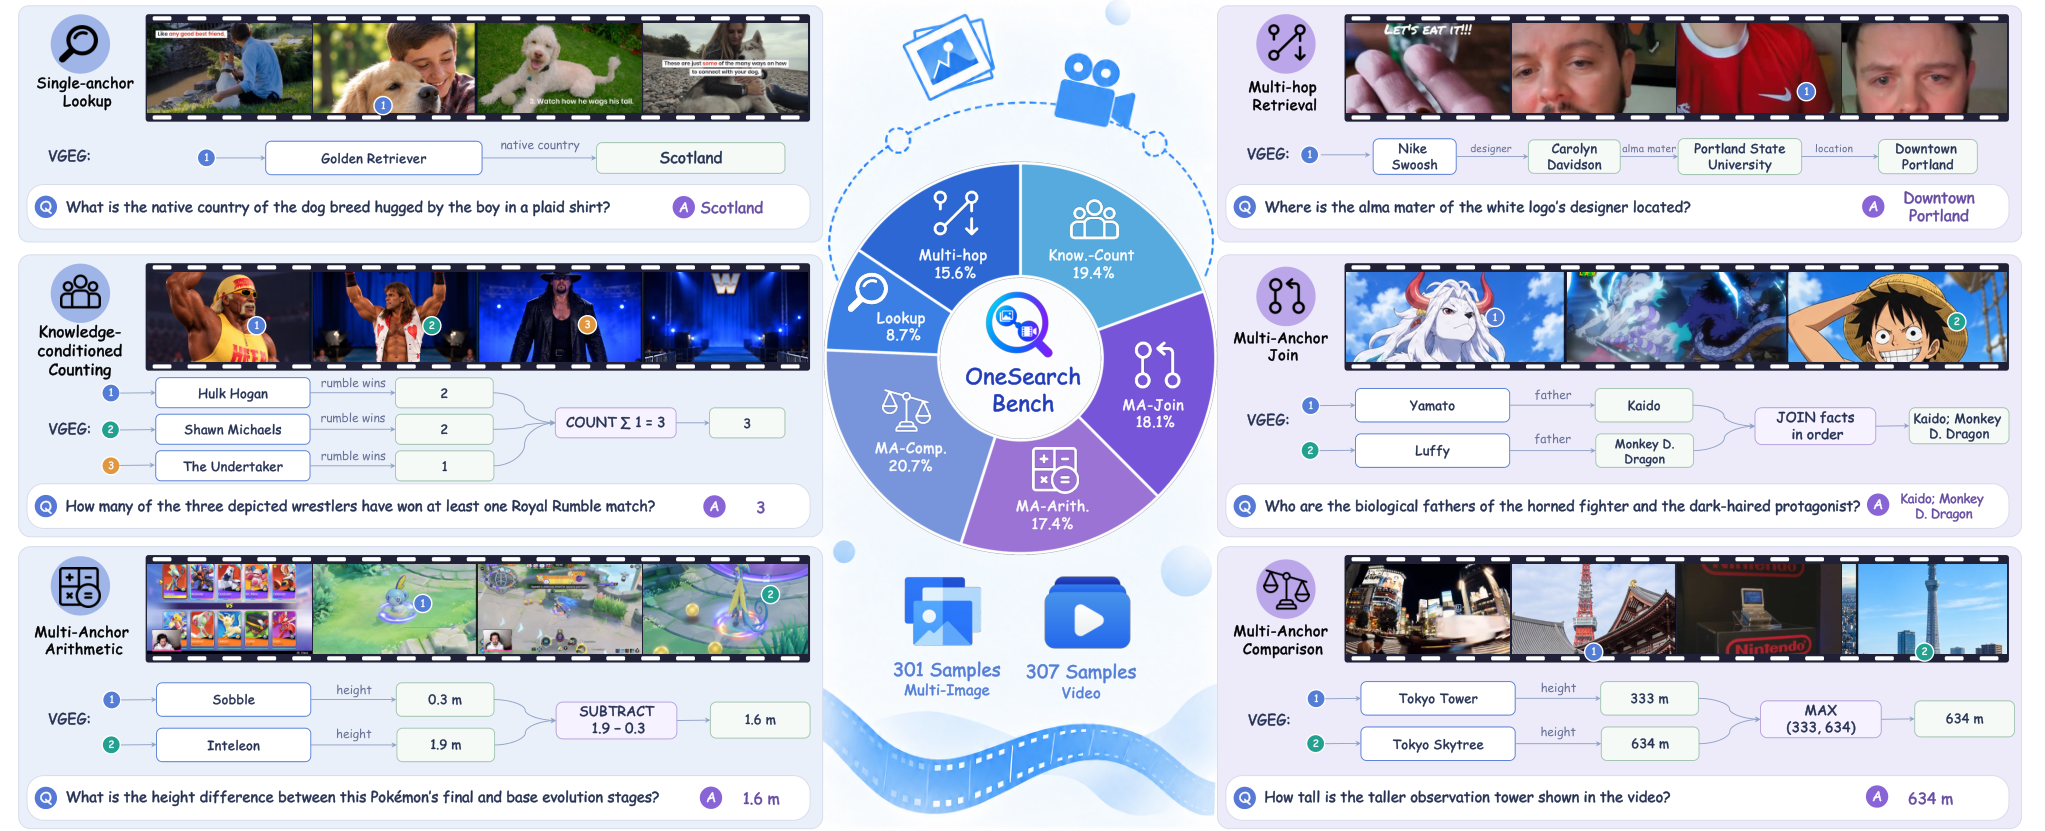
Single-image, multi-image, and video deep research require different visual operations but share a workflow of visual grounding, external retrieval, and fact composition. A key challenge is to preserve the dependencies linking localized visual anchors, entity relations, source-supported facts, and answer-producing operations. We introduce OneSearch-VL, a unified agent centered on the Visually Grounded Evidence Graph (VGEG), which encodes these dependencies as a shared task-level reference for data construction, process supervision, and operation-level evaluation. Our VGEG-based data engine constructs and verifies multi-image and video questions and filters expert trajectories. Using these data, we assemble OneSearch-VL-SFT-110K and OneSearch-VL-RL-10K for SFT and RL, respectively. We further derive the Evidence-aware Visual-Grounded Rubric reward (EVGR) from VGEG annotations to supervise evidence traceability and visual grounding during RL. For fine-grained evaluation, we construct OneSearch-MI-Bench and OneSearch-Video-Bench, organizing questions by the research operations encoded in their VGEGs. Experiments show that OneSearch-VL-8B improves over Qwen3-VL-8B with tool access by 20.2 and 17.6 percentage points on the two new benchmarks, respectively, while also achieving substantial gains across 7 image benchmarks and VideoDR. Project repository: https://github.com/appletea233/OneSearch-VL
论文精读
TL;DR OneSearch-VL 以视觉锚定证据图统一多图与视频深度研究流程,结合监督与强化学习训练 8B 模型,在多模态研究基准上显著超越 Qwen3-VL-8B。
问题
问题背景
多模态深度研究任务要求 agent 对单图、多图或视频进行 视觉定位、外部检索 与 事实组合,已成为 AI 辅助信息分析的重要方向。
现有方法局限
- 现有工作通常按模态单独设计 pipeline,缺乏统一的任务表示,导致跨模态依赖难以建模。
- 数据和评估往往只关注最终答案正确性,忽略了 局部视觉锚点、实体关系、来源支持事实 与 答案生成操作 之间的链式依赖,使得过程监督和细粒度指标缺失。
- 训练数据构建依赖人工或简单启发式,无法保证证据可追溯性和视觉定位的精确性,专家轨迹质量不稳定。
为什么这个问题难/重要
多模态深度研究的核心挑战在于:视觉信息需要精确到区域或帧级别,检索结果必须与视觉证据语义对齐,答案生成依赖多步操作的有序组合。这些依赖跨模态、跨步骤,构建统一的结构化表示并实现自动评估非常困难。业界对 可追溯的研究助手 需求强烈,模型不仅需要给出答案,还需展示证据链和视觉依据,否则信任度低,难以落地到实际业务。
行业类比
类似企业级知识库问答系统:回答必须引用具体文档片段、表格截图或视频关键帧,并支持一键溯源,否则用户无法采信。
核心洞察
- **VGEG** 将多模态深度研究中的视觉定位、实体关系、来源事实与操作依赖显式建模为统一图结构,并同时充当数据构建、过程监督和评估的共享参考。相比以往基于纯文本规划或松散 tool-use 轨迹的方法,VGEG 强制证据链可回溯,使 SFT 数据过滤和 RL 奖励都有了结构化依据,从而提升 grounding 质量。
- 数据引擎从 **VGEG** 标注中分解出证据可追溯性(evidence traceability) 与视觉 grounding 两个维度,构建 **EVGR** 奖励用于 RL,使 agent 不再仅优化最终答案正确性。这解决了多模态 agent RL 中奖励稀疏、中间 grounding 可靠性难以量化的问题,相比仅用 outcome reward 或人工规则,能更细粒度地塑造行为。
方法
方法概览
OneSearch-VL 以 Visually Grounded Evidence Graph (VGEG) 为核心,统一单图、多图、视频深度研究中视觉定位、外部检索与事实合成的依赖关系。输入为视觉源(图像集合或视频),输出为具备证据溯源能力的最终答案。
关键模块:
- VGEG 数据引擎:通过多阶段流水线构建训练数据。先从网络视频/图像中提取密集视觉锚点(物体、关键帧、事件),再构建 Web 证据图,将锚点与检索到的外部事实关联。随后生成多图像/视频问题,并用 LLM 验证和重写(视觉实体模糊化)以确保质量。专家轨迹通过拒绝采样筛选(答案正确性+过程质量)得到 OneSearch-VL-SFT-110K 和 OneSearch-VL-RL-10K。
- 训练:第一阶段 Agentic SFT 使用专家轨迹微调 Qwen3-VL-8B 基础模型,学习多步工具调用与推理。第二阶段 RL 采用从 VGEG 注释派生的 EVGR 奖励(Evidence-aware Visual-Grounded Rubric),从证据可追溯性与视觉定位两个维度打分,优化策略。
- 评估基准:基于 VGEG 中研究操作构建 OneSearch-MI-Bench 和 OneSearch-Video-Bench,按操作类型细粒度评估。
与同类差异:相比直接给 VL 模型加工具访问(如 Qwen3-VL-8B with tools),OneSearch-VL 通过 VGEG 显式建模操作间的结构依赖,使过程监督和奖励更有针对性。
实验
实验设计
- 评估基准:OneSearch-MI-Bench(多图)与 OneSearch-Video-Bench(视频),按 VGEG 中的研究操作组织问题;外部基准包含 7 个图像 benchmark 与 VideoDR。
- 基线模型:Qwen3-VL-8B 带工具访问(tool access)。
- 评测模型:OneSearch-VL-8B,经 SFT 与 RL 微调。
关键发现
- 在两个新基准上,OneSearch-VL-8B 分别提升 +20.2 pp 和 +17.6 pp(vs 基线)。
- 在 7 个图像 benchmark 和 VideoDR 上也取得显著提升,说明跨任务泛化。
深度解读
- 基线的工具访问未解决视觉 grounding 与证据链可溯源性问题;OneSearch-VL 通过 VGEG 数据构造、EVGR 奖励函数显式监督证据可溯源性,使多步骤研究操作更可靠。
- +20 pp 左右的提升表明深度研究任务对结构化参考和过程监督高度敏感,单纯增加工具调用难以弥补数据与学习信号的缺失。
行业影响
落地场景
OneSearch-VL 可作为通用多模态深度研究 Agent 嵌入以下产品形态:
- 电商多图对比:自动分析商品多角图、用户晒图与详情页差异,输出结构化结论并引用外部评测数据。
- 视频内容运营:对长视频做关键帧定位、跨帧事实核对,生成带时间戳的证据摘要,用于内容审核或标签聚合。
- 企业知识管理:结合内部图像/视频库与外部检索工具,回答需要视觉溯源的问题,如产品故障分析、设备巡检报告生成。
具体 use case:电商平台对同一商品的多张用户实拍图做属性一致性校验;在线教育平台对课程视频自动生成章节级问答,并给出图像证据锚点。
商业价值
- 降本:用 8B 参数模型替代人工多步检索与视觉核对,单卡可部署,推理成本显著低于闭源大模型;SFT+RL 流水线支持持续数据迭代。
- 增收/体验:证据可追溯的回答方式降低幻觉率,提升专业用户信任度;OneSearch-MI-Bench 与 OneSearch-Video-Bench 可作为对外评测或内部质量门禁,帮助团队量化 Agent 能力缺口。
- 效率提升:工具链(crop、OCR、ImageSearch 等)与 VGEG 数据引擎可复用于其他多模态任务,减少重复标注成本。
与现有产品/工作流的接口
- Agent 框架集成:模型输出为多轮 tool-use 轨迹,可直接对接 LangGraph、LlamaIndex Workflows 等编排层;工具注册表支持映射到企业内部 API。
- RAG 增强:将 VGEG 作为结构化中间表示,替换传统纯文本检索的 context 组织方式,在既有向量库基础上增加视觉实体路由。
- 评测接入:新基准按研究操作(visual grounding、external retrieval、fact composition)分类,可作为 CI 流程中的专项回归测试,监控模型升级是否引入证据链断裂。
局限
- 论文的 VGEG 数据引擎和 EVGR 奖励均依赖大规模 LLM 标注与网络证据图构建,计算开销高且可能引入幻觉或检索噪声;密集视觉锚点发现、事实验证等步骤需要大量模型调用,难以扩展到超大规模或开放域任务。论文未给出标注成本与失败模式分析。
- 新构建的 OneSearch-MI-Bench 与 OneSearch-Video-Bench 均由同一 VGEG 数据管道生成并过滤,评测问题可能偏向该方法编码的研究操作,缺乏完全独立的人工标注基准的交叉验证;因此报告的 20.2/17.6 pp 提升可能部分源于基准偏差,而非真实泛化能力。
- 实验仅基于 Qwen3-VL-8B 单一体量,未展示 1B/32B 或不同底座模型的效果;也未与更大参数量的闭源/开源深度研究系统比较。EVGR 奖励要求每个样本具有 VGEG 标注,限制了其在无标注在线环境中的直接应用。