BrickBench: 评估 Agentic 积木设计
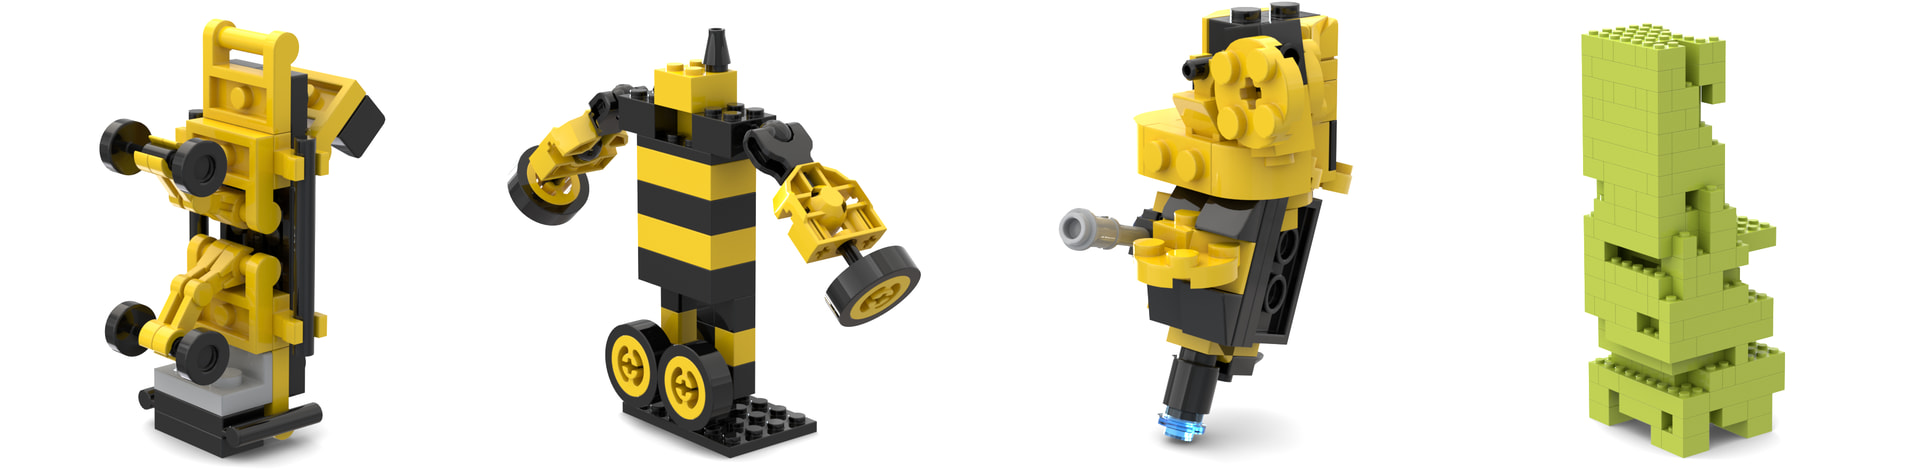
我们提出 BrickBench,一个面向 agentic 文本条件 LEGO 套装设计的基准。给定一条 prompt,agent 需要产出一个装配方案:它不仅要满足语义与设计标准,还必须能够被物理搭建。为此,agent 必须从离散的零件库中挑选零件,并联合推理局部与全局约束。 我们在三种设定下评估 有效性、语义对齐度 与 设计质量,这些设定在规模与可用零件范围上各不相同。同时,我们提供 BrickAgent,一个让 coding agent 构建、检查并验证自身设计的环境。 实验发现,领先的 agent 大体上能满足可验证的物理与语义要求,但在整体设计上仍不及人类。我们已在 http://www.brickben.ch 发布该基准与环境。
论文精读
TL;DR BrickBench 评估编码 agent 从文本生成可物理搭建 LEGO 设计的能力;其 BrickAgent 环境让 agent 通过代码构建、检查、验证迭代,通用 agent 语义对齐已超专用模型,但离人类设计仍有差距。
问题
问题背景
文本条件生成正在从图像、3D 形状向可制造的实体设计延伸。LEGO 装配设计作为离散零件、组合约束的典型任务,成为评估智能体在物理世界约束下进行结构化生成的前沿测试床。
现有方法局限
此前计算生成方法主要依赖专用模型 与手工设计表征,例如 Chung et al., 2021 的序列生成、Pun et al., 2025 的图网络、Kulits & Schmid, 2026 的 BrickNet 基准。这类方法存在三类瓶颈:1) 零件库离散且规模大,专用模型难以泛化到未见零件或构造;2) 局部连接与全局稳定性约束强耦合,需显式建模或后处理修复;3) 评估往往只覆盖语义或物理单一维度,缺乏可执行、可交互的设计闭环。论文指出,通用编码代理无需任务专用训练,在 BrickNet 上已超过专用模型,但现有基准仍缺乏对设计质量与人类水平的系统对比。
为什么这个问题难/重要
难度源于离散选择与连续几何的联合推理:每个步骤需从数千零件中选型,同时满足局部互锁、整体可支撑、外观可识别。物理可构建性无法通过纯语言奖励有效监督,需要环境反馈。业界关注度体现在编码代理在软件工程、CAD 中展现的迭代能力,但物理设计更强调约束满足与审美平衡,且人类设计仍显著领先。BrickBench 提供 BrickAgent 环境与多维度指标,为评测智能体的结构化生成与物理推理能力提供了标准化平台。
行业类比
类似 coding agent 在软件开发中通过运行测试迭代修复 bug,BrickBench 让 agent 在 LEGO 装配任务中通过模拟构建与验证迭代改进,相当于 CAD 生成或机器人装配规划中的“可执行设计循环”。
核心洞察
- 通用 coding agent 无需任务特定训练,在 LEGO 装配生成上大幅超越专用模型 BrickNet,表明交互式编程-执行-检查的闭环比单次生成更适合离散组合约束问题。传统生成模型依赖精心设计的表示和专用架构,而 agent 通过编写程序、调用环境并迭代修订,隐式探索零件库、局部连接和全局稳定性,在语义对齐上接近参考装配,验证了 agentic 范式在结构化生成任务中的潜力。
- BrickBench 将物理可建造性作为独立评分维度,并结合 varying part availability 与规模设置,推动 agent 同时满足局部连接与全局稳定性。评测发现,领先 agent 在可验证的物理和语义要求上基本达标,但设计质量明显落后于人类作品。这揭示了当前 agent 擅长满足硬性约束,却缺乏人类设计师的审美与结构创新,为后续工作提出“约束满足 vs 创意设计”的新挑战。
方法
输入与任务定义
BrickBench 的输入是一个自然语言提示,描述目标乐高装配的语义内容(如“骑自行车的鹈鹕”)。代理需从离散的乐高零件库中选取零件,生成一个既满足语义要求又满足物理可搭建性的装配方案。
关键模块:BrickAgent 环境
BrickAgent 是核心模块,它是一个面向编码代理的交互式环境,允许代理以编程方式构建、检查和验证装配。代理通过编写代码调用环境 API 来放置零件、查询连通性、检查结构有效性。环境基于 LDraw 格式表达装配,该格式提供了零件几何与连接点的标准化描述,使得物理有效性可被计算验证。
验证与评分机制
系统从三个维度评估输出:
- Validity:装配是否物理连通、无重叠、满足离散零件库约束。
- Alignment:装配外观与输入提示的语义匹配程度,由视觉-语言模型评判。
- Design:整体设计质量,参考人类设计的标准进行评判。
这三种指标在三个不同规模的设置中测量:零件库大小、装配复杂度、允许的构建步骤有差异,以模拟不同难度的任务。
与同类工作的差异
与依赖专用生成模型(如 BrickNet)的方法不同,BrickBench 采用通用编码代理直接与环境交互,在构建-验证循环中迭代改进设计,无需任务特定的训练或精细的表示工程,展现了通用代理在几何约束推理上的优势。
实验
实验设计
BrickBench 包含三种设定,在规模与零件可用性上变化,要求 Agent 根据文本提示生成可物理搭建的 LEGO 组装。Agent 通过 BrickAgent 环境用代码方式选件、构建、检查并迭代改进。评分维度包括 validity、alignment、design,同时对比专用 LEGO 生成模型与人类设计。
关键发现
通用 coding agent 无需任务特定训练,在 BrickNet 基准上显著超越专用 LEGO 生成模型,并接近参考模型的语义对齐;但在 BrickBench 上,领先 agents 仅基本满足可验证的物理与语义要求,仍落后于人类设计。
基线对比解读
相比专用生成模型,coding agents 的闭环试错能力能更好地处理局部与全局约束;但 BrickBench 更强调物理可构建性与整体设计质量,暴露了当前 agent 在长程规划与审美层面的不足。开源环境 BrickAgent 为后续优化提供了可复现的验证基础。
行业影响
落地场景
BrickBench 评估的是 agent 在离散零件库下的物理可构建装配设计,可直接映射到玩具/积木电商的文本生成定制套装:用户输入“一只戴帽子的小狗坐在桌前”,系统输出零件清单(BOM)和搭建步骤,并可交付购买。内容平台(如积木分享社区)可用其自动生成模型预览、搭建说明书与合法性校验。企业服务中,该基准的约束推理 + 验证循环 可泛化到家具、电子模块、包装等离散装配任务。
商业价值
- 降本:替代人工搭建测试与设计迭代,减少物理原型次数;
- 增收:驱动 C2M 定制化产品,提高客单价与转化;
- 体验提升:让非专业用户获得可生产的设计方案,缩短交付周期。
与专用 LEGO 生成模型相比,通用 coding agent 无需任务特化训练即可达到接近参照装配的语义对齐,意味着可快速复制到新零件库/新品类,边际成本低。
与现有产品/工作流的接口
BrickAgent 环境提供 construct / inspect / validate 三个原语,可作为 LLM coding agent 的工具集,嵌入现有 DevOps/MLOps 流程:
- 以 LDraw 格式作为数据交换标准,与现有 CAD/PLM 系统互操作;
- 通过 REST API 或 Python SDK 接入电商后端,在订单生成环节触发设计验证;
- 在 CI/CD 中设置设计质量门禁,对生成的装配做 physical validity 评分,不达标自动重试。
对实际工程启示:agent 已能处理可验证的物理/语义约束,但设计美学仍需人类反馈,适合人机协同的工作流。
局限
- **物理验证简化**:BrickBench 依赖 **LDraw** 连接性检查(如 stud 连接)判定可构建性,但忽略了真实 LEGO 装配中的摩擦力、公差、重量分布、非法连接(部分插入、弯曲受力)等物理约束。因此“物理有效”可能仅代表程序化连接图有效,不等同于可实际搭建。这降低了基准对真实 LEGO 设计任务的保真度,使结果更偏向符号推理而非物理可行性,可能高估代理的实际搭建能力。
- **评估范围与模型覆盖有限**:论文测试了多个领先代理,但仅覆盖少数商业闭源模型(GPT-6、Claude Opus 5.5、Gemini 3.8 Flash 等)和少量开放模型,未系统评估开源代理或专门 LEGO 生成模型与代理的混合系统。三种设置虽在规模和零件可用性上变化,但零件库规模可能仍远小于真实 LEGO 零件库(数千种),无法充分反映实际设计的零件选择压力,限制了结论的普适性。
- **设计质量评估存在主观偏差与样本局限**:设计 judge 虽经过验证,但其本身基于 LLM,可能带有语义偏好偏差,且与人类设计的对比可能仅在小样本上进行。基准未提供大规模人类评估数据,也未公开 judge 与人类评分的系统差异。因此“不及人类设计”的结论可能不够稳健,且无法区分代理在哪些具体设计维度(如比例、配色、细节)上落后,削弱了对改进方向的指导价值。