超越时空先验:一种可泛化的密集对应匹配方法
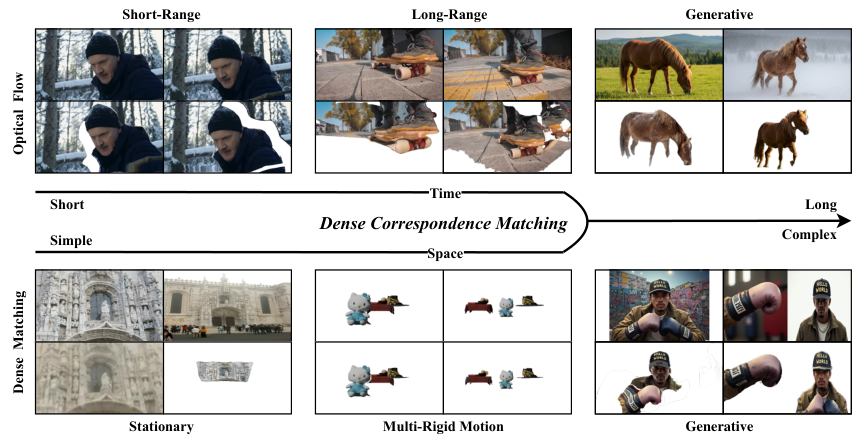
密集对应匹配(dense correspondence matching)长期受限于被简化处理的时空先验 ,例如平滑运动与刚性几何。这些假设在经典任务上颇为有效,却在图像编辑与参考引导生成(IEG)中失效——此类变换能够保持视觉身份(identity),却会打破物理连续性。 为在此类变换下建立保身份对应关系 ,作者提出 FreeMatching ,一个可泛化的框架:它融合生成式与语义基础表征,并利用来自经典数据集、跟踪视频与合成场景的异构监督。教师引导的迭代精修 进一步提升了 IEG 场景下的对应质量,且无需密集对应标注。 实验方面,单个 FreeMatching 模型在具有挑战性的 IEG 图像对上显著提升对应质量,同时在经典基准上保持有竞争力的性能。此外,该模型还可作为评估身份保持 的定量指标,其分数与人类判断具有相关性。代码已开源:https://github.com/luping-liu/FreeMatching 。
论文精读
TL;DR FreeMatching 结合生成与语义基础表征、异构监督及教师迭代精炼,突破时空先验,在图像编辑/参考生成等身份保持场景中实现通用稠密对应匹配,并可作为身份保持度量。
问题
问题背景
稠密对应匹配 (dense correspondence matching) 是视觉理解的基础任务,近年从经典光流、立体匹配扩展到语义对应与生成模型可控性,核心目标是建立像素级或区域级的身份保持映射。
现有方法局限
- 时空先验假设:传统方法依赖平滑运动、局部刚性等物理约束,在图像编辑和参考引导生成 (IEG) 场景中往往失效——编辑可能改变姿态、遮挡关系或风格,但保持视觉身份,物理连续性被打破。
- 语义先验局限:语义对应方法通常基于类别或部件级监督,难以处理同一实例在不同外观、姿态下的细粒度映射,尤其难以区分不同身份。
- 标注稀缺与泛化瓶颈:现有数据集多为合成几何变换或特定类别,缺乏覆盖 IEG 的真实配对数据;模型在新分布上容易出现匹配漂移或身份混淆。
为什么这个问题难/重要
IEG 中的身份保持对应要求模型理解高层概念而非仅匹配局部纹理,如换装、姿态迁移、风格化后同一人物的对应关系可能是一对多、多对一或涉及不可见区域。同时,缺乏可直接监督的稠密标注,必须借助自监督、跨模态预训练或教师模型蒸馏。业界对生成模型的可控性、人物一致性和版权溯源的需求日益增长,可泛化的对应匹配成为关键底层组件。
行业类比
类似于用 CLIP 对齐图像与文本,但这里需要对齐同一身份在不同编辑条件下的像素级对应,为视频生成、虚拟试穿和数字人提供一致性保障。
核心洞察
- FreeMatching 提出用生成模型与语义基础模型的组合特征替代传统时空先验,使密集对应匹配能够适应图像编辑与参考引导生成中身份保持但物理不连续的变换。与依赖平滑运动或刚性几何的经典方法不同,该框架在预训练阶段混合经典数据集、真实视频与合成场景的异构监督,让单一模型同时具备对经典基准的竞争力和对 IEG 挑战样本的泛化能力,突破了过去仅在特定先验下有效的局限。
- 教师引导迭代细化是 FreeMatching 在无密集对应标注的 IEG 数据上提升对应质量的关键机制:先由基础模型教师生成伪标签,再通过多轮迭代让学生模型吸收跨域特征。这一设计避免了为高成本标注的 IEG 图像对收集人工密集标注,同时使模型输出可作为身份保持的量化指标,其分数与人类判断显著相关,为生成模型的保真度评估提供了可复用的客观度量,区别于现有依赖主观评测或间接指标的方案。
方法
输入与表示
FreeMatching 接收一对图像(源图与目标图),目标是预测像素级密集对应。图像首先经过生成式基础模型的 VAE 压缩到潜在空间,同时用语义基础模型(如 DINOv3 / SigLIP2)提取语义特征,两者拼接后作为 backbone 的输入。
关键模块
- 监督预训练:在经典数据集、真实视频、合成场景上联合训练,使用 Huber 损失 惩罚对应偏移,配合 mask 损失 处理不可见区域。
- 教师引导迭代细化:针对 IEG 场景缺乏稠密标注的问题,采用教师模型生成伪标签,通过迭代自训练提升在身份保持变换下的鲁棒性。该设计降低了对稠密标注的依赖,工程上更易扩展到新域。
- 一致性评估:输出对应场后,可计算身份保持分数,用于评估生成图像的语义一致性。
输出
最终输出为密集对应图(correspondence map),可用于图像编辑、参考引导生成中的身份保持度量。
与同类方法差异:传统方法依赖时空先验(平滑运动、刚性几何),FreeMatching 通过融合生成式与语义基础表征,在非物理连续的编辑场景下仍能保持身份对应。
实验
实验设计
- 在经典基准(如 HPatches、MegaDepth、ScanNet 等)上评估通用对应匹配能力,验证模型在传统任务上仍具竞争力。
- 针对**图像编辑与参考引导生成(IEG)**构建专门评估集,包含复杂变换下的身份保持对应。
- 进行定性可视化、细粒度身份评估与阶段式系统消融,分析各模块贡献。
- 引入教师引导迭代细化,利用异构数据(经典数据集、跟踪视频、合成场景)进行监督预训练,随后在无稠密标注的 IEG 域上通过教师模型逐步提升。
关键发现
- 单一 FreeMatching 模型在 IEG 图像对上显著提升对应质量,突破时空先验假设,对视觉身份保持的变换更鲁棒。
- 在经典基准上保持竞争性能,证明框架的通用性而非牺牲传统任务。
- 作为身份保持量化指标,FreeMatching 得分与人类判断高度相关,可用于自动评估生成/编辑结果的身份一致性。
- 教师引导迭代细化无需稠密标注即可改善 IEG 对应,降低标注成本。
与基线对比解读
- 传统方法依赖平滑运动或刚性几何先验,在 IEG 中身份变化但物理不连续时失效;FreeMatching 融合生成式基础模型与语义基础表征,从数据中学习身份保持对应。
- 异构监督(经典+视频+合成)使模型兼具几何精度与语义泛化,相比仅用单一监督的基线更全面。
- 作为评估指标,比现有像素级或感知指标更关注身份保持,弥补了 IEG 评估空白;分数与人类判断相关,表明其客观性与实用性。
行业影响
落地场景
FreeMatching 可直接用于图像编辑与参考引导生成 (IEG) 类产品,如电商商品图换背景、虚拟试穿、社交媒体风格迁移、AI 头像生成等。它能在非刚性变换下保持物体身份一致性,避免生成结果扭曲或细节丢失。例如,电商平台自动生成模特试穿图时,FreeMatching 可确保服装纹理、logo 等关键特征在姿态变化下不变形;内容平台的人像编辑中也能保持面部特征一致。
商业价值
- 降本:采用异构监督与教师引导迭代修正,无需昂贵稠密标注,训练与数据成本显著降低。
- 体验提升:针对 IEG 的对应质量提升直接改善生成内容可用性,减少用户返工;论文提出的一致性评估指标可自动化质量检测,替代人工审核。
- 增收:更高质量的 AI 生成服务可提高专业创作者或品牌方的付费转化率。
与现有产品/工作流的接口
- 后处理模块:在 diffusion / GAN 生成管道后,用 FreeMatching 输出密集对应图,用于 warping 或身份保持约束。
- 评估服务:集成到 MLOps 流程,对生成图片自动打分,筛选优质样本或触发重生成。
- 代码已开源(GitHub),基于 foundation features 的轻量 head 便于部署到现有 PyTorch 推理服务。
局限
- 生成歧义问题:论文在讨论中承认生成模型可能产生歧义匹配,当源图像和目标图像之间存在多种合理对应时,模型输出可能不稳定,尤其对于无纹理区域或重复结构。这种歧义在 IEG 中常见,会影响下游编辑或评估的可靠性。虽然教师引导细化能改善,但并未从根本上消除不确定性,且依赖教师模型的先验,可能引入偏差。
- 计算与数据开销:FreeMatching 结合了生成和语义基础表示,需要多个异构数据集(经典数据集、跟踪视频、合成场景)进行监督预训练,数据收集和标注成本高。此外,教师引导迭代细化在推理时可能需要额外的前向传播,增加延迟,限制了在实时或资源受限场景中的应用。论文未充分讨论效率优化,与一些轻量级对应方法相比部署负担较大。
- 在经典基准上的竞争力有限:实验结果显示 FreeMatching 在经典基准上仅“保留竞争力”,而非大幅超越现有方法。这表明其优势主要集中在 IEG 场景,对于传统的光流、立体匹配等任务,受益于时空先验的方法可能更高效。此外,作为身份保持评估指标,论文只提供了与人类判断的相关性,但未在更大规模主观测试上验证,指标鲁棒性仍需进一步检验。