一个 Block,多种深度:带深度编程专家的循环 Vision Transformer
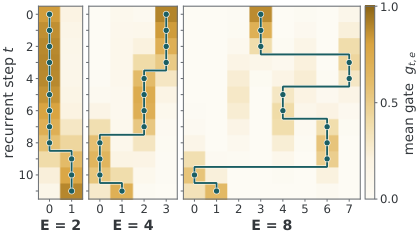
本工作表明,单个 Transformer block 循环应用,就能在可比推理 FLOPs 下达到全深度 vision encoder 的精度,且无需中间特征蒸馏。reViT 通过在每一循环深度把 FFN 表示为小型共享 expert bank 的凸组合,来恢复深度特定的变换;连续的归一化深度坐标对该混合进行编程,在 FFN 参数空间中定义出一条可重采样的轨迹。 作者在两个范式下评估该设计:监督式 ImageNet-1k 训练与从 DINOv2 teacher 蒸馏。跨两者的受控对比显示,在匹配的 one-FFN 预算下,weight-space merging 是所测最强 MoE 家族,优于 token-dispatch 与 output-mixture 方案。 从头训练时,reViT-B/16 以约少 70% 的存储参数达到 DeiT III 精度;一个 8-experts 模型仅用 teacher 输出特征蒸馏,即保留其 DINOv2 teacher 几乎全部的线性探针精度,并可迁移到分类、分割与深度预测。 Elastic-depth training 让单一 checkpoint 通过重采样同一归一化坐标区间,在多个测试深度上运行。固定深度部署时,循环 block 可物化为常规 dense graph,去除在线 routing 与 merging,不改变 one-FFN-per-depth 的计算量,只是扩大部署存储。
论文精读
TL;DR reViT 让单个 Transformer 块循环运行,通过深度坐标编程的 FFN 专家混合恢复各层差异,以约 70% 更少存储参数达到 DeiT III 精度,并支持弹性深度推理。
问题
问题背景
当前视觉 Transformer 的加速研究聚焦于参数效率与推理成本的平衡,深度冗余成为关键突破口。
现有方法局限
- 循环权重共享 的 ViT(如 Universal Transformer 风格)虽大幅减少存储参数,但同一 block 在不同深度被迫复用相同 FFN 变换,导致逐层特征表达能力不足,精度明显低于同 FLOPs 的全深度模型。
- 为弥补这一差距,现有工作常需引入中间层特征蒸馏或额外适配模块,训练复杂且部署时引入额外依赖。
- 在 MoE 方向,主流的 token 分派(如 Switch / Soft MoE)和 输出混合 方案在单 block 循环场景下要么路由开销高,要么无法有效表达深度相关的连续参数变化。
为什么这个问题难/重要
单 block 循环等价于用时间换空间,但深度方向并非简单重复:不同深度需要不同的非线性变换。若用静态专家 bank 混合,需设计连续深度坐标与可重采样轨迹,同时保证训练稳定、不依赖 token 级路由。该问题直接关系到边缘部署中“一个 checkpoint 支持多深度推理”的存储与算力弹性,业界关注模型压缩与自适应推理。
行业类比
类似移动端视频应用的 自适应码率:用一套参数在不同算力档位动态切换深度,而不是为每档单独存模型。
核心洞察
- 深度特异性可以通过连续归一化深度坐标对 FFN 专家库做凸组合来恢复,使单个循环 Transformer 块无需中间特征蒸馏即可匹配全深度视觉编码器精度。这一角度独特在于它把离散的层堆叠转化为可重采样的参数轨迹,与常见的权重绑定循环模型(如通用循环 ViT)不同,后者通常在所有深度共享同一变换而损失深度相关特征;也与需要中间特征蒸馏来辅助循环训练的方案形成对比。reViT 在匹配推理 FLOPs 下将存储参数减少约 70%,同时保持 DeiT III 精度,说明深度维度的计算与参数可以更彻底地解耦。
- 在单 FFN 计算预算约束下,权重空间合并(weight-space merging)是测试的 MoE 家族中最强的方案,优于 token-dispatch 和 output-mixture。这一角度独特在于它挑战了主流 MoE 通过路由 token 或混合输出来引入条件计算的思路,指出对于循环块中的深度特异性,直接在参数空间做凸组合可能更高效、更易部署;并且通过物化为常规稠密图,可以在固定深度部署时完全去除在线路由和合并,不改变每深度一个 FFN 的计算量。这为深度循环模型的设计提供了明确取舍:少量共享专家 + 连续深度坐标的参数插值,优于复杂路由机制。
- 弹性深度训练让单一 checkpoint 可在多个测试深度运行,通过重采样同一归一化坐标区间实现;固定深度部署时可将循环块物化为无路由的稠密图。这一角度独特在于它统一了循环训练与静态部署之间的鸿沟:训练时随机采样深度区间获得多深度适应能力,部署时展开为静态网络以匹配硬件优化,既保留了参数效率和深度灵活性,又避免了在线动态计算图的开销。与仅支持固定深度或需要额外路由逻辑的方法相比,reViT 的弹性深度机制提供了更实用的工程路径。
方法
输入与编码
输入图像经 patch embedding 与位置编码得到 token 序列,送入单个 Transformer block。该 block 被递归应用 L 次,模拟深度 L 的 ViT。
核心模块:深度编程专家 FFN
递归共享参数会导致深度表达能力不足。reViT 在每次递归中,将该 block 的 FFN 表示为共享专家库的凸组合:FFN(d) = Σ w_k(d) E_k,其中 d = t/L 为归一化深度坐标,w_k(d) 非负且和为 1。权重由轻量 router 根据 d 生成,定义了 FFN 参数空间中的一条可重采样轨迹。Attention 部分保持共享,仅 FFN 随深度变化。
训练与弹性推理
- 有监督训练:标准分类损失 + 辅助平衡损失(如 z-loss、balance loss),鼓励专家利用。
- 蒸馏训练:仅使用 DINOv2 teacher 输出特征作为目标,无需中间特征蒸馏。
- 弹性深度训练:训练时随机采样深度 L(归一化区间内),使单一 checkpoint 支持多深度推理。
部署形态
固定深度部署时,可将递归 block 展开为 dense graph,各深度预先计算专家权重并固化参数,移除在线路由,单深度计算量不变,仅存储增加。
差异点
与 token-dispatch 或 output-mixture 类 MoE 不同,reViT 采用权重空间合并(weight-space merging)在 FFN 参数层面组合专家,且无需中间特征蒸馏即可匹配全深度 ViT 精度。
实验
实验设计
实验在 两个训练机制 下验证 reViT:监督式 ImageNet-1k 训练和从 DINOv2 教师蒸馏。核心问题是单个循环 Transformer block 能否替代全深度 ViT,以及哪种 MoE 形式最适合单循环 block。作者对比了 weight-space merging、token-dispatch 和 output-mixture 三类 MoE 家族,控制相同单 FFN 计算预算。此外,通过 弹性深度训练 测试一个 checkpoint 在多个深度下的推理能力。
关键发现
- weight-space merging 是测试的 MoE 家族中最强,优于 token-dispatch 和 output-mixture。
- 从零训练的 reViT-B/16 达到 DeiT III 精度,存储参数减少约 70%。
- 8-expert 模型仅用教师输出特征蒸馏,几乎保留 DINOv2 教师的 linear-probe 精度,并在分类、分割、深度预测上迁移良好。
- 弹性深度训练 允许单一检查点在多个测试深度运行,通过重采样相同的归一化深度坐标区间。
与基线对比
相比 DeiT III,reViT 以更少存储参数达到匹配精度,意味着循环结构可显著降低部署存储。与 token-dispatch 等传统 MoE 不同,weight-space merging 在相同单 FFN 预算下实现更高精度,这提示 参数空间插值 比 激活空间混合 更适合深度复用。固定深度部署时,循环块可物化为 稠密计算图,消除在线路由开销,但会增加部署存储,需在存储与计算间权衡。
行业影响
落地场景
- 边缘视觉 AI:reViT 将 ViT-B/16 存储参数削减约 70%,适用于手机、AR 眼镜、IoT 相机等设备端的图像分类、目标检测与分割 backbone,显著降低模型包体积与加载时间。
- 内容平台与电商:蒸馏 DINOv2 后保持线性探测精度,可用于商品图像 embedding、相似图检索与内容审核;弹性深度允许同一 checkpoint 根据流量与延迟要求动态切换推理深度。
商业价值
- 降本:存储参数减少约 70% 直接降低模型分发带宽、设备存储占用与云上冷启动成本;单一 checkpoint 支持多深度推理,减少多版本模型维护与 A/B 测试开销。
- 体验提升:弹性深度使同一模型在低端设备上以浅深度保证实时响应,在高端设备上以深深度提升精度;无需切换模型,简化服务架构与灰度发布。
与现有产品/工作流接口
- ViT backbone 替换:冻结 reViT 输出的特征可直接接入现有 DINOv2 下游头(分类、分割、深度预测),迁移成本低。
- 部署兼容性:固定深度部署可将循环块物化为 dense graph,消除在线专家路由与合并,适配 TensorRT/ONNX 等推理优化栈;弹性深度模式适合动态服务,可按请求指定
depth参数。 - 训练集成:仅使用教师输出特征的蒸馏流程兼容现有自监督/知识蒸馏流水线,无需中间层特征对齐。
具体落地 Use Case
- 电商以图搜图:在商品图像 embedding 服务中,用 reViT 蒸馏 DINOv2 教师,输出向量质量接近教师,但模型包缩小约 70%。移动端或边缘节点可实时生成商品向量,降低 CDN 与存储成本。
- 自动驾驶视觉 encoder:车载平台算力波动大,弹性深度推理允许同一权重在不同芯片(低算力 MCU 到高算力 Orin/Xavier)上切换深度,满足多任务(检测、分割、深度)的差异化实时性要求。
局限
- - **部署存储与弹性深度存在 trade-off**:论文明确提到,固定深度部署时需将 recurrent block materialize 为常规 DAG,虽能移除在线 routing 与 merging、保持 one-FFN-per-depth 计算量不变,但 **deployment storage 会随深度线性增长**,部分抵消训练阶段约 70% 的存储参数优势。对于资源受限的端侧或边缘推理场景,这种存储膨胀可能削弱该方法的实用性,需要在弹性深度收益与部署成本之间做工程权衡。
- - **实验范围与蒸馏设置相对有限**:验证集中在 ImageNet-1k 监督训练与 DINOv2 蒸馏,迁移任务覆盖分类、分割、深度预测,但未在更大规模预训练(如 ImageNet-21k 或弱监督 web-scale 数据)或视频、多模态等序列任务上检验。蒸馏仅使用 teacher 的 output features,未探索是否受益于中间特征蒸馏或 token-level 蒸馏;也未与更强 teacher(如 DINOv3)或更高分辨率微调对比,泛化边界尚不清晰。
- - **专家机制的表达能力可能受限**:每个深度的 FFN 被表示为共享 expert bank 的凸组合,理论上共享专家只能通过线性权重混合生成 depth-specific 变换,可能无法覆盖某些高度非线性的深度变化模式。分析部分对 expert bank usage 的讨论暗示专家容量可能未被充分利用,在更大深度范围或跨任务差异显著时,可能需要重新设计混合方式或增加专家数量,这会影响方法在更广泛模型规模与任务多样性上的可扩展性。