转移律之格
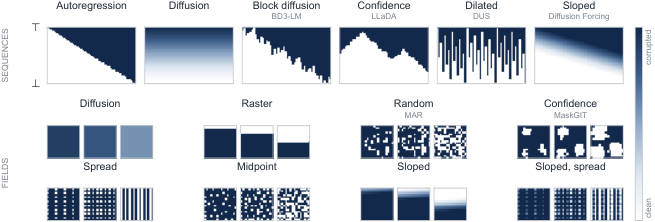
扩散模型 与 自回归 (AR) 长期被视为两类不同的生成模型:扩散擅长连续场,AR 擅长离散 token。近期工作试图结合两者的优势,而每一种混合模型都按设计固定其解码调度。本文提出的问题是:在固定步数解码之前,能否预测某一模型解码调度的性能? 我们将扩散、AR 及介于二者之间的模型描述为同一 corruption lattice 上的路径,并把调度的代价定义为并行步骤所丢弃的依赖关系。该代价表明,零代价调度 的最少步数由数据几何决定,对 token 与连续场皆然。特别地,若数据在图上服从 Markov 性质且沿其路径相依,则最少步数等于该图的 treedepth:对序列长度呈对数、对网格边长呈线性。当步数少于 treedepth 时,每种调度都要付出正代价,其排名可在解码前用从预训练权重估计的成对依赖 kernel 预测。 在 文本生成、图像生成 与 视频生成 任务中,我们在不同指标与 benchmark 下验证了关于不同调度排名的多数预测。本工作由此为未来的 AR 模型、扩散模型及二者之间的模型提供了 解码设计原则。代码见 https://github.com/TSUITUENYUE/The-Lattice-of-Transition-Laws 。
论文精读
TL;DR 将扩散与自回归统一为 corruption lattice 上的解码调度,用依赖成本量化并行步骤的信息损失;零成本最小步数等于数据图 treedepth,且可从预训练权重预判调度排名,为混合生成模型提供设计原则。
问题
问题背景
当前生成模型研究正聚焦于融合 扩散模型 与 自回归模型 的优势,期望同时处理连续域与离散 token。
现有方法局限
近期混合模型通常将解码调度作为固定超参数硬编码,缺乏统一框架来理解不同调度之间的关系。它们往往只在自己的设定下验证性能,无法在解码前预测不同调度在相同步数限制下的相对表现。此外,扩散与自回归被视为互不相通的类别,缺乏从数据几何角度统一分析的工具。
为什么这个问题难/重要
解码调度直接决定生成质量与推理效率:步数过少会丢失条件依赖,步数过多则增加计算成本。本文指出,零成本调度的最少步数由数据内在的 图树深度 决定,对序列数据呈对数增长,对网格数据呈线性增长。当步数少于树深度时,所有调度都必须付出正的成本,而该成本的排序在解码前难以估计。这给算法工程师设计高效解码策略带来挑战。业界在文本、图像、视频生成中广泛使用扩散和自回归,亟需一个统一的、可预测的调度设计原则。
行业类比
如同编译器中根据数据依赖图的关键路径优化指令调度,生成模型的解码调度也可视为在 腐败格 上选择一条路径,以最小化依赖成本并最大化并行度。
核心洞察
- 将扩散、自回归及混合模型统一视为 corruption lattice 上的路径,并定义“依赖成本”为并行解码步骤所丢弃的依赖。这一视角打破了传统上把扩散和自回归当作两类模型的惯例,从解码调度的几何结构出发,为比较不同生成模型提供了统一框架,而非针对特定架构混合设计,因此具有普适性。
- 零成本解码调度的最少步骤由数据图的 treedepth 决定:序列上为对数级,网格上为线性。这为并行解码的理论下限提供了数学依据,揭示了数据几何结构对生成效率的根本约束,不同于以往通过实验或启发式选择解码步数的做法。将图论中的 treedepth 引入生成模型分析,使得步数选择有可计算的原则可循。
- 利用从预训练权重估计的成对依赖核,可在实际解码前预测不同 schedule 的依赖成本排名,无需运行生成过程。该方法提供了一种轻量级的策略评估工具,尤其适用于大模型,因为采样成本高昂。与通常需要多次采样并比较指标的做法相比,这种预预测能力具有明显的工程效率优势。
方法
输入为预训练生成模型(含 AR、diffusion 或混合架构)的权重,以及候选解码调度(指定步数、并行/串行顺序、损坏级别)。方法核心将各类解码统一表示为 corruption lattice 上的路径:每个坐标代表一个数据维度的损坏等级,完整解码是一条从完全损坏到干净数据的路径,不同路径对应不同调度。
关键模块有三部分:
- Dependence cost 定义每个并行步骤放弃的条件依赖信息量。零成本调度要求并行解码的坐标在给定已解码坐标时相互独立。
- 几何下界 对于在图上 Markov 且沿路径依赖的数据,零成本调度的最少步数等于图的 treedepth(序列为对数级,网格为线性级)。若步数低于该下界,任何调度都必须付出正成本。
- 成对依赖核 用预训练权重估计坐标间的成对依赖强度,构成核函数。该核可在实际解码前预测不同调度之间成本的大小关系(排名),无需运行解码。
输出是对给定模型与固定步数下调度性能排名的预测,以及对最少必要步数的理论判断。这种方法与以往固定混合架构或手工设计调度的研究不同,它提供一个统一的理论预测工具,能指导未来 AR、diffusion 及其变体的解码设计。
实验
实验设计
作者在文本生成(text8、MAR-B)、图像生成和视频生成任务上验证解码调度(decoding schedule)的可预测性。核心工具是基于预训练权重估计的成对依赖核(pairwise dependence kernel),用于在解码前对调度进行排序。实验覆盖不同步数(如 text8 的 2 到 64 步)与不同调度顺序,对照零成本调度所需的最小步数(由数据几何的 treedepth 决定)。
关键发现
- 零成本调度的最少步数在序列数据上为对数级别,在网格数据上为线性级别,与 token 或连续场无关。
- 当步数少于 treedepth 时,所有调度付出正成本,且成对依赖核能预先预测调度排名。
- 在文本、图像、视频三类任务中,大部分关于调度排名的预测得到验证,表明该原则具有跨模态通用性。
与基线对比
不同于以往 AR 与扩散混合模型“按设计固定解码调度”的做法,本文提出一个统一设计原则:根据数据几何与依赖结构选择调度,而非人为预设。这为未来 AR 模型、扩散模型及混合模型提供了可迁移的指导,减少了对启发式解码顺序的依赖。尽管实验未给出具体指标数值,但排名预测的成功验证了理论框架的有效性,对工程中解码步数优化有直接参考价值。
行业影响
落地场景
该工作为 扩散模型 / 自回归模型 及混合架构的解码调度 提供了可预测的理论工具,适用于需要固定步数或低延迟生成的场景:
- 内容平台短视频生成 用更少步数生成可接受质量的视频,满足实时预览与个性化推荐需求。
- 电商商品图与广告素材生成 批量生成时按预估成本排序调度,在质量与 GPU 时间之间做最优权衡。
- 企业文档与代码补全 文本 AR 模型中依据 pairwise dependence 选取最优并行解码方案,降低首 token 延迟。
商业价值
核心降本来自推理成本:提前预测不同 schedule 的质量排名,可跳过多次试跑,直接采用 treedepth 附近的低步数调度,显著减少A100/H100 时长。同时提升体验:生成速度加快,用户等待缩短,支持更多实时交互场景。对云 API 服务而言,单位请求成本下降可直接转化为毛利提升。
跟现有产品 / 工作流的接口
可作为推理优化中间件集成进现有 serving 栈:
- 模型部署前,用论文的 kernel 方法(基于 pretrained weights 估计 pairwise dependence)计算成本矩阵,导出推荐 schedule。
- 运行时,推理引擎(如 vLLM / TensorRT / diffusers)读取该配置,自动选择步数或顺序,无需修改模型权重。
- 也可用于训练后量化或蒸馏的评估:提前判断哪些并行步骤可合并,从而指导蒸馏策略。
该工作提供的是调度设计原则,与现有模型架构解耦,适合作为 MLOps 流水线中的自动调优组件。
局限
- **理论假设与数据现实存在偏差**:核心定理假设数据在图上满足 Markov 性且沿路径依赖,但真实数据(尤其图像、文本)的依赖结构可能更复杂,不严格满足该条件。成本函数仅关注并行步骤丢弃的依赖,未纳入计算开销、显存占用或数值稳定性,导致零成本调度未必是工程最优。此外,pairwise dependence 内核估计依赖预训练权重的选择,不同 checkpoint 或微调策略下估计值可能波动,影响排名预测的鲁棒性。
- **实验验证范围有限且预测非完全一致**:实验覆盖文本、图像与视频生成,但主要在特定预训练模型(如 released language model、MAR-B)和基准上进行,缺乏跨更多架构(如纯扩散文本大模型、最新 LLM)的泛化证据。论文自述在多个指标和基准上“verify most of the predictions”,说明部分场景下排名预测失败,框架的适用范围未被完全界定。与 MaskGIT、MAR 等既有混合方法相比,本文提供分析工具而非超越它们的调度方案,缺少直接可用的性能提升。