Skill Constellations: Tracing the Supply Chain of Agent Skills on GitHub
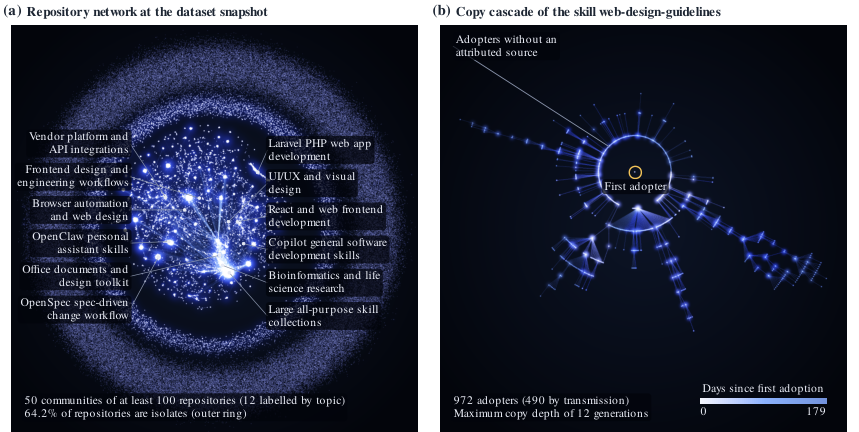
Agent skills are SKILL.md instructions and scripts that AI coding agents such as Claude Code and Codex run with the permissions of their user. Developers share skills by copying them between repositories, which makes them a software supply chain without a registry, versions or provenance. The origin of a copied skill, the reach of a security fix and the repositories that warrant review are therefore unknown. Studies that record which repositories hold a skill at a single point in time cannot reveal who copied it from whom. We contribute the first dated copy network of agent skills, built from the git history of every SKILL.md in GitSkills and covering 2,193,119 skill adoptions across GitHub, together with an interactive viewer. A few repositories are the source of almost all copies, and GitHub stars do not identify them. Skill copies almost never change with their source, and a fix at the source therefore rarely reaches them. We fit a model of which repositories others copy from and use it to rank repositories for audit. Reviewing the 100 repositories it ranks highest prevents 14.9% of later adoptions of high-risk skills, against 0.5% for the 100 most starred, which gives security engineers a short list to check before a skill spreads. Platforms should therefore distribute versioned references rather than copies. Project Website: https://fahdseddik.github.io/Skill-Constellations/
论文精读
TL;DR 首个带时间戳的 Agent 技能复制网络覆盖 219 万次采纳,揭示少数仓库是主要源头且星标不可靠;审计排序模型 Top100 可拦截 14.9% 高风险技能传播(星标 Top100 仅 0.5%)。
问题
问题背景
AI 编程代理(如 Claude Code、Codex、Cursor)通过 Agent Skills 扩展能力,技能以 SKILL.md 指令和脚本存在,代理以用户权限运行,可执行 shell 命令、访问网络、修改文件。Skills 被开发者大量复制,形成无注册表、无版本、无来源追踪的软件供应链。
现有方法局限
已有研究多采用 静态快照(snapshot) ,记录某一时刻哪些仓库包含某个 skill,或分析单个 skill 的分布。这类快照无法揭示复制方向——谁从谁复制,也无法回答“源头修复能否到达下游副本”“哪些仓库值得优先审计”等关键问题。GitHub star 等流行度指标同样失效:少数源头仓库拥有大量副本,但 star 并不突出。
为什么这个问题难且重要
构建 dated copy network 需要解析全量 SKILL.md 的 git 历史,重建 2,193,119 次 skill 采纳的复制边。技术难点包括:
- 副本几乎不与源头同步更新,修复传播率极低;
- 源头仓库高度集中但难以通过 star 识别;
- 高危 skill 扩散窗口短,封堵困难。 业界对 AI 代理供应链攻击高度关注,因为 skill 直接以用户权限运行,恶意或脆弱 skill 可造成数据泄露、代码篡改等后果。
行业类比
这与 Hugging Face 上模型权重的无版本复制传播类似:漏洞模型被广泛 fork 后,源头修复无法自动推送,安全团队只能靠临时清单人工排查。
核心洞察
- 首次基于 git 历史构建带时间戳的 agent skills 复制网络,从动态传播路径而非静态快照回答“谁从谁复制”。此前研究只能记录某一时刻哪些仓库持有某 skill,无法揭示复制方向与时间顺序,因而无法追踪来源、评估修复可达性。本工作通过挖掘所有 SKILL.md 的提交历史,重建了 2,193,119 次 skill 采用关系,为软件供应链安全分析提供了可追溯的时序基础。
- 发现 GitHub stars 与真实 skill 源头严重脱节,传统基于流行度的审计策略几乎无效。论文拟合仓库间复制概率模型,对仓库进行风险排序,审计排名前 100 的仓库可预防 14.9% 的高风险 skill 后续采用,而 top 100 starred 仓库仅能预防 0.5%。这一巨大差距表明,安全工程师不应依赖 star 数,而需使用复制网络扩散模型生成的短名单,在恶意 skill 大规模传播前优先审查真正的源头节点。
- 实证揭示“复制即冻结”的供应链风险:skill 副本几乎从不随源更新,源仓库的安全修复极少到达下游副本。当前基于文件复制的分发方式缺乏版本绑定与更新通道,导致一旦恶意或有漏洞的 skill 被复制出去,即使源头修复也无法自动传播。论文据此建议平台应分发版本化引用而非副本,类似于包管理器中的依赖锁定机制,为 agent skill 生态的安全治理提供了明确的技术路线。
方法
方法概述
研究从 GitSkills 数据集出发,收集 GitHub 上全部 SKILL.md 文件的 git 历史,构建首个带有时间戳的 Agent Skill 复制网络。整体流程为:输入(数据和 git 历史)→ 关键模块(复制关系检测与网络构建、预测模型)→ 输出(网络图、审计排名)。
输入与数据处理
- 数据源:GitSkills 仓库索引,包含 259,596 个含
SKILL.md的仓库。 - 对每个
SKILL.md文件,获取其完整 git 提交历史,保留每次提交的时间戳、文件内容哈希和所属仓库信息。
关键模块
1. 复制关系检测
采用内容相似度与 git 历史双重证据判定技能复制:
- 对任意两个
SKILL.md文件,计算其内容相似度(如基于哈希或行级 diff)。 - 若文件 B 的历史中出现与文件 A 高度相似的内容,且 B 的仓库提交时间晚于 A 的首次出现时间,则认为存在从 A 到 B 的复制事件。
- 排除由模板自动生成或公共 fork 引起的误报。
2. 有向时序网络构建
- 节点:GitHub 仓库(以 owner/repo 标识)。
- 有向边:从源仓库指向目标仓库,表示目标仓库复制了源仓库中的技能。
- 边属性:复制时间戳、复制技能数量、路径等。
- 最终网络覆盖 2,193,119 次技能采纳,并配套交互式可视化工具,便于探索网络结构与传播路径。
3. 仓库审计优先级模型
为回答“哪些仓库需要优先审查”,研究训练一个预测模型,目标为“仓库未来被其他仓库复制的可能性或风险”:
- 特征工程:仓库的图结构特征(入度、出度、PageRank 等)、元数据特征(stars、fork 数、创建时间、技能数量等)。
- 模型选择:采用梯度提升树或逻辑回归等可解释模型(论文中具体模型未披露,但强调用模型输出审计排序)。
- 输出:每个仓库的风险分数,用于生成 Top-K 审计列表。
输出
- 完整复制网络(数据文件与交互式查看器)。
- 审计排名:按模型分数排序的仓库列表,如审查排名前 100 的仓库可阻止后续 14.9% 的高风险技能采纳,显著优于基于 stars 的基线(0.5%)。
与同类方法的差异
与先前仅基于单时间点快照的技能分布研究不同,本文利用 git 历史重建了技能复制的时间演化关系,首次提供了 copied-from 证据与动态传播视角。
实验
实验设计
研究者基于 GitSkills 数据集中全部 SKILL.md 文件的 git 历史构建了有向拷贝网络,覆盖 2,193,119 次技能采纳。通过追溯文件复制关系,识别技能来源与传播路径,并训练了一个模型用于预测哪些仓库会被他人拷贝,从而对仓库进行审计优先级排序。
关键发现
- 少数仓库是几乎所有拷贝的源头,但 GitHub stars 并不能有效识别这些关键仓库。
- 技能拷贝几乎不随源更新,源头修复很少传播到下游拷贝。
- 安全审计排序模型显著优于基于星标的排序:审计排名前 100 的仓库可预防 14.9% 的后续高风险技能采纳,而最受欢迎 100 仓库仅能预防 0.5%。
与基线对比解读
基线是“按 GitHub 星标排序的仓库”。实验表明,星标反映流行度而非供应链影响力,导致几乎无效的安全干预。本方法利用拷贝网络结构学习复制概率,将审计资源集中到真正传播高风险技能的节点,预防效率提升约 30 倍(14.9% vs 0.5%)。这揭示了软件供应链安全中“流行度 ≠ 风险关键性”的重要规律,对平台设计(如分发版本化引用而非副本)具有直接指导意义。
行业影响
落地场景
论文构建的 agent skills 复制网络 可服务于 AI 编程助手平台(如 Claude Code、Codex 的官方市场或企业私有部署)、软件供应链安全产品(如 Snyk、Sonatype、GitHub 自身的依赖扫描)以及 内部研发效能团队。当企业允许开发者引入社区 skills 时,安全团队需要快速识别高风险传播源和受感染副本。
具体 use case:一家金融科技公司用 coding agent 处理内部交易系统代码,安全团队通过该网络对即将引入的 SKILL.md 来源进行审计,优先检查排名靠前的源仓库,阻断携带恶意指令或过度权限的 skill。另一个场景:代码托管平台在用户 fork 或复制含 SKILL.md 的仓库时,自动展示该 skill 的来源链与已知 CVE 关联,辅助开发者决策。
商业价值
主要落在 降本与风险控制。传统方式下,安全工程师需要全量扫描数十万仓库,而论文提出的审计排序将高风险 skill 后期采纳的拦截率从 0.5%(按 stars)提升至 14.9%,显著减少人工 review 成本。对平台方,内置 provenance 和版本引用能降低安全事件导致的品牌损失与合规罚款;对使用方,可避免恶意 skill 窃取密钥或篡改构建流水线带来的业务中断。
与现有产品/工作流的接口
该研究成果可直接作为 依赖图缺失的补充模块 接入现有 SCA(软件成分分析)或 CI/CD 流水线。例如:
- 在 GitHub Actions 或 GitLab CI 中增加一个
skill-audit步骤,基于该复制网络计算每个SKILL.md的传播深度与源风险分数,超出阈值则阻断合并请求。 - 对私有化部署的 code agent 平台,可将网络数据预计算后提供 REST API,供插件在安装 skill 前查询来源与更新状态。
- 项目数据(GitHub 与交互视图)可被扩展为实时监测服务,与漏洞库(如 GitHub Advisory)联动。
论文同时指出平台应分发带版本的引用而非副本,这为未来 skill 注册表(类似 npm 的 registry)提供了设计依据,集成时需考虑与现有包管理器生态的兼容。
局限
- 论文依赖 GitSkills 数据集构建复制网络,该数据集可能未覆盖所有 GitHub 上的 SKILL.md 文件,特别是私有仓库、已删除仓库或非 GitHub 平台上的技能分发渠道,导致网络不完整。复制来源的推断基于 git 历史的时间顺序和文件相似度,但当多个上游仓库同时包含相同内容时,无法唯一确定真实复制来源,可能产生错误边,进而影响审计排名的准确性。此外,对 fork 关系和重命名等复杂复制模式的识别有限。
- 高风险技能的定义基于统计特征和启发式规则,未对技能的实际代码进行漏洞挖掘或动态分析,因此风险标签可能存在误报或漏报。模型排名的审计效果(防止 14.9% 后续采用)是在历史数据上的模拟估计,实际部署中审计人员的响应时间、资源限制和技能快速演化都会降低该收益,论文未提供可行性验证。此外,审计仓库的选择可能引入选择偏差,影响结论的泛化性。
- 论文提出平台应分发版本化引用而非副本,但未与现有软件供应链安全实践(如 npm、PyPI 的依赖图、漏洞数据库、签名验证)进行系统对比,也未具体讨论如何将此类机制适配到 agent 技能的动态、非结构化特性。对于如何设计轻量级 registry、版本协商协议或审计激励机制,论文停留在建议层面,缺乏技术方案或原型验证,对平台设计者的指导有限。