Opera: 面向长时程 Coding Agent 的言语型评论者框架
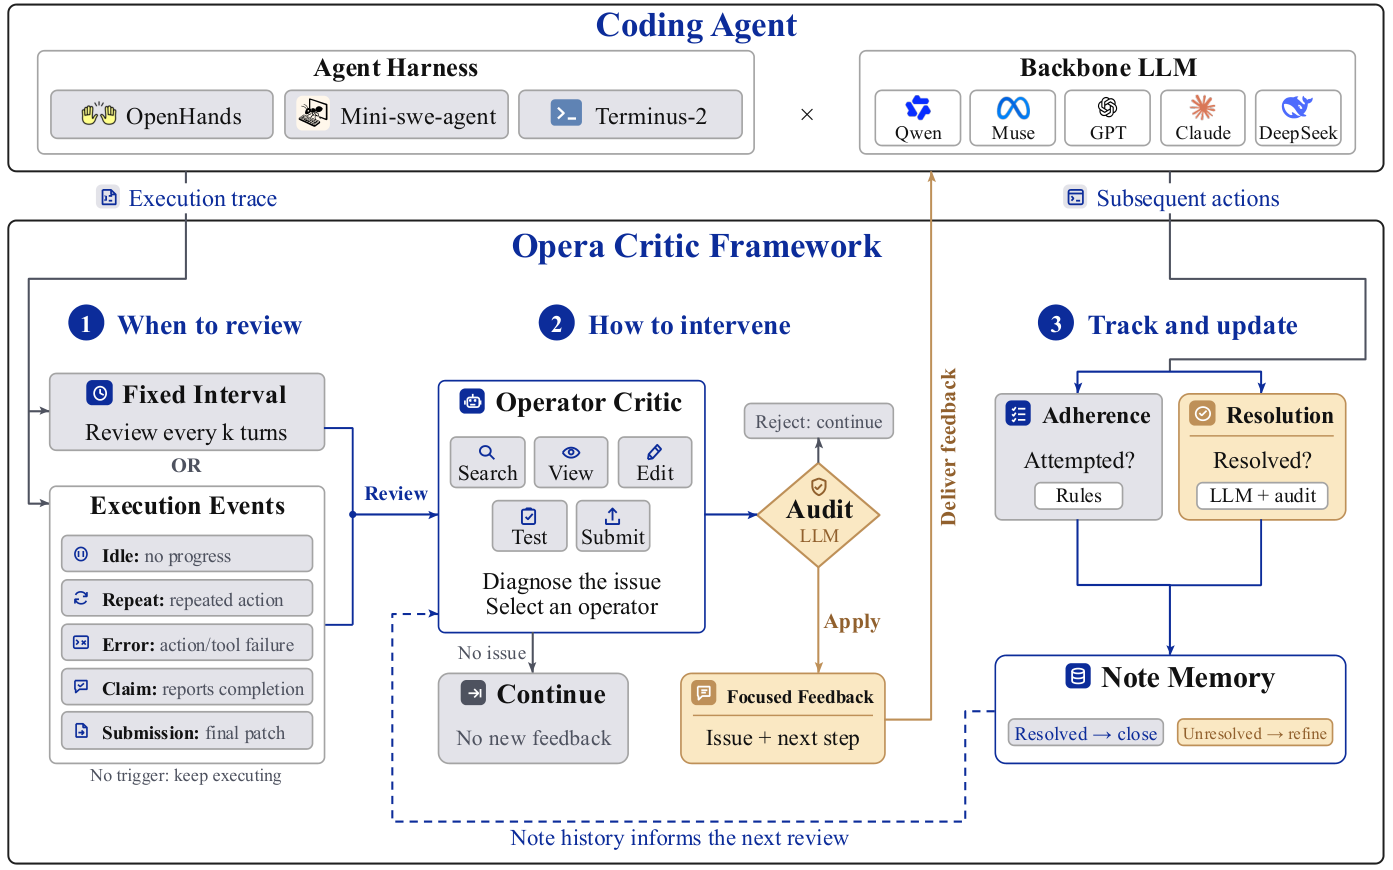
长时程 coding agent 需要及时的纠正,但当反馈误判了正在进行的工作、或未能触及问题根源时,反馈可能变得无效甚至有害。现有 critic 大多聚焦于评估轨迹与生成反馈,却很少追踪反馈交付之后发生了什么。 Opera 是一个言语型 critic 框架,它把每一次纠正都视为一条 持久化笔记,并持续跟踪该笔记,直到被诊断出的问题真正得到解决。具体而言,Opera 通过 周期性触发 与 事件驱动触发 决定何时进行复盘,用 类型化算子 诊断问题,在反馈交付前依据可见证据对其 审计,并追踪 agent 随后的动作,以区分「表面服从」与「真正解决」。 作为 测试时 critic,Opera 在 Terminal-Bench 2.1、SWE-Bench Pro 子集和 DeepSWE v1.1 上,跨四个 policy 模型将无 critic agent 的 resolve rate 分别最高提升 12.4、15.0、8.9 个百分点,并在三个 benchmark 上取得竞争性 critic baseline 中最高的平均 resolve rate;当 policy 进行自我批评时同样有效。 除推理之外,Opera 引导的 rollout 还能提供近似 on-policy 的训练数据:仅用这些数据微调 Qwen3.5-9B,即可在留出的 SWE-Bench Pro 仓库上把 resolve rate 提升 10.2 个百分点,且推理时无需 critic,效果与使用更强模型 rollout 微调相当;同时,在从 Openhands 切换到 Terminus-2 时其性能得以保持,而后者会造成显著退化。代码见 https://github.com/dongyuanjushi/Opera。
论文精读
TL;DR Opera 将每次诊断修正转为持久笔记并追踪至问题真正解决,在 Terminal-Bench 2.1 等基准上将非 critic 智能体的 resolve rate 最高提升 12.4 个百分点。
问题
问题背景
当前长程编码智能体(long-horizon coding agents)在仓库级任务中需要多步推理与工具调用,及时的反馈纠正对成功完成代码修改、测试通过等目标至关重要。
现有方法局限
现有 critic 方法多聚焦于对完整轨迹或中间状态进行一次性评估和反馈生成,但存在几个具体局限:
- 缺乏持续跟踪:反馈发出后不追踪 agent 后续行为,无法判断问题是否真正解决,或只是表面遵从。
- 反馈时机固定或粗粒度:难以在任务执行中适时介入,可能误判正常进行中的工作。
- 诊断缺乏结构化类型:反馈内容往往模糊,没有明确的问题类型和修复建议。
- 缺少证据审计:反馈未对照可见环境证据进行校验,可能基于幻觉或过时观察。
为什么难且重要
长程任务中 agent 的行为分布广且状态依赖强,反馈的准确性和时机直接影响整体轨迹。不准确的反馈不仅无效,还可能打断 agent 的正常推理,造成级联失败。业界对可靠自主编码助手的期待不断提高,测试时扩展方法需要更精细的干预机制,而非仅增加候选数或投票。
行业类比
这与自动驾驶中的主动安全监控相似:系统不能只在碰撞前发出警报,还需要在干预后持续评估车辆是否回到安全状态,避免误干预或过早解除警报。
核心洞察
- Opera 的核心洞察是把 critic 从一次性反馈生成器转变为持续性笔记管理器。它把每次诊断建模为一个 persistent note,从触发、审计、交付到跟踪解决状态形成闭环。与现有 critic 只评估轨迹并生成反馈、不追踪后续不同,Opera 通过混合审查调度(定期 + 事件驱动)、typed operators 诊断、审计可见证据,以及区分 agent 的表面遵从与实质解决,显著减少了无效甚至有害反馈。这种生命周期管理视角让 critic 能适应长程任务中的动态变化,而非静态打分。
- Opera 的审计机制在反馈交付前强制校验诊断与可见证据的一致性,直接回应了“反馈可能有害”的问题。传统 critic 通常直接生成反馈,而 Opera 引入可审计的 typed operators,确保批评建立在可验证事实上,避免 agent 被误导。此外,其跟踪机制区分 `compliance` 和 `resolution`,为 critic 评估提供了新的信号,超越了单纯的轨迹评分。这解释了为何 Opera 在多个基准上提升 resolve rate,并能生成高质量 on-policy 训练数据。
方法
输入与运行流程
Opera 接收编码 agent 在长时任务中的完整轨迹(包括命令执行、文件修改、测试输出等)作为输入,在 agent 运行过程中以 test-time critic 形式介入。
关键模块
- 混合审查调度:结合周期触发(按固定步数或时间间隔)和事件驱动触发(例如检测到新的错误、失败测试、
git commit等关键事件),决定 critic 何时开始审查,避免过早干扰 agent 的进行中工作。 - 操作符类型评审:critic 使用一组类型化操作符(如定位、解释、建议)对当前状态进行结构化诊断,输出类型化的问题描述与修正意图,而非模糊的自由文本反馈。
- 审计笔记管理:每次诊断结果被转化为一条持久笔记(persistent note)。在将反馈发送给 agent 之前,critic 会审计笔记内容与可见证据的一致性,过滤幻觉或证据不足的批评;笔记随后被持续跟踪,根据 agent 后续动作更新状态,区分“表面遵从”与“实际解决”。
输出
输出为面向 agent 的自然语言反馈(verbal feedback)以及内部维护的笔记状态列表。只有笔记被标记为已解决后,对应的诊断问题才关闭;否则会被后续审查再次触发。
与同类方法差异
与现有 critic 仅评估轨迹并生成一次性反馈不同,Opera 将每个修正建模为具有生命周期的持久笔记,并引入审计机制确保反馈与证据对齐,从而减少有害干扰。
实验
实验设计
Opera 作为 test-time verbal critic,在 Terminal-Bench 2.1、SWE-Bench Pro 子集与 DeepSWE v1.1 三个长程编码基准上评估,覆盖四个策略模型。主要对比对象包括非 critic 代理、竞争性 critic 基线,以及策略模型自我批评的场景。
此外,作者利用 Opera 引导的 rollouts 构建近同策略训练数据,对 Qwen3.5-9B 进行微调,在 held-out SWE-Bench Pro 仓库上验证推理时无需 critic 的迁移效果,并测试从 Openhands 切换到 Terminus-2 harness 的鲁棒性。
关键发现
- 作为 test-time critic,Opera 使非 critic 代理的 resolve rate 分别提升 最多 12.4 / 15.0 / 8.9 个百分点(Terminal-Bench 2.1 / SWE-Bench Pro / DeepSWE v1.1)。
- 在三个基准上,Opera 均取得 critic 基线中的 最高平均解决率,且策略模型自我批评时同样获得提升。
- 用 Opera 引导的 rollouts 微调 Qwen3.5-9B,在 held-out SWE-Bench Pro 上 resolve rate 提升 10.2 个百分点,推理时无需 critic,效果与用更强模型 rollouts 微调相当。
- 该微调模型在 harness 从 Openhands 切换至 Terminus-2 时 性能不退化,而普通微调在 Terminus-2 上出现明显下降。
与基线对比的深度解读
现有 critic 方法多在轨迹结束时评估或一次性生成反馈,缺乏对反馈后行为的跟踪。Opera 将每次纠正视为 持久化 note,持续跟进直到问题真正解决,通过 hybrid review scheduling、typed operators 与 audited note management 减少误判与无效反馈。这一机制差异直接体现在跨基准的稳定提升上,尤其是训练数据增益:说明 Opera 的反馈质量足够高,可以作为接近同策略的监督信号,为开源模型构建自举训练管线提供了一条低成本路径。
行业影响
落地场景
Opera 作为测试时 verbal critic,可直接嵌入长时程编码代理(如 Devin、OpenHands、Terminus-2 等)的循环中。典型场景:
- 企业级软件工程自动化:在 issue 到 PR 的自动修复流水线中,Opera 持续追踪代理行为,通过 persistent notes 标记未解决诊断项,避免无效反馈干扰进行中的工作。
- AI 辅助代码审查:对复杂重构或跨文件修改任务,Opera 的 audited note management 可过滤缺乏证据的批评,减少误报。
商业价值
- 降本:提升一次通过率(resolve rate 最高 +15.0 pp),减少人工介入与多轮重试的算力消耗;利用 Opera-guided rollouts 生成近似 on-policy 训练数据,微调小模型(如 Qwen3.5-9B)即可获得匹配更强模型的性能,显著降低数据标注与推理成本。
- 增收/体验:对于 AI 编程助手订阅服务,更高的任务解决率直接提升付费转化与留存;企业客户可将该 critic 作为质量守门员,保证交付代码的可靠性。
与现有产品/工作流接口
- 中间件模式:将 Opera 封装为独立的 critic service,通过 API 接收代理轨迹、返回结构化反馈与 note 状态。现有 agent harness 只需少量适配即可调用。
- 训练数据管道:在离线 RLHF / SFT 流程中,用 Opera 筛选并标注高质量 rollout,替代昂贵的人工偏好标注或强模型蒸馏。
- 切换 harness 稳健性:论文显示 Opera 微调模型在 OpenHands 切换到 Terminus-2 时性能保持,证明其接口抽象可降低工具链迁移风险。
具体落地 use case:电商平台智能客服/后台自动化采用编码代理自动修复订单系统 bug,Opera 作为 critic 减少误判并跟踪问题直到解决;金融科技企业用其生成合规代码修改的训练数据,训练内部小型 LLM 用于自动化测试生成,节省人力。
局限
- Opera 的效果高度依赖底层批评者模型的能力。论文在多个策略模型上验证,但分析中显示当使用较弱模型作为批评者时,诊断和审计的可靠性可能下降,从而限制提升幅度。实验集中在软件工程类长时程任务(如 Terminal-Bench、SWE-Bench Pro、DeepSWE),对其他类型的长期代理任务(如多步工具调用、GUI 自动化、开放式研究任务)缺乏验证,泛化性存疑。此外,论文虽然展示了用 Opera 引导的 rollout 微调小模型后无需推理时批评者,但训练数据生成过程本身需要强批评者,这可能带来额外的训练成本与偏差传递。
- 持久笔记机制会累积大量文本记录,随着任务步数增长,可能超出上下文窗口限制,或显著增加每次审查的 token 消耗与延迟。审计系统基于可见证据进行过滤,但证据本身可能不完整,导致误判:例如某些正确的修复暂时不会在可观察轨迹中体现,却被审计否决,从而错失有效反馈。混合评审调度中的事件驱动触发器(如检测到特定文件变更或错误模式)需要针对不同环境和代理框架定制阈值与规则,普适性未经充分测试,实际部署时可能需要大量人工调参。
- 相比现有批评者基线,Opera 在三个基准上取得了最高平均 resolve rate,但提升幅度在不同策略模型和基准间波动较大,部分场景下可能仅与 Self-Critique 等简单方法相当。论文未与更复杂的多代理批评系统或基于强化学习的在线批评者训练方法进行全面对比,无法确定其相对优势的边界。此外,用于训练的策略模型微调数据完全来自 Opera 引导的 rollout,这种近似 on-policy 的数据可能继承批评者的系统性偏差(如过度谨慎或对特定操作符的偏好),使得最终策略在分布外场景下表现不确定。