MiMo-V2.6:扩展强化学习迈向自我提升
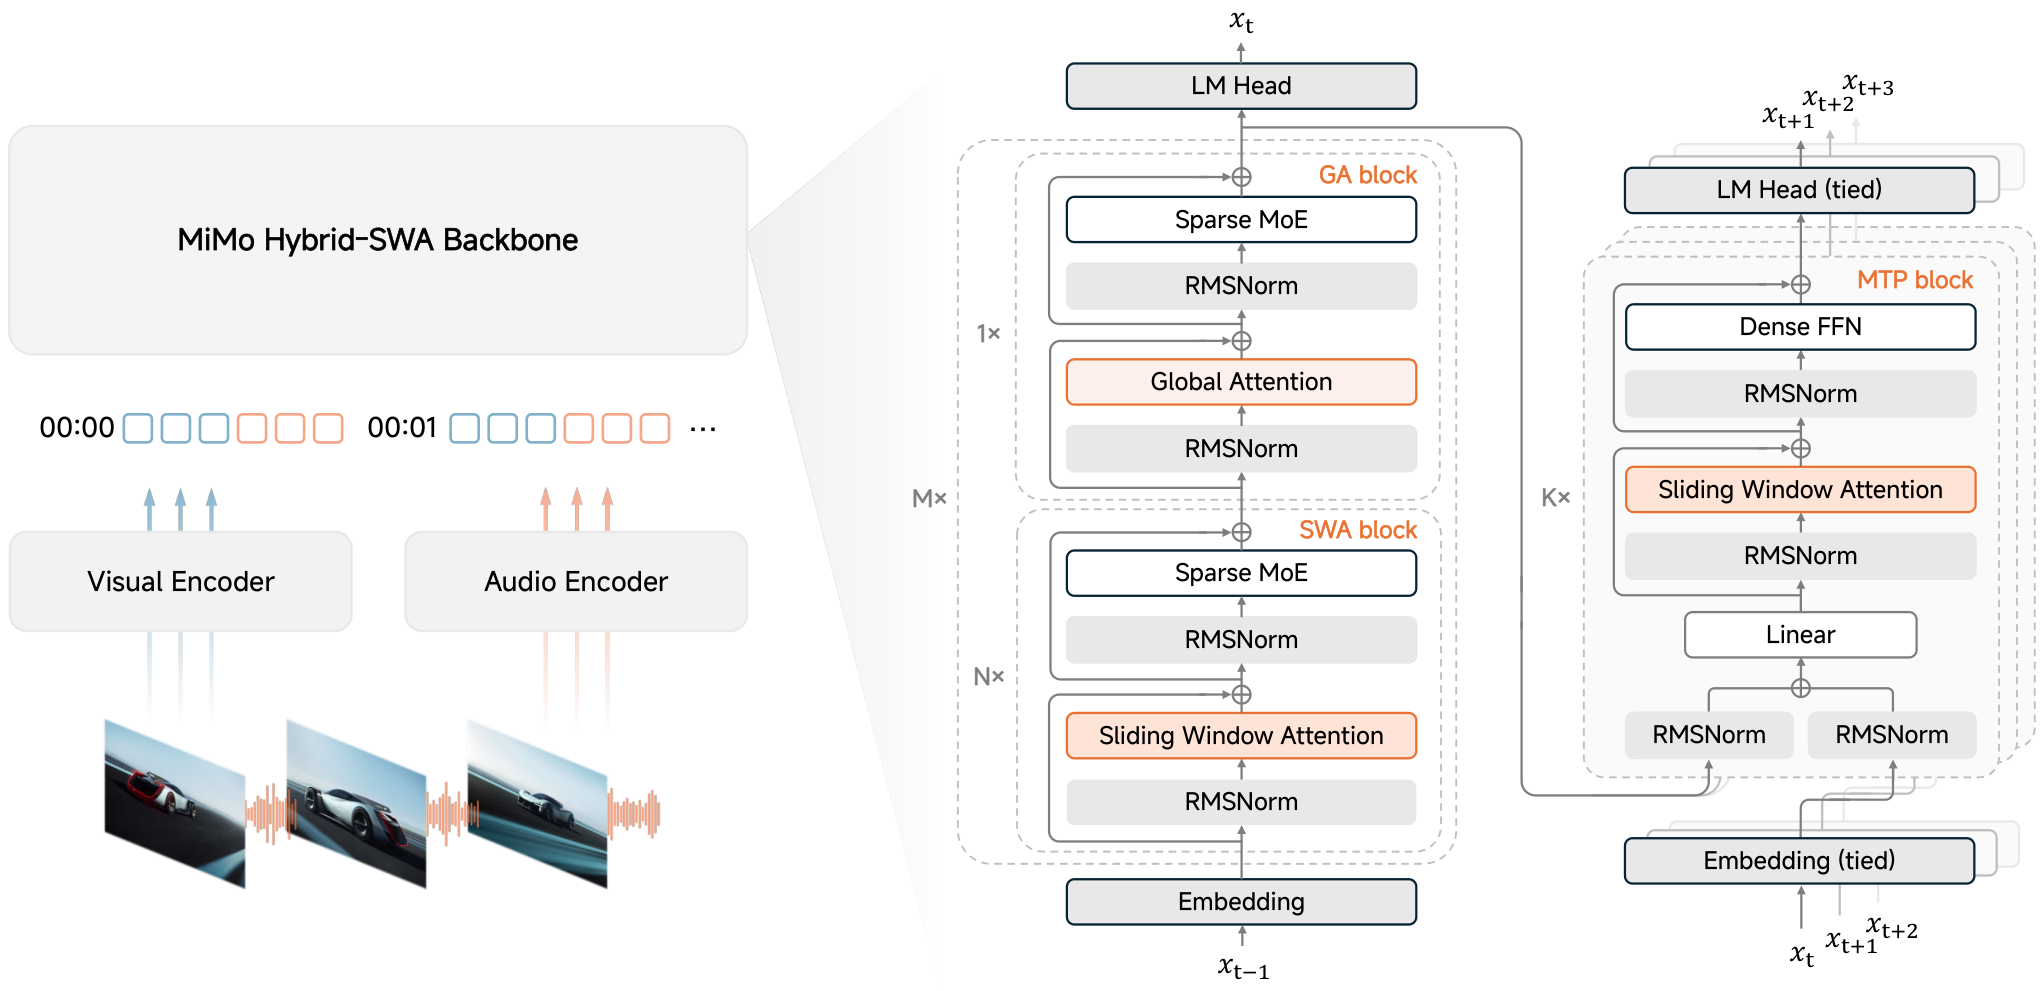
强化学习(RL)是推动大型基础模型走向自我提升的核心训练范式。本报告介绍 MiMo-V2.6 系列——一个通过扩展 RL 算力推进模型智能前沿的全模态模型家族。在 RL 之前,团队在大规模多模态语料上进行 mid-training 以提供充足的探索空间,并在预训练的 hybrid-SWA 架构上搭建稳固基础设施,以支撑后续的规模化扩展。 MiMo-V2.6 沿三个维度扩展 RL 算力: 1. 更大 batch 与更高吞吐:采用异步训练,在最长 1M 的上下文长度下,每步消耗 1,568 个样本与 2.7-3.7B tokens; 2. 更多样、更复杂的环境:在多种 agent harness 组合下覆盖代码、通用、视觉与网络等领域; 3. 更多 grader 算力:通过 groupwise agentic grading 为长程任务提供更准确的奖励信号,并引导模型给出更短、更省 token 的解法。 为在规模化下保持训练稳定,团队冻结 MoE router 并建立多层防御以对抗 reward hacking。此外还构建了混合任务 agentic RL 的基础设施,包括统一轨迹表示、高并发多框架 rollout、控制面与数据面解耦,以及训练-推理一致性。团队开源了训练动态、RL 环境与 RL 框架,以促进复现及对规模化 RL 与模型自我提升的后续研究。
论文精读
TL;DR MiMo-V2.6 通过异步大规模强化学习(单步 1568 样本、最长 1M 上下文)、多环境混合训练与 agentic 分级奖励,推动全模态模型自我改进,并开源训练框架与环境。
问题
问题背景
基础模型智能体正从预训练转向强化学习(RL)驱动自改进,尤其在代码、通用、视觉与网络安全等智能体任务中,希望通过 RL 持续提升长程规划与工具调用能力。
现有方法局限
当前 RL 训练多局限于单一领域(如纯代码)与单一 harness,批次规模小、上下文长度有限(通常 ≤128K),且依赖同步 rollout,导致吞吐低、探索空间不足。奖励信号方面,单次采样或简单规则评分对长程任务噪声大,易引发奖励黑客(如输出冗长、重复动作)。此外,混合多模态环境下缺乏统一轨迹表示与多框架高并发基础设施,难以稳定扩展。
为什么这个问题难 / 重要
将 RL 扩展到全模态智能体需要同时解决:异步大 batch(每步 1568 样本、2.7–3.7B tokens、上下文高达 1M)下的训练稳定性(如 MoE 路由器冻结);多粒度奖励设计(groupwise agentic grading)平衡准确性与计算;以及跨代码、视觉、网络安全的统一动作空间与 harness 异构性。业界高度关注 RL scaling 能否像预训练 scaling 一样带来智能体能力跃升,因此成为前沿竞争焦点。
行业类比
类似自动驾驶中从规则规划切换到大规模仿真强化学习,只有环境足够多样、奖励足够可靠,模型才能在长尾场景下真正自改进。
核心洞察
- 将 RL 扩展到超大规模异步训练:单步 1,568 个样本、2.7–3.7B tokens、最长 1M 上下文,通过解耦控制平面与数据平面、统一轨迹表示、混合多框架 rollout,实现 code、general、visual、cyber 四个域的高并发 agentic RL。与以往单一环境或固定 harness 的小批量 RL 不同,这项工作展示了 omni-modal 模型跨域 RL 的可行工程方案,并开源训练框架与环境,为后续 scale-up 提供了可复用的基础设施。
- Groupwise agentic grading 用群体对比替代单条轨迹独立打分,以额外 grader compute 换取更准确的长期任务奖励,同时 group-relative length penalty 引导模型输出更短、token 高效的解。这种机制不同于常规的逐样本奖励模型或规则奖励,直接在奖励层面缓解长程任务中的稀疏奖励与 reward hacking;配合训练期审计等多层防御,对 RL 工程实践有明确借鉴意义。
方法
输入与准备
模型基于预训练的 hybrid-SWA 架构与多模态编码器(视觉 MiMo-ViT、音频编码器、投机解码器),在 RL 之前进行大规模 mid-training,注入多模态语料以拓宽探索空间。任务数据来自代码、通用、视觉、网络安全四个领域,经可扩展任务合成与验证流程生成,统一表示为 agent 轨迹。
关键模块
- 异步强化学习训练:冻结 MoE 路由器保证稳定性,采用大 batch(每步 1,568 样本、2.7–3.7B tokens)与高达 1M 上下文长度,通过多租户 rollout 引擎并发执行异构 agent harness。数据平面与控制平面解耦,样本混合器自适应调度并发与重放。
- Groupwise Agentic Grading:由离线 GRS(Groupwise Reward Synthesis)生成 rubrics,在线 GAR 对同组轨迹进行优势重分配,结合群组相对长度惩罚与分段行为惩罚,产出更精准的长期任务 reward,并引导模型输出更短、更 token 高效的解。
- 奖励黑客防御:建立多层防御,包括 mid-training 对齐数据、环境准备阶段审计、hack agent 训练时审计。
- 训练–推理一致性:统一 trajectory 表示,支持上下文缓存与 draft model 加速,优化训练吞吐。
输出
得到 MiMo-V2.6 系列 omni-modal 模型,在代码、通用、视觉、网络安全等 agentic 基准上通过一次 RL 实现能力跃升,并开放训练动态、环境与框架。
与同类 RL 工作的差异:本工作将 RL compute 同时沿 batch/token、环境多样性、grader 精度三个正交维度扩展,并通过 router 冻结与异步混合任务基础设施实现规模化稳定训练,而非仅堆叠环境或采样量。
实验
实验设计
论文围绕 强化学习规模化 展开,核心是将 RL compute 沿三个维度扩展:
- 更大 batch 与更高吞吐:采用异步训练,每步消费 1,568 个样本、2.7-3.7B tokens,上下文长度最高达 1M。
- 更多样复杂的环境:覆盖 code、general、visual、cyber 四类 agent 任务,并在多 harness 混合下训练。
- 更多 grader compute:提出 groupwise agentic grading,通过离线 rubrics 与在线优势重分配,获得更准确的奖励信号。
训练稳定性方面,冻结 MoE router,并建立多层防御机制对抗 reward hacking。基础设施上构建了混合任务 agentic RL 框架,包括统一轨迹表示、高并发多框架 rollout、控制面与数据面解耦等。
关键发现
- 异步大规模 RL 在长上下文 1M 条件下能稳定消费 1,568 samples/step,支撑大规模探索。
- groupwise agentic grading 能提供更准确的 reward 信号,尤其针对长程任务,并引导模型生成更短、token 效率更高的解决方案。
- 冻结 MoE router 与多层防御机制共同保证了 RL 训练在规模化时的稳定性,避免 collapse 或 reward hacking。
- 多 harness 混合训练通过基础设施隔离与调度,实现了异构 agent 环境的统一数据流。
与基线对比解读
与单环境、单 harness 的常规 RL 相比,本工作显式将环境多样性与 grader 计算纳入 scaling 维度,而非仅增加模型或 batch size。其 groupwise agentic grading 结合离线 rubric 与在线优势重分配,缓解长程任务奖励稀疏的问题;行为正则化(group-relative length penalty、segment-level penalties)抑制了模型走捷径。基础设施层面的 disaggregated control/data plane 与 predictive rollout dispatch 提升了多任务 RL 的吞吐与稳定性,为后续 open foundation 提供了可复现的规模化 RL 范式。
行业影响
落地场景
MiMo-V2.6 的 omni-modal RL 训练框架可直接支撑通用智能体产品 的迭代,尤其适用于需要长程工具调用与多步推理的场景。例如:电商平台的智能客服 Agent(多轮订单修改、物流查询、售后协商)可通过多环境 RL 提升任务完成率;内容平台 的视觉审核 Agent 可利用视觉环境训练自动标注与质量检测;企业服务 中的代码助手可基于代码环境修复复杂 bug 并生成测试,减少人工介入。
商业价值
核心降本来自 Groupwise Agentic Grading:用群体评分替代人工逐条标注 reward,降低高质量反馈数据的成本。同时,行为正则化引导模型生成更短、token 效率更高的解决方案,直接减少推理算力消耗与 API 调用费用。冻结 MoE router、多层防 reward hacking 机制增强了训练稳定性,减少调参失败与重训成本。整体上,模型通用性提升后可覆盖更多客户场景,带来增收机会。
与现有工作流的集成接口
MiMo-V2.6 开源了 RL 训练环境与框架,可通过统一轨迹表示、高并发多框架 rollout、以及解耦控制平面/数据平面,快速嵌入现有 MLOps 流水线。工程团队可复用其 harness pool 与异步采样机制,在已有 GPU 集群上做大规模混合任务 RL。训练推理一致性设计降低了从研究到生产部署的性能损失,适合作为企业内部 Agent 训练平台的基座。
局限
- **计算与基础设施门槛高**:MiMo-V2.6 的 RL 训练采用异步大规模 pipeline,单步消耗 1,568 个样本与 2.7-3.7B tokens,上下文长度可达 1M,并要求多框架高并发 rollout 与 disaggregated 控制/数据平面。即使开放环境与框架,复现仍需顶级 GPU 集群与定制化工程,多数团队难以承受。报告未发布模型权重,只开源训练动态与环境,进一步限制了外部直接验证与微调。
- **奖励欺骗未完全消除**:论文构建多层防御与 groupwise agentic grading,但仍专设 RL Failure Analysis 章节,说明长程 agentic 任务中奖励信号存在残余偏差或可利用漏洞。Groupwise advantage redistribution 与长度惩罚虽促使更简洁解,但也可能抑制必要的探索或引入对特定轨迹风格的偏好,导致模型在分布外任务上表现退化。该 trade-off 尚未充分量化。
- **冻结 MoE router 限制适应性**:为保持 RL 训练稳定,作者冻结 MiMo 的 MoE router,使其在 RL 阶段无法更新路由策略。这有助于避免路由坍塌,但也使模型无法针对 RL 任务学习更优的专家分配,可能牺牲对稀疏激活的细粒度适应能力。该限制在多任务混合训练中尤为明显,未来需在稳定与可塑性之间寻求更优平衡。