In-Distribution Forcing:测试时面向长视频生成的方法
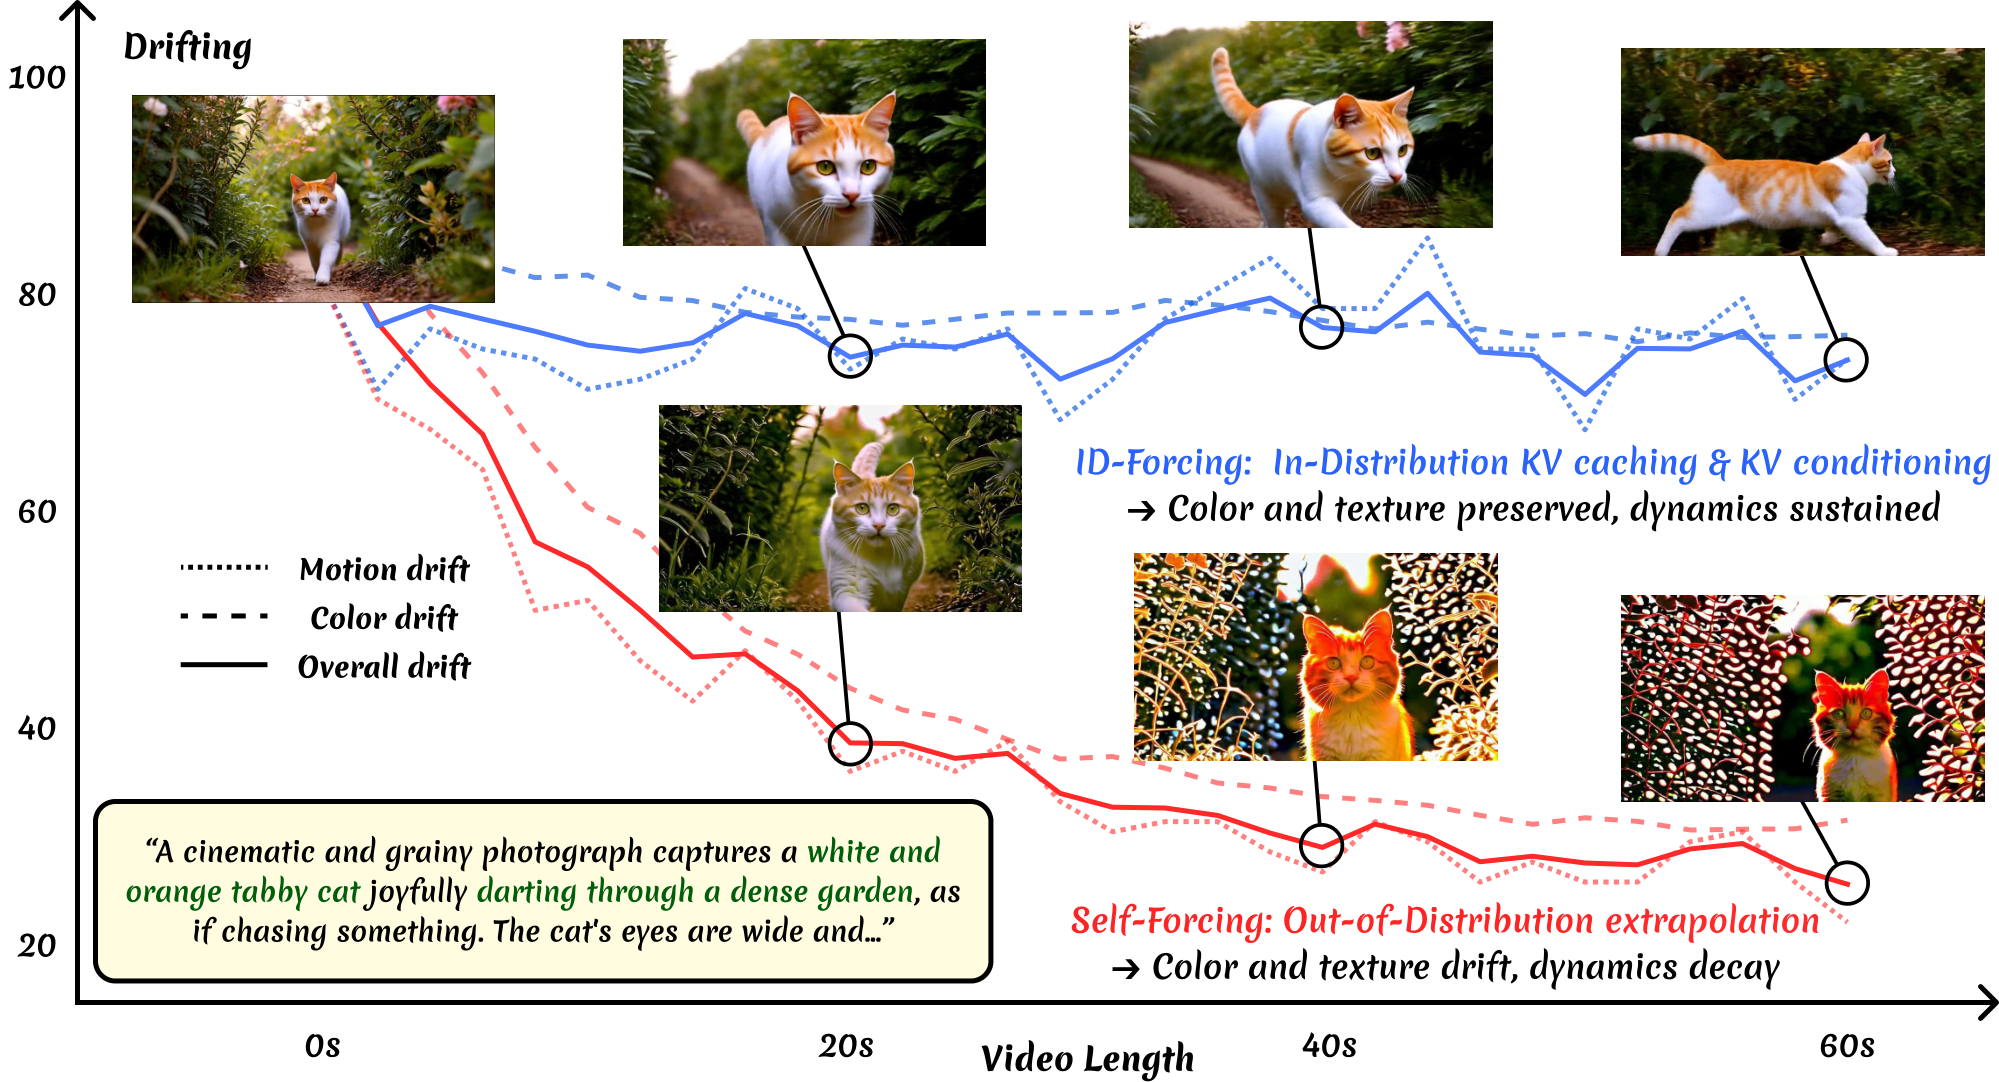
现代自回归(AR)视频扩散模型在短视频生成上表现出色,但长视频生成仍受漂移 问题困扰:颜色与纹理偏移、运动动态衰减。现有工作主要依赖 KV conditioning,通过选择或修改缓存的 key-value(KV)条目来缓解漂移。 然而,我们发现仅靠 KV conditioning 并不充分,因为它假设缓存的 KV 条目保持 in-distribution。该假设在超出训练视界后失效:rollout 过程中没有任何机制约束 KV 条目的构造,从而引发 KV-provenance 问题,即缓存条目本身变成 out-of-distribution(OOD)。 为此,我们提出 In-Distribution Forcing(ID-Forcing),一个测试时框架,使 KV 缓存与 KV conditioning 都与训练配置对齐。其关键机制 self-caching 从源头上防止 OOD KV 条目:每个 chunk 在缓存时不关注先前的 KV 条目,使滚动窗口严格保持 in-distribution。由此,ID-Forcing 能将短视频模型无缝扩展到分钟级视频生成。 大量评估表明,我们的方法在标准视频生成 benchmark 上保持竞争力,同时在缓解漂移方面显著优于先前工作,并得到了我们的漂移指标与用户研究的验证。
论文精读
TL;DR ID-Forcing 通过自缓存让 AR 视频扩散模型在测试时保持 KV 分布与训练一致,解决长视频生成中的漂移问题,可将短时模型扩展至分钟级。
问题
问题背景
现代 自回归视频扩散模型 在短时视频生成上表现优秀,但生成分钟级长视频时会出现 漂移 :颜色纹理偏移、运动动态衰减,影响视觉一致性。
现有方法局限
主流方案依赖 KV conditioning ,通过选择或修改缓存中的 key-value 条目来缓解漂移。但这类方法隐含假设缓存的 KV 条目仍处于训练分布内。实际上,在测试时 rollout 超出训练 horizon 后,没有任何机制约束 KV 条目的构造过程,导致 KV-provenance 问题 :缓存条目自身变为 out-of-distribution (OOD) 。此时即使做 KV conditioning,也是建立在不可靠的缓存之上,无法从根本上阻止漂移。
为什么难且重要
长视频生成对 world models 、流媒体内容生成、长故事叙述等应用至关重要。难点在于自回归 rollout 的累积误差使模型逐步偏离训练分布,而训练阶段很难覆盖所有测试时的分布偏移。业界对长视频生成的兴趣持续上升,但缺少能在测试时有效对齐训练分布的简单通用框架。
行业类比
这与自回归语言模型中的 exposure bias 类似:模型在推理时逐步生成,误差累积导致输入偏离训练分布,最终产生质量退化,只是视频生成中表现为视觉内容的漂移。
核心洞察
- ID-Forcing 指出长视频扩散中的 KV-provenance 问题:缓存 KV 自身在 rollout 中会漂移出训练分布,而不仅是 KV conditioning 不足。现有方法假设缓存条目始终 in-distribution,但该假设在超出训练时长后失效;ID-Forcing 通过 self-caching 使每个 chunk 不依赖先前 KV,从源头杜绝 OOD 缓存,这是对 AR 视频扩散测试时误差累积机制的根本修正。
- ID-Forcing 提供纯测试时框架,无需重新训练或微调即可将短时视频模型扩展到分钟级生成。它与训练更长上下文或改动架构的方法不同,直接对齐 KV caching 与 conditioning 的训练配置,避免了对缓存内容的启发式修改,工程实现轻量且通用,同时通过漂移指标和用户研究验证了超越标准 FVD 的实际漂移抑制效果。
方法
方法流程
输入:预训练的短时域自回归视频扩散模型与文本/首帧条件,按固定长度将目标视频切分为多个 chunk。
- Self-caching(关键缓存模块):生成新 chunk 时,使用历史 KV cache 进行条件生成;但缓存该 chunk 的 KV 时,仅基于 chunk 自身的自注意力计算,不引入跨 chunk 注意力。这样每条 KV 的 provenance 与训练分布一致,避免 rollout 后期 KV 变得 OOD。
- 精确滚动窗口条件:在当前 chunk 的去噪过程中,只允许关注最近 N 个 chunk 的缓存 KV,窗口大小与训练时上下文长度严格对齐,不做 KV 选择或修改,保证条件输入也在分布内。
输出:逐 chunk 拼接得到分钟级长视频,且色彩/纹理漂移与运动退化显著减轻。
原文指出:KV conditioning alone 假设缓存 KV 保持 in-distribution,但 rollout 时无约束,产生 OOD KV。ID-Forcing 通过 self-caching 在源头阻断该路径。
与同类方法差异:现有 KV conditioning 仅选择或修改缓存项,仍假设缓存本身分布正确;ID-Forcing 额外约束 KV 缓存来源(self-caching),且条件使用精确滑动窗口而非启发式裁剪。工程上,该方法无需重训即可扩展短模型到长视频,推理开销仅增加一次 cache 重算。
实验
实验设计
作者在标准视频生成基准上评估 ID-Forcing,与依赖 KV conditioning 的基线方法进行对比。除常规视觉质量与文本对齐指标外,重点引入专门度量漂移的指标(如色彩/纹理一致性、运动动力学保持),并通过用户研究验证长期生成的主观质量。
关键发现
ID-Forcing 在短时视频生成任务上保持竞争性能,未牺牲生成质量。在扩展至分钟级序列时,显著缓解了颜色/纹理漂移与运动衰减问题,相对先前工作提升明显。用户研究也印证了其生成结果具有更好的时序稳定性与观感一致性。
与基线对比的深度解读
先前方法仅通过 KV conditioning 从缓存中选择或修改键值对,隐含假设缓存项仍在训练分布内;但 rollout 超过训练视野时,缓存项本身会逐渐偏离分布(KV-provenance 问题)。ID-Forcing 从缓存构造源头解决,self-caching 让每个 chunk 不关注先前 KV 条目,保持滚动窗口严格 in-distribution。这一差异解释了为何 ID-Forcing 能在长序列上稳健抑制漂移,而仅靠 conditioning 的方法随长度增加性能衰退。
工程启示:该测试时框架无需重新训练,可直接应用于现有短时 AR 视频扩散模型,为低成本扩展生成长度提供可行路径。
行业影响
落地场景
长视频生成是 AR 视频扩散模型的主要瓶颈,ID-Forcing 使短时模型直接扩展至分钟级视频,适用场景包括:
- 流媒体与短视频平台:自动生成故事化长视频、系列化内容,减少逐段生成后的人工拼接与色彩校正。
- 世界模型与自动驾驶仿真:长时间一致的环境演化视频,用于训练感知模型或仿真测试。
- 电商与广告:生成完整商品展示视频、虚拟主播口播长内容,避免漂移导致的产品外观变化。
- 在线教育:自动生成连贯的课程讲解视频,保持教师形象与板书稳定。
商业价值
核心价值在于 测试时零训练成本 地将短时模型泛化到长视频,直接降低:
- 算力与数据成本:无需再训练或微调,缩短上线周期。
- 人工修正成本:漂移导致的后期修图、重生成大幅减少。
- 体验提升:长视频色彩、纹理、运动连贯性显著改善,用户留存与转化率提高。
ID-Forcing 在标准 benchmark 上保持竞争力,同时漂移指标与用户研究显著优于现有方法,可支撑分钟级商业视频生成服务。
与现有产品/工作流的接口
ID-Forcing 是 测试时框架,可直接嵌入现有 AR 视频生成推理管线,不改变模型权重。集成路径包括:
- 在现有扩散模型推理代码中替换 KV 缓存构造逻辑,加入自缓存 (
self-caching)。 - 保持模型输入输出接口不变,对用户透明。
- 与已有的 KV conditioning 方法兼容,可组合使用。
该框架已在 GitHub 开源,便于快速验证和部署。
具体落地 Use Case
- 电商商品视频:为商品自动生成 1-3 分钟展示视频,镜头围绕产品旋转、场景切换,ID-Forcing 保证产品颜色与纹理不漂移,减少退货率并提高转化。
- 企业培训内容生成:自动生成包含同一虚拟讲师形象与稳定背景的系列长课程,省去逐段拍摄与合成,降低内容生产成本。
局限
- 论文未充分讨论 self-caching 对长程时序一致性的影响。每个 chunk 在缓存时**不参与之前 KV 条目** 的注意力计算,虽然保证了缓存条目 in-distribution,但也**切断了跨 chunk 的直接信息通路**,可能导致视频中远距离的物体运动或场景变化缺乏连贯性。与使用全局注意力或 KV 融合的方法相比,该方法可能更依赖滚动窗口内的局部上下文,在需要长期记忆的任务(如复杂叙事或多主体交互)上易累积误差。作者仅在漂移指标上验证,未量化评估全局一致性的潜在损失。
- 方法可能带来**额外的推理开销**。self-caching 需要为每个 chunk 重新构建 KV 缓存,且滚动窗口要求保留多个 chunk 的缓存,内存占用随视频长度线性增长(尽管窗口大小固定,但总缓存量仍高于单次前向)。与基于 KV 压缩或选择的方法(如仅保留关键帧或聚类 token)相比,其在长视频生成场景下的内存与计算效率可能处于劣势。论文未报告详细的推理时间或显存对比,难以评估实际部署成本。
- 实验验证范围相对有限。论文主要在特定视频扩散模型上评估,并依赖自定义的漂移指标和用户研究,但未在多种架构(如非自回归模型、基于 Transformer 的 AR 生成器)或更大规模数据集上验证泛化性。与最新 SOTA 方法(如 KV 压缩、条件重写)的直接对比可能不足,尤其在标准基准上的竞争力需要更多模型和任务的支持。此外,对长视频中突发场景切换或强运动变化的鲁棒性未展示。