Foresight:无需重训练的流式 VLM 中的未来感知规划
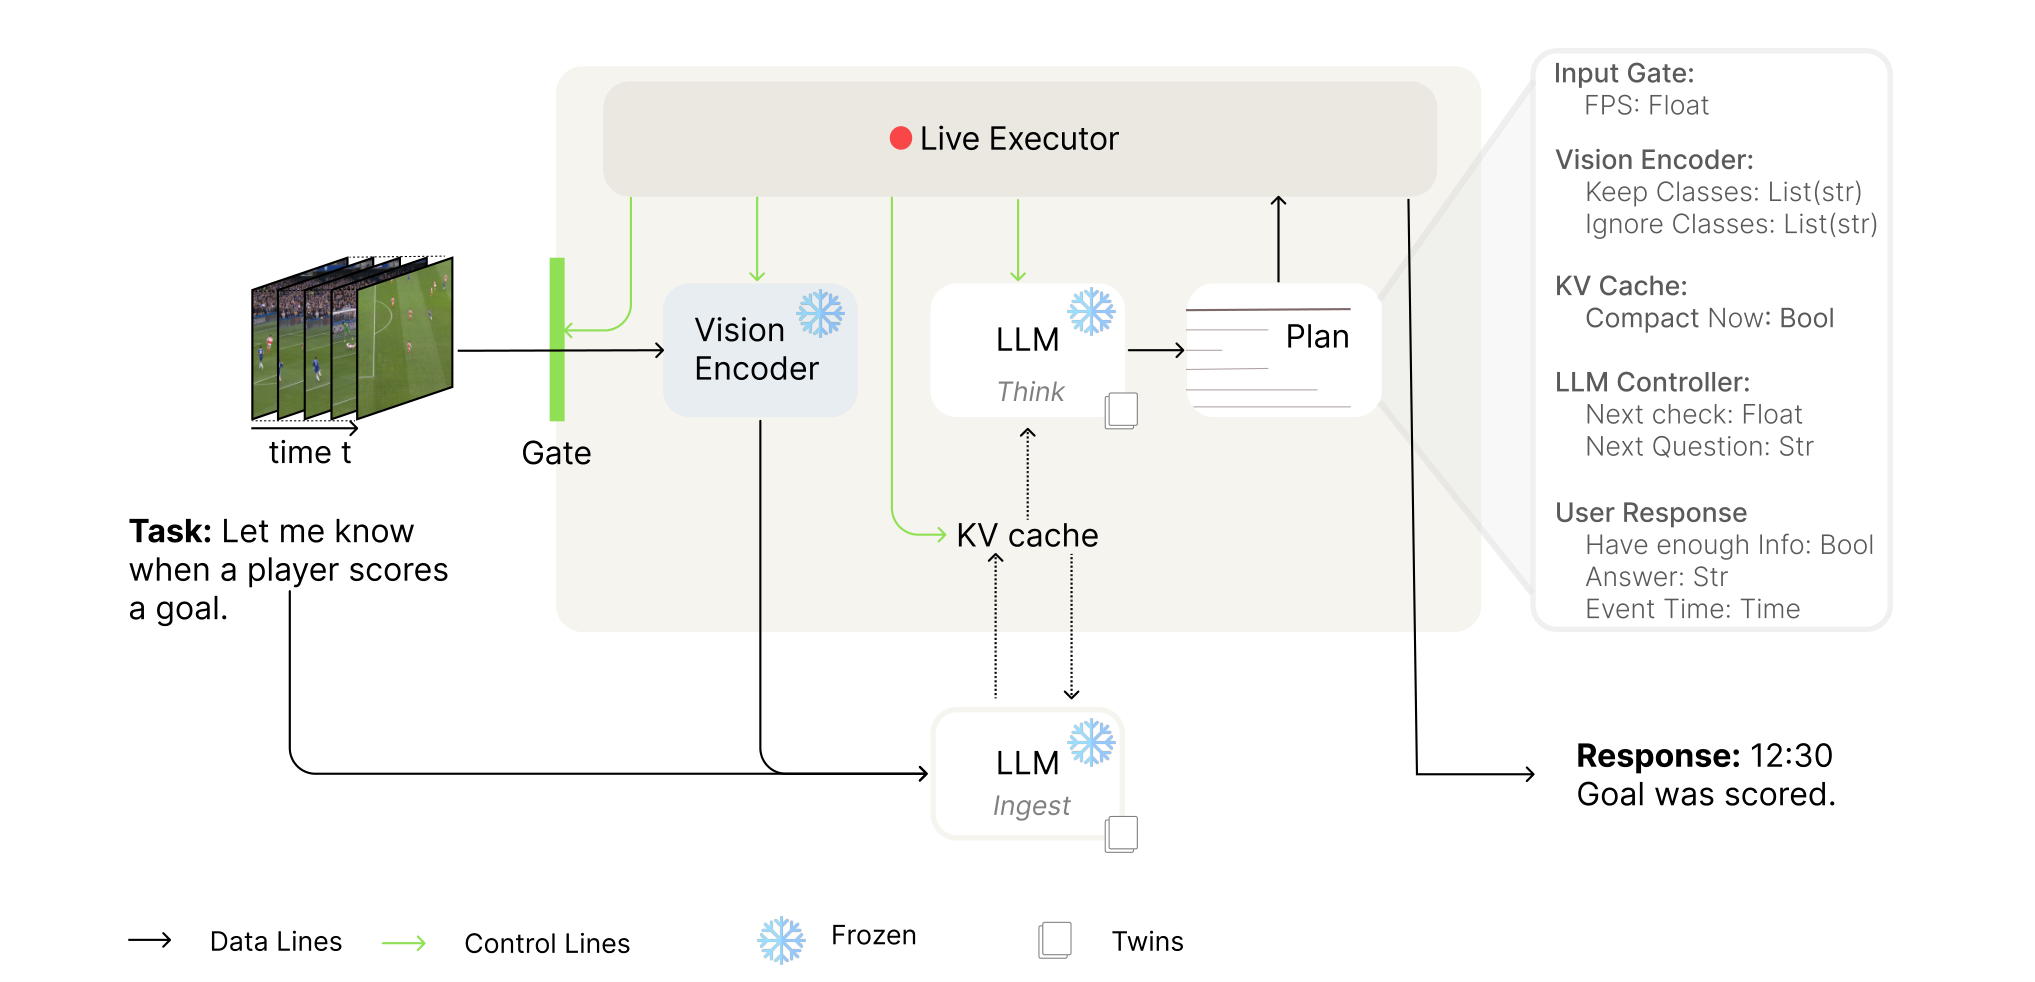
现有流式视觉语言模型(VLM)能持续感知并推理视觉流,但其计算路径在整段推理过程中保持固定。因此,它们无法随场景动态变化而调整计算,而不同的未来事件恰恰需要不同层级、不同形式的感知。 作者指出,流式 VLM 天生具备预判近期未来的能力,并利用这一能力以免训练的方式动态配置未来计算。这一设想面临三重挑战:预判必须足够可靠以指导计算、规划必须与流式推理并行进行、在线重配置的开销必须可忽略。为此提出 FORESIGHT,一种双流架构,由两个 Siamese LLM 组成,共享权重、输入编码器与 KV cache。第一个 LLM 持续处理流入的 token,第二个则跑在流的前方,预判未来上下文、规划未来计算并生成任务响应,且不打断流式推理。每份规划决定何时下一步推理、届时检查什么、以多高的密度采样,从而把瞬时证据与持久控制分离。 生成的计算规划通过高效重配置协议在线执行,结合 schema-guided decoding 与轻量级 diff-based 更新,实现低开销的动态适配。 在冻结的 Qwen3-VL-8B 骨干上,FORESIGHT 于 OmniPro Online 评测取得 23.0 平均联合 F1,比最强训练基线高 9.5%;同时在 StreamingBench 上提升 6.7、在 OVO-Bench 上提升 15.4,当证据在视频流中较晚到达时增益最大,达 18.7。源码将公开。
论文精读
TL;DR Foresight 挖掘流式 VLM 的固有未来预测能力,用双流共享权重架构在线规划未来感知计算,无需重训练即显著提升动态视频流上的推理性能。
问题
问题背景
流式视觉语言模型(Streaming VLM)在实时视频理解、具身智能等场景中成为核心组件,研究者关注如何在连续视觉流上持续推理,同时平衡精度与延迟。
现有方法局限
主流流式 VLM 在推理期间保持固定的计算路径:要么均匀采样关键帧,要么以固定频率查询 LLM,感知粒度与推理深度不随场景动态调整。这导致两种常见失效模式:
- 简单场景中过度计算,浪费算力并抬高端到端延迟;
- 复杂或事件密集片段中算力不足,遗漏关键视觉证据。 部分训练式方法试图引入自适应抽样或提前预测未来帧,但需要额外标注未来事件并修改模型权重,部署成本高,且对新任务/新场景泛化有限。
为什么这个问题难 / 重要
实现未来导向的按需感知需要同时满足三个相互冲突的条件:
- 未来预判足够可靠:模型必须能从已见 token 推断即将出现的语义事件,但视觉流中的未来不确定性高;
- 规划与流式推理并发:规划过程不能阻塞当前感知与响应,否则破坏在线性;
- 重配置开销近乎为零:动态调整采样密度、检查点或提示 schema 不能引入显式重复计算或 KV cache 重建。
行业对可部署的流式 AI 系统有强烈诉求——无论是车路协同、机器人操作,还是长视频监控,都希望算力按需分配给“即将发生的事件”,而不是固定均匀地消耗。这类似于自动驾驶系统预测前车轨迹以提前调整传感器与计算资源的注意力分配。
核心洞察
- - 将流式 VLM 本身对未来事件的短期预测能力转化为计算控制信号,实现了无需训练的动态感知资源配置。与现有方法要么固定采样密度、要么依赖后验重读或额外训练的 reinforcement learning 策略不同,Foresight 直接利用模型在推理过程中自然涌现的 anticipation 能力,通过一个单独的规划流生成未来计算计划,决定何时推理、检查什么以及采样密度,从而让计算开销随场景事件密度自适应变化。
- - 双流 Siamese 架构将规划与执行彻底分离,通过共享权重、输入编码器和 KV cache 实现并发且低开销的在线重配置。一个 LLM 持续处理流式 token,另一个 LLM 在流前方运行预测未来上下文并生成控制计划,两者互不阻塞。配合 schema-guided decoding 和轻量 diff-based 更新,将瞬时证据与持久控制状态分离,解决了 streaming VLM 中动态调整计算路径的时序冲突和开销瓶颈,为实际部署提供了可工程化的方案。
方法
输入:连续视觉流,以 token 序列形式进入系统,无显式分段或未来帧信息。
核心架构:Foresight 采用双流 Siamese LLM,两个 LLM 共享权重、输入编码器与 KV cache。第一个流(在线感知流)实时处理传入 token,负责当前时刻的理解与任务响应;第二个流(未来规划流)运行在流前方,基于已见上下文预测未来场景动态,并生成计算计划。
规划与重配置:规划流输出的计划指定“何时推理”(触发时机)、“检查什么”(注意力目标)以及“采样密度”(感知粒度),并将瞬态证据与持久控制分离。该计划通过 schema 引导解码 生成结构化指令,再经 轻量级 diff 更新 在线修改第一个流的计算路径,避免重新初始化或全量更新,保证低开销。整个过程不中断流式推理,且无需对骨干网络进行任何训练。
输出:动态适配后的实时感知结果或任务响应,以及持续更新的计算策略。在冻结的 Qwen3-VL-8B 骨架上,Foresight 在 OmniPro Online 上达到 23.0 mean joint F1,比最强训练基线高 9.5%。
差异点:与现有固定计算路径的流式 VLM 不同,Foresight 首次在训练无关的前提下,利用模型自身的未来预测能力在线调度感知计算,实现动态适应性。
实验
实验设计
FORESIGHT 基于冻结的 Qwen3-VL-8B,在三个流式基准上评估:OmniPro Online、StreamingBench 和 OVO-Bench。OmniPro Online 衡量联合 F1(检测与推理的在线一致性),StreamingBench 与 OVO-Bench 考察流式视觉推理和实时感知。对比对象为最强 trained baseline 及 backbone 本身。
关键发现
- 在 OmniPro Online 上达到 23.0 mean joint F1,比最强 trained baseline 高出 9.5 个百分点。
- 在 StreamingBench 上比 backbone 提升 6.7 分,在 OVO-Bench 上提升 15.4 分。
- 当关键证据在视频流后期出现时,增益最大达 18.7 分,体现动态规划对延迟信息的鲁棒性。
与基线对比的深入解读
FORESIGHT 无需任何训练,仅靠双流 Siamese LLM 的并行规划与在线重配置,即超越经过专门训练的 baseline。核心原因在于 baseline 的计算路径固定,无法根据未来事件调整感知密度;而 FORESIGHT 的 anticipatory computation 用短期预测动态决定 when / what / how densely to sample,把瞬时证据与持久控制解耦。工程启示:在流式 VLM 部署中,纯推理期的计算重排可以近乎零成本地提升长视频任务性能,尤其适合监控、无人系统等场景;但该优势依赖可靠的未来预测,避免过多 check 导致的 overhead。
行业影响
落地场景
FORESIGHT 面向实时视频流理解,可落地于智能安防、自动驾驶、工业质检、直播内容审核等需要持续感知且事件动态变化的场景。其双流架构中一个 LLM 持续处理当前输入,另一个前瞻规划未来计算,适合对延迟敏感但计算预算有限的流式推理。
具体 use case:
- 电商直播实时分析:对商品展示、主播话术、观众互动进行动态推理,当系统预测到即将出现关键帧(如商品特写、价格变更)时提前增加采样密度或切换感知模式,提升识别准确率而无需重训模型。
- 自动驾驶路口感知:车辆接近复杂路口时,前瞻流预测可能出现的行人或交通标志变化,动态调整视觉 token 采样策略,把计算集中到高不确定性区域,降低端到端响应延迟。
商业价值
- 降本:训练-free 部署,直接应用于现有 frozen backbone(如 Qwen3-VL-8B),避免重新训练或收集标注数据的高昂成本。动态计算规划减少无关 token 的冗余处理,实测在 OVO-Bench 上较 backbone 提升 15.4,证明少量额外前瞻计算带来显著性能增益,单位推理成本下降。
- 体验提升:后期证据到达时增益突出(+18.7),说明系统能有效处理视频流中延迟出现的关键信息,减少漏检和误判,提升用户对实时服务的信任度。
- 增收:可使现有 VLM 推理服务拓展到更多实时高价值场景,如直播风控、医疗内窥镜辅助等,扩大可服务市场。
与现有产品/工作流的接口
FORESIGHT 可作为推理引擎的调度层集成到现有 stack,无需修改模型权重或训练流程:
- 在 vLLM 或 SGLang 等推理框架上增加前瞻规划模块,利用共享权重和 KV cache 的特性,将第二个前瞻 LLM 作为轻量 sidecar 运行,复用输入编码器和缓存。
- 通过 schema 引导解码 和 diff-based 更新 实现控制计划,可对接现有流处理管道(如 Apache Kafka、Flink),把动态计算配置作为控制消息下发到推理节点。
- 对已有流式 VLM 产品,可先以离线评估模式验证 FORESIGHT 在特定业务数据上的提升,再逐步切换为在线重配置,降低集成风险。
局限
- **预测可靠性依赖**:方法的核心假设是流式 VLM 对未来上下文有足够的预测能力,从而指导计算规划。论文在 `Anticipation Analysis` 一节承认预测“真实但短暂”,控制器必须频繁检查以避免错过关键事件。如果场景动态变化剧烈、预测误差增大,规划模块可能做出错误的重配置决策,导致漏检或错误采样。作者也指出“减少检查次数”仍是一个未解决问题,说明当前方案在长时预测稳定性上存在短板,实际部署时需额外设计预测置信度校验或回退机制。
- **双流架构的资源开销**:虽然两个 LLM 共享权重和 KV cache 以降低显存占用,但第二路 LLM 需要并发运行以提前预测和规划,仍带来不可忽略的计算量。论文在 `Inference Efficiency` 一节对比了基线重读流的方式,但实验主要基于 `Qwen3-VL-8B` 和特定 GPU 环境,对于边缘设备、高分辨率长序列或低延迟要求的实时应用,双流并发可能仍难以满足成本约束,且论文未给出不同硬件条件下的开销曲线或量化的功耗/延迟折衷分析。
- **训练无关策略的域适应性**:方法冻结预训练权重,全程不进行任何微调,这在跨域或专业场景中可能限制性能。例如在需要细粒度专业视觉理解的任务(如医学影像流、工业质检)中,预测模块如果基于通用知识进行未来推测,可能产生偏差,进而影响计算规划。论文在多个通用基准上取得提升,但未针对特定领域做迁移实验,也未讨论如何结合轻量适配或提示工程来缓解这一限制,使其直接应用于垂直领域时存在不确定性。