RIC 时间尺度下的意图解释:Jev 决策模型与大型语言模型在 6G Open RAN 中的对比
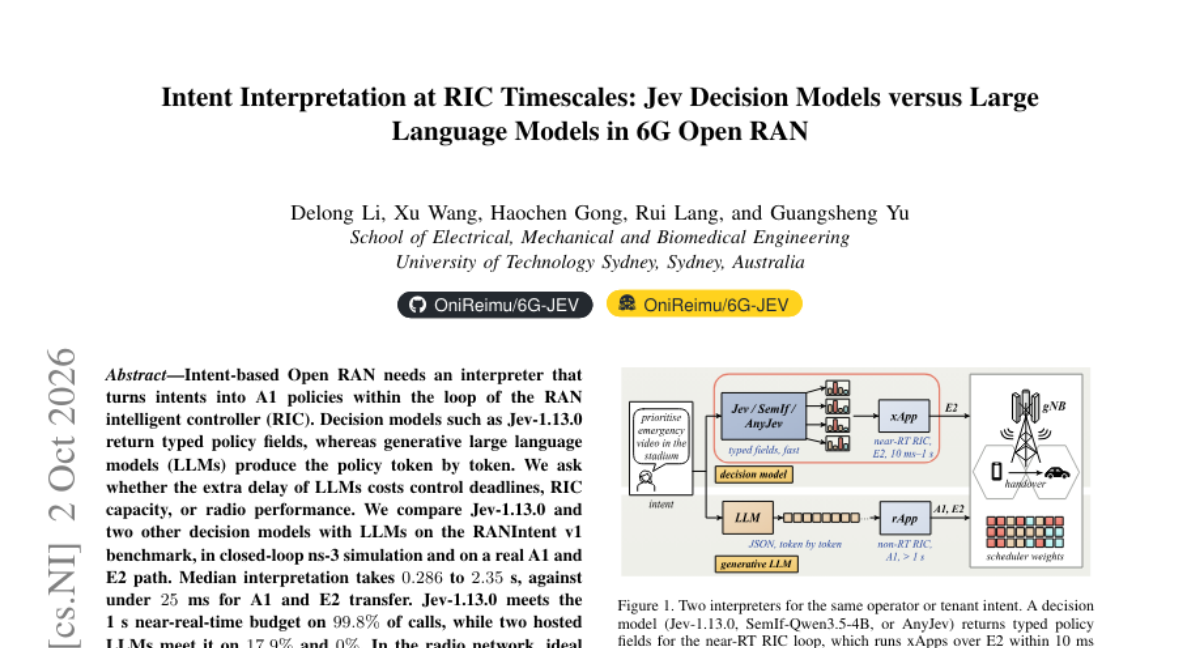
基于意图的 Open RAN 需要一个解释器,在 RAN 智能控制器(RIC)的闭环内把意图转换为 A1 策略。Jev-1.13.0 等决策模型返回带类型的策略字段,而生成式大语言模型(LLM)则逐 token 生成策略。我们追问:LLM 的额外延迟是否会牺牲控制截止时间、RIC 容量或无线性能? 我们在 RANIntent v1 基准上,将 Jev-1.13.0 与另外两个决策模型同 LLM 进行对比,实验涵盖闭环 ns-3 仿真以及真实的 A1 与 E2 路径。 - 中位解释耗时为 0.286 至 2.35 s,而 A1 与 E2 传输低于 25 ms。 - Jev-1.13.0 在 99.8% 的调用中满足 1 s 近实时预算,两个托管 LLM 分别仅为 17.9% 与 0%。 - 在无线网络中,理想执行使受影响类别的 SLA 违例朝每个意图所请求的方向变化 3.96 个百分点,而基点无更新。 - 该点上没有任何托管 LLM 相对 Jev-1.13.0 显示出已解析的提升;同样在该点,每秒直接控制相较数值 xApp 也未带来已解析的 SLA 降低。 结论是:慢速解释器会错过 1 s 预算,且两个解释器在 2 intents/s 时队列饱和;但在基点,慢速解释器的无线性能代价并未被解析出来。
论文精读
TL;DR 在 6G Open RAN 意图解释中,Jev-1.13.0 等决策模型 99.8% 满足 1 秒近实时预算,而托管 LLM 仅 17.9% 和 0%;LLM 的 token 生成延迟会错过控制闭环,决策模型更适合 RIC 时延敏感场景。
问题
问题背景
意图驱动 Open RAN 依赖 RIC 内的解释器把自然语言意图实时转换为 A1 策略,解释速度直接决定控制闭环能否闭合。
现有方法局限
当前存在两类解释器:一类是决策模型(如 Jev-1.13.0),返回类型化策略字段,延迟低且满足近实时预算,但依赖预定义 schema,难以应对开放意图的多样表达;另一类是生成式 LLM,逐 token 产出策略,语言理解更灵活,但自回归解码引入秒级延迟,在 1 s 控制预算下仅有 17.9% 甚至 0% 的调用达标,且并发能力差,2 intents/s 即队列饱和。现有工作多单独评估解释精度或延迟,缺乏在同一 RAN 闭环中同时考虑控制时效、RIC 容量和无线性能的系统对比。
为什么这个问题难/重要
挑战在于 latency-flexibility 的根本矛盾:6G RIC 要求亚秒级策略更新,而意图语言天然非结构化、长尾,LLM 更强的泛化能力与确定性模型的低延迟难以兼得。业界对 Open RAN 智能化寄予厚望,若解释器错过 deadline,意图驱动的收益会被陈旧策略侵蚀,甚至造成控制不稳定。因此必须在统一基准下回答——LLM 的额外延迟是否真的损失控制 deadline、RIC 吞吐或无线 SLA?
行业类比
类似自动驾驶中 LLM 规划器与规则控制器的取舍:LLM 能处理复杂场景但推理延迟高,确定性模型保证实时性却难覆盖开放长尾。
核心洞察
- 核心发现是解释器的时延特性直接决定其能否进入 1 秒近实时 RIC 控制回路;Jev-1.13.0 决策模型以 99.8% 的调用满足预算,而两个托管 LLM 分别仅 17.9% 和 0%。这个角度独特在于把生成式 token-by-token 解码与硬实时控制预算作量化对比,揭示 LLM 在控制面部署的瓶颈不仅是回答质量,更是端到端响应时间,这是多数 LLM 意图解析工作未覆盖的维度。
- 慢解释器虽然错过 1 秒预算并出现队列饱和(2 intents/s),论文在基准点未解析出显著的无线 SLA 惩罚;理想执行可使受影响类 SLA 违规移动 3.96 个百分点。这提示仅用解释延迟评价 LLM 可能不够,需要结合端到端控制回路(解释+传输+执行)才能暴露真实 SLA 影响,与仅报告解析准确率的同类工作形成方法论差异。
方法
输入与基准
- 使用 RANIntent v1 基准,包含意图-策略对。意图描述期望结果,不涉及实现细节。
- 意图通过 O-RAN 控制循环的 A1 接口进入 RIC,解释器部署于 RIC 时间尺度内。
关键模块:解释器对比
- 决策模型:以 Jev-1.13.0 为代表,返回类型化策略字段(typed policy fields),无需序列生成。
- LLM:两个托管大语言模型,逐 token 生成策略,产生额外延迟。
- 解释器输出的策略由 xApp 执行,进而影响无线电资源分配与 SLA。
评估环境与指标
- 闭环 ns-3 模拟:设置基础点(无更新)和理想执行(意图请求方向)作为对照。
- 真实 A1/E2 路径:在真实协议栈上验证端到端延迟。
- 输出 A1 策略,并测量以下指标:
- 解释延迟(中位数 0.286–2.35 s)
- 1 s 近实时预算达标率(Jev 99.8%,LLM 17.9% 和 0%)
- 受影响类别的 SLA 违规变化(理想执行移动 3.96 个百分点)
- 队列饱和阈值(约 2 intents/s)
原文指出:慢速解释器错过 1 s 预算,两个解释器在 2 intents/s 时队列饱和;但在基础点未分解出慢速解释器的无线电惩罚。
与同类方法的差异点:本工作首次在 RIC 时间尺度上系统对比决策模型与生成式 LLM 的意图解释,结合闭环无线电模拟和真实控制路径,量化延迟对控制预算和 SLA 的影响。
实验
实验设计
在 RANIntent v1 基准上,将 Jev-1.13.0 与另外两个决策模型及托管 LLM 对比,通过 ns-3 闭环仿真和真实 A1/E2 通路评估。关注解释延迟、1 s 近实时预算达成率、SLA 违规变化与队列饱和。设置无更新基线、数值 xApp 作为对照。
关键发现
中位解释延迟为 0.286–2.35 s,而 A1/E2 传输低于 25 ms。Jev-1.13.0 在 99.8% 调用中满足 1 s 预算,两个托管 LLM 仅 17.9% 和 0%。理想执行使受影响类 SLA 违规按意图方向变化 3.96 个百分点;该点未发现托管 LLM 比 Jev-1.13.0 有可分辨的提升。每秒直接控制相对数值 xApp 亦无可分辨的 SLA 降低。慢解释器错过 1 s 预算,两个解释器在 2 intents/s 时队列饱和;基线点未分辨出无线性能惩罚。
与基线对比
LLM 逐 token 生成导致高延迟,无法满足 RIC 近实时控制循环;Jev-1.13.0 返回类型化策略字段,延迟稳定且符合预算。尽管基线点未体现显著无线性能差异,但控制容量与 SLA 方向性优势关键。负载场景下慢解释器的队列饱和制约可扩展性,构成实时编排瓶颈。工程上应优先采用决策模型处理高频意图,LLM 可留作离线或低频解析。
行业影响
落地场景
本工作在 意图驱动网络与 Open RAN 的交叉点。核心产品形态是 RIC 内的意图解释器微服务:接收自然语言或结构化意图,输出 A1 策略。典型业务包括:
- 电信运营商网络自动化平台:将业务意图(如“保证视频流优先级”“降低某切片时延”)实时转换为 RAN 配置,减少人工工单。
- 企业私有 5G / 专网管理:工业场景中,产线管理员用自然语言描述“AGV 车辆需要 99.9% 可靠性”,系统自动调整 QoS 参数。
- 云网融合产品:云服务商提供“网络即代码”能力,用户以声明式意图配置跨域网络策略。
商业价值
论文量化了 决策模型 vs. LLM 的延迟与可靠性差异,给出明确的工程选择依据:
- 降本:Jev 类模型在 99.8% 调用满足 1s 预算,而托管 LLM 只有 17.9% 和 0%。在生产中选用决策模型可避免超时重试、队列积压和人工兜底,降低运维成本。
- 增收:对 SLA 敏感的切片服务,理想的意图执行可使受影响类 SLA 违规移动 3.96 个百分点,为运营商创造差异化定价空间。
- 体验提升:端到端闭环仿真显示,过快或过慢的解释器均未带来显著无线性能提升;关键在于与 RIC 控制回路匹配的确定性延迟,而非盲目追求大模型生成能力。
与现有产品/工作流的集成
该解释器可作为 A1 接口的策略生成插件,嵌入现有 O-RAN 架构:
- 作为 xApp / rApp 的服务端:RAN 自动化平台(如 ONAP、OSC 的 Near-RT RIC)通过 REST/gRPC 调用解释器,输入意图,输出类型化策略字段。
- 替代基于规则/模板的系统:Jev 决策模型可编译为轻量级容器,部署在 K8s 边缘节点,与 Prometheus 遥测、CI/CD 流水线配合,实现版本化策略发布。
- 与 LLM 网关共存:在离线规划或非实时场景中可采用 LLM 生成候选策略,再通过 Jev 进行类型校验和快速转换,形成 “慢思考 + 快执行” 的混合流水线。
落地 use case:
- 电商大促保障:某电商平台在秒杀期间通过意图接口提出“支付 API 优先级最高,API 网关到数据库链路时延 < 20 ms”,网络自动化平台在 1 秒内将意图转换为 A1 策略并下发至 RAN,动态调整切片 QoS,避免支付超时。该场景要求解释器延迟极低且确定性高,Jev 类模型比自回归 LLM 更可靠。
- 自动驾驶车队远程接管:车队运营方对 5G 专网提出意图“远程驾驶视频流上行带宽 ≥ 50 Mbps,端到端时延 ≤ 30 ms”,解释器实时生成 E2 控制策略,确保车辆在边缘切换时的连续性。若解释器饱和或超时,则直接危及安全;论文中 2 intents/s 即出现队列饱和 的结论提醒集成方需引入限流和优先级队列。
局限
- 论文主要聚焦解释延迟与 RIC 控制环路的影响,对 LLM 生成策略的**语义准确率**分析不足。虽然 SLA 违规移动间接反映了策略质量,但没有直接报告各解释器在 RANIntent v1 上的**字段级准确率**或 F1 等指标,因此难以区分无线性能下降究竟源于延迟还是错误策略。这限制了将结论推广到准确率优先场景的能力。
- 评估场景与数据集代表性有限。RANIntent v1 和 ns-3 仿真拓扑相对简化,仅覆盖有限意图类型和固定网络条件,未包含**多意图并发、动态用户移动或大规模节点**等真实网络复杂性。LLM 服务延迟也受到托管平台负载波动的显著影响,实验未考虑这一外部变量,结论可能低估或高估 LLM 在实际部署中的延迟表现。
- 部分关键指标统计功效不足。例如摘要指出 `no radio penalty of slow interpreters was resolved`,表明在现有实验时长和方差下,无法检测到慢解释器对无线性能的显著负面影响。这意味着慢解释器无害的结论可能只是由于仿真规模不足或测量噪声掩盖了真实效应,需要更长实验或更多随机种子才能得出可靠结论。