COSMI: 多物体交互的组合式合成
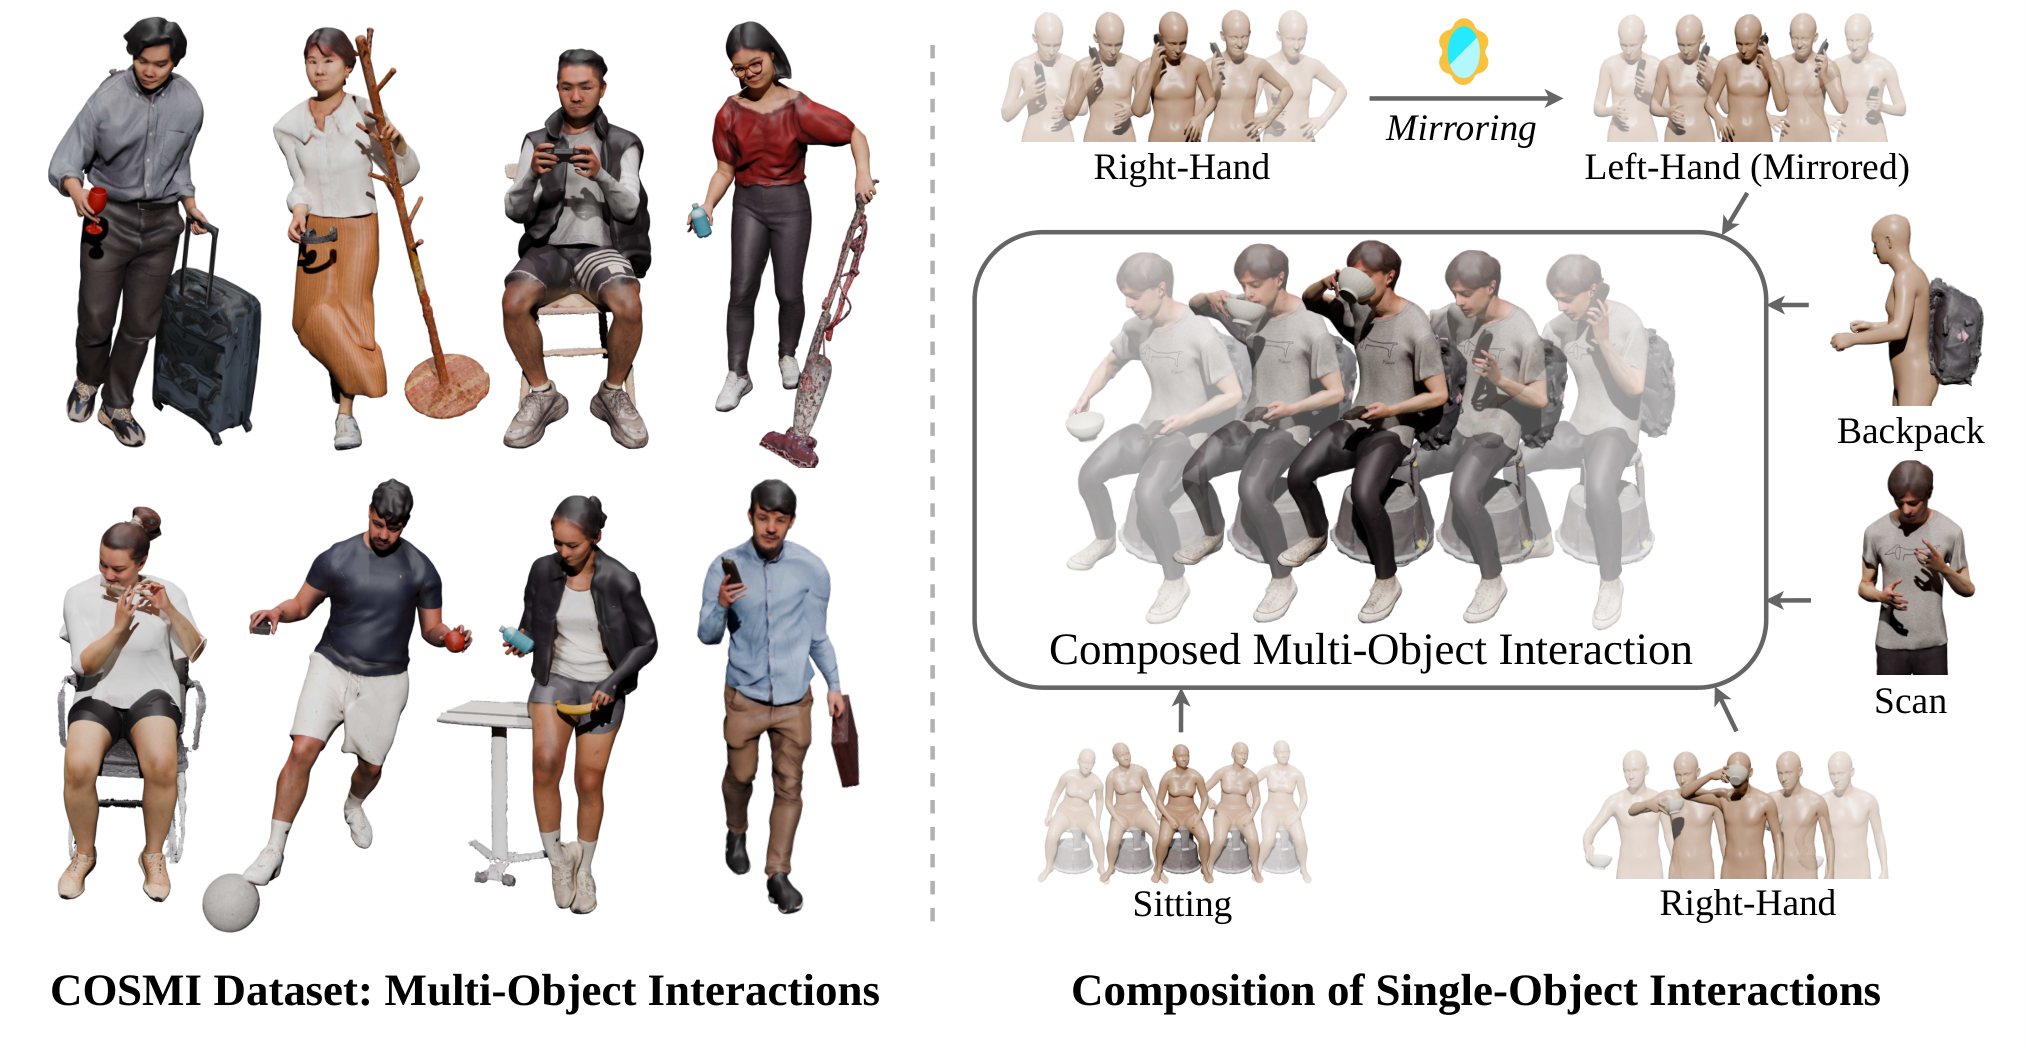
人-物交互的生成模型受限于现实世界已有的数据:日常活动往往同时涉及多个物体,但多数采集数据集一次只记录一个物体,因为多物体采集的组合开销极其昂贵。 我们的观察是:交互具有局部性,因此单物体采集其实已经包含了多物体活动的组成部分。于是我们把它们组合起来——对单次交互生成接触一致 的片段,通过镜像平衡左右手,并在不同身体之间迁移;再用语言模型 与几何检查,只接纳在语义与物理上都合理的配对。由此,数据集随片段数量而非录制时长呈组合式增长。 COSMI 数据集包含 222k 条序列、275 小时,最多涉及五个物体,规模接近最大多物体采集的三十倍,并且可以通过添加数据集甚至手-物录制来扩展。在此数据上我们训练了 COSMI 方法,一个 text-to-interaction 扩散 transformer,其设计遵循数据的构建方式:权重共享的物体槽位生成可变数量的物体,并相对于驱动它们运动的身体部位进行预测。 在包含未见物体与未见交互组合的基准上,用该数据集训练的模型能够泛化到未见组合。COSMI 在文本对齐与接触准确率上均优于基线,且其优势在未见物体上最大。代码、模型与数据集流水线将在项目页发布:https://ptrvilya.github.io/cosmi。
论文精读
TL;DR COSMI 组合单物体交互片段构建 222k 序列/275 小时的多物体交互数据集,训练可变物体插槽的扩散 Transformer,在未见物体与组合上文本对齐和接触精度优于基线。
问题
问题背景
人类与多物体的日常交互生成(如同时使用杯子和水壶、双手各持工具)是数字人、具身智能与 AR/VR 的关键能力。当前研究主要依赖运动捕捉数据集,但多物体同时捕获的标注成本随物体数量呈组合爆炸增长,导致现有数据几乎只覆盖单物体交互。
现有方法局限
现有生成模型受限于数据:像 BEHAVE、GRAB 等主流数据集只记录单一物体交互,模型难以推广到两个及以上物体的协同操作。直接扩展多物体动捕在采集、标注和同步上成本极高,导致可用的多物体交互数据极少,且物体组合固定、缺乏泛化性。另一类方法尝试利用图网络或自回归模型建模多物体关系,但通常需要显式的物体间约束或大量配对数据,难以应对新颖组合。
为什么这个问题难/重要
核心技术挑战在于交互的局部性与组合性:人类在使用多个物体时,各物体主要由对应身体部位独立操控,但整体动作仍需满足语义合理性和物理接触一致性。如果能在数据层面对单物体片段进行组合扩增,数据集规模可以随片段数量指数增长,从而突破采集瓶颈。业界关注点在于:一旦可行的组合式数据生成 pipeline 成立,将直接降低多物体交互合成、机器人操作模仿学习、虚拟人等应用的训练数据门槛。
行业类比
这类似于用程序化生成与组合式数据扩增解决机器人操作中多工具协同任务稀缺的问题,用局部交互单元拼装出多样化的全局行为。
核心洞察
- 通过组合单物体交互片段构建多物体交互数据集,利用局部性假设避免了组合爆炸式的采集成本,并借助大型语言模型与几何校验筛除不合理的配对。这一思路与现有直接多物体采集或简单拼接不同,它使数据规模随片段数组合增长而非线性增长,极大提升了数据多样性与可扩展性,为稀缺的多物体交互数据提供了高效获取路径。
- 方法采用权重共享的 object slots 与 part assignment 机制,模拟数据构建中的组合方式,使模型能够生成可变数量的物体并预测其相对于身体部位的位置。这种设计相比固定 slot 或联合回归的基线,显著提升了对未见物体组合及未见物体的泛化能力,尤其在接触精度上优势明显,为文本到交互合成提供了更灵活、可扩展的架构。
方法
输入与表示
COSMI 的输入为一段自由文本(如“左手拿杯喝水,右手搅拌咖啡”)及初始人体姿态。人体采用参数化模型(如 SMPL-X)表达,物体则通过几何编码器提取点云或网格特征,映射到共享 latent 空间。
关键模块:diffusion transformer + weight-shared object slots
去噪网络为 transformer 架构的 diffusion 模型,核心是 weight-shared object slots:所有物体共享同一组可学习 slot 参数,因此网络可处理可变数量(1~5 个)物体,不预设固定物体数。每个 slot 输出一个物体的位姿与形状 latent,part-assignment head 负责将该物体分配给对应的身体部位(如左手、右手、躯干)。物体位姿被预测为相对于该部位局部坐标系 的偏移,而非全局坐标,这增强了跨身体、跨场景的泛化能力。
接触一致性引导与训练
训练损失包括去噪重建损失、物体-身体接触损失(基于标注接触区域)以及物体几何重建损失。推理时引入 contact-consistent guidance,类似 classifier guidance,在每一步采样中施加接触约束的梯度,保证生成序列的手-物、物-物接触物理合理,避免穿透与悬空。
与同类工作的差异
不同于固定物体数量或全局坐标预测的方法,COSMI 将组合泛化能力内建于架构:weight-shared slots + part-relative 预测,使其在 unseen object 和 unseen interaction 组合上显著优于 baseline。
实验
实验设计
- 泛化基准:构建包含未见对象与未见交互组合的测试集,评估模型从单对象到多对象的组合泛化能力。
- 对比基线:与相关方法在文本对齐和接触精度指标上比较,并在 HIMO 数据集上做跨数据验证。
- 消融研究:分析镜像、语言模型+几何检查、对象槽等组件的贡献。
关键发现
- COSMI 在文本对齐和接触精度上均优于基线,且在未见对象上优势最大,表明组合策略有效解决长尾交互。
- 数据集通过组合单对象片段扩展到 222k 序列 / 275 小时,规模约为最大多对象捕捉数据集的 30 倍,且可继续扩展。
- 方法采用权重共享对象槽生成可变数量对象,预测相对于身体部位,与数据构建逻辑一致。
与基线对比解读
- 基线的接触精度差距在未见对象上尤其明显,说明 COSMI 的局部交互组合 + 语义/物理检查能更好处理组合新颖性。
- 在 HIMO 数据集上的比较验证了方法对不同数据分布的鲁棒性。
- 消融实验显示各组件协同作用,移除任一环节均导致性能下降,证实了设计必要性。
行业影响
落地场景
COSMI 生成的是文本驱动的多物体交互动画,可直接用于虚拟人 / 数字人产品中的手部与物体操作合成。典型场景包括:
- 电商虚拟试穿与商品演示:输入“拿起水杯喝水,同时用另一只手滑动平板”,生成模特全身动画与物体轨迹,替代传统动捕或手工 K 帧。
- 游戏与影视预演:快速生成角色与多个道具的交互片断,用于分镜验证或 NPC 行为填充。
- 机器人学习数据增强:借助 contact-consistent 条件生成大量 human-object interaction 轨迹,扩充操作数据集。
商业价值
核心价值在降本 与 增效:
- 减少动捕设备与演员时间,单次录制即可组合出数千条多物体序列(数据集 222k 序列、275 小时)。
- 文本驱动提升内容生产吞吐,尤其适合需要大规模个性化交互内容的平台。
- 模型支持 unseen object 与 unseen interaction 组合,降低了为新 SKU 或新任务重新采集数据的成本。
与现有产品 / 工作流的接口
COSMI 输出可兼容标准动画管线:
- 导出 SMPL-X 人体参数 与物体相对轨迹,经
FBX/GLTF导入 Unity / Unreal / Blender。 - 作为推理服务集成到现有生成式内容 pipeline,前端接收自然语言指令,调用后端 diffusion transformer 生成动画,类似当前 text-to-motion API 的升级版。
- 可与 LLM 组合:LLM 解析复杂指令并分解为多物体交互步骤,COSMI 负责生成对应动作序列。
实际用例:某内容平台为虚拟主播自动生成“泡咖啡”流程,无需逐帧制作;某电商品牌为新品水杯生成模特互动短视频,减少外包动画费用。
局限
- - **数据合成层面**,虽然语言模型与几何检查能过滤大部分不合理配对,但组合生成的序列仍可能存在语义或物理上的不自然,例如物体间的时序同步与双手协调等全局约束可能被局部合成所忽略。此外,合成数据质量高度依赖单物体交互数据的质量,若原始数据存在噪声或动作偏差,组合后会放大这些缺陷。当前组合规则相对简单,难以生成需要多个物体紧密配合的复杂任务(如拧螺丝、切菜等)。
- - **方法层面**,weight-shared object slots 限制了同时处理的物体数量上限(论文中最多五个),且每个物体必须与某身体部件关联,对于更复杂的多物体交互(如两手各持一物同时操作、物体间直接交互)可能不适用。接触一致引导在推理时会增加计算开销,引导强度需额外调参,且可能影响生成多样性。模型未显式建模物体间关系,因此碰撞避免或物体配合可能不足。
- - **评估层面**,未见对象与未见组合的泛化实验仅在合成基准上进行,缺乏真实多物体捕获数据的直接验证,因此模型在真实场景中的性能仍不确定。与真实多物体数据集(如 HIMO)对比时,因数据分布差异,指标提升可能无法完全反映实际交互质量。此外,文本对齐与接触准确性等指标依赖外部评估器,其鲁棒性有待商榷。