通过组合偏好奖励与评分标准奖励对前沿文本到图像模型进行后训练
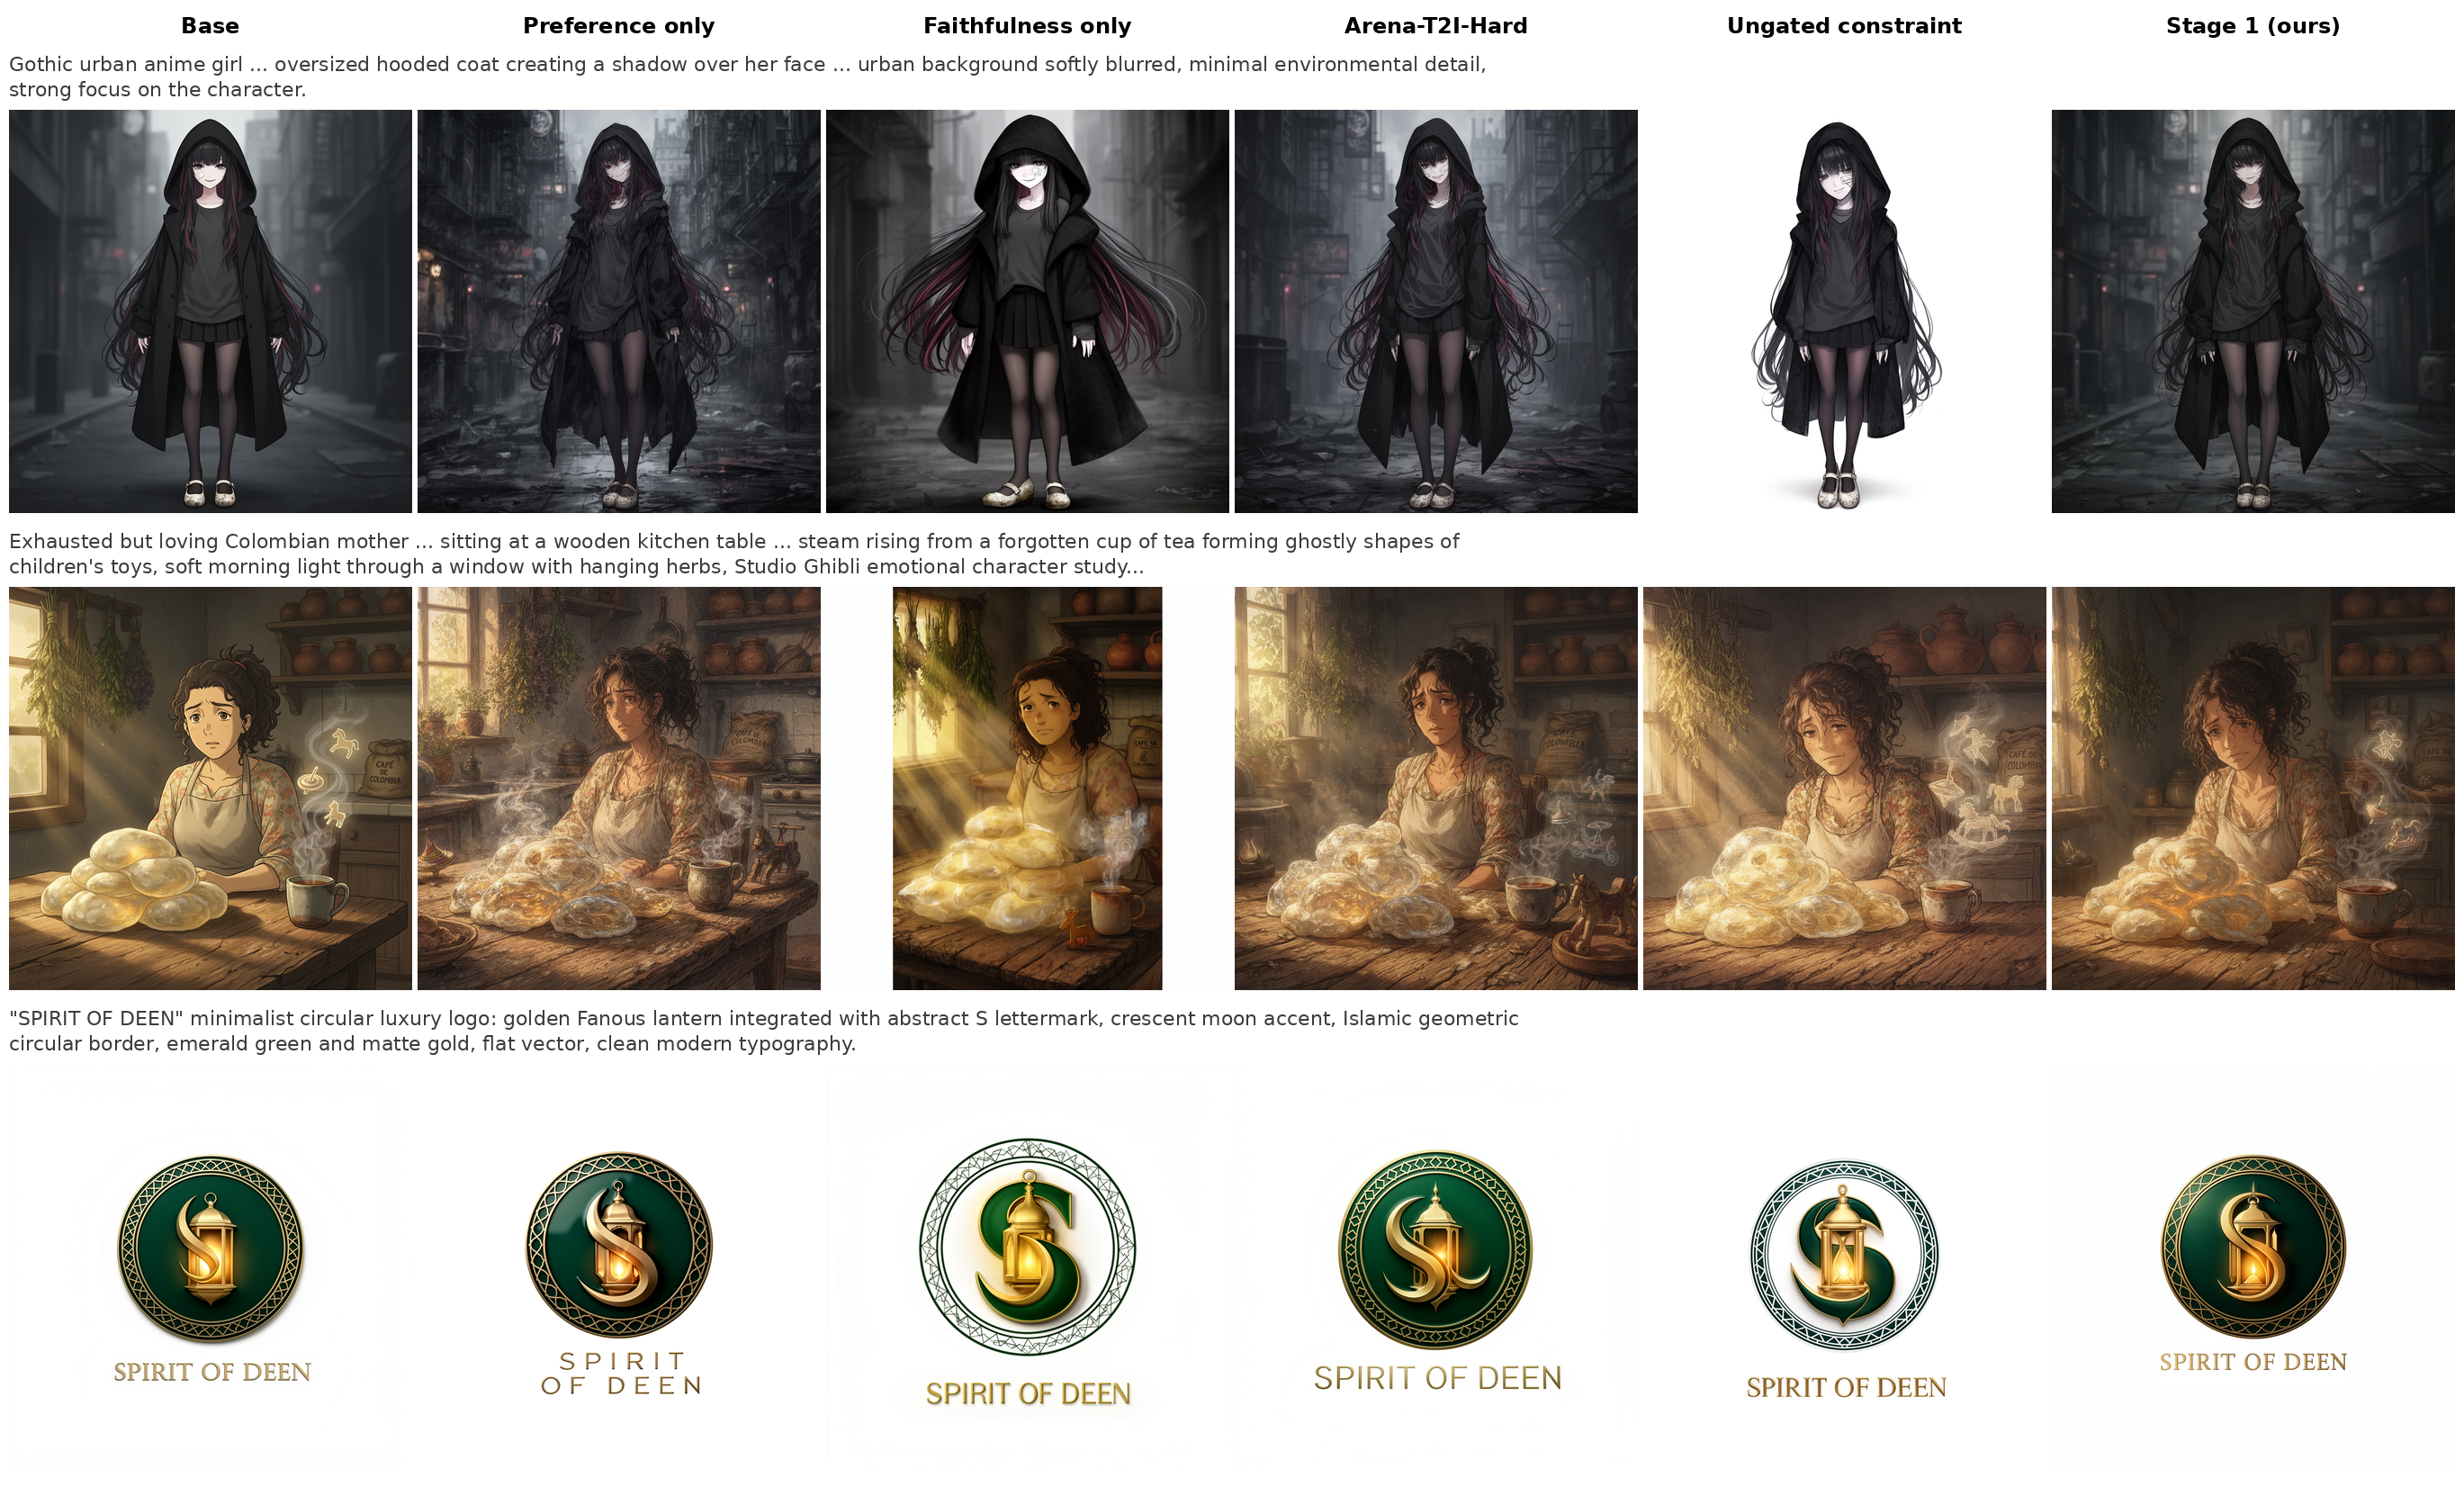
背景与问题:近期文本到图像生成模型已取得出色的视觉质量,但通过后训练继续提升仍然困难,因为没有任何单一奖励信号能够覆盖人类偏好的全部维度。 方法:本文提出一套简单有效的开放域文本到图像后训练方案,核心是组合互补的奖励信号。奖励系统包含两部分:一是偏好奖励(preference reward),基于大规模人类偏好数据、以 Bradley-Terry 目标训练,用于捕捉整体的人类审美与感知偏好;二是基于 rubric 的奖励,显式评估 prompt 忠实度及其他理想属性,同时对 reward hacking 提供防护。关键难点在于如何组合这些异构奖励信号——作者表明朴素的加权平均会导致次优的优化行为,并提出一种简单的奖励组合策略,更有效地平衡偏好优化与 rubric 满足度。 实验与结论:在 Arena 文本到图像排行榜上,经 RL 训练的 Flux2dev 的 Elo 比基座模型高 69 分,后训练的 Ideogram-4 超越榜单上所有开源模型,Elo 达 1223.5(SOTA 声明基于 2026 年 9 月 4 日的 Arena 排行榜快照)。结果表明,前沿生成模型训练所需的有效奖励,必须广泛覆盖用户意图,并在优化过程中对奖励利用保持鲁棒。为支持可复现研究,作者发布 Arena-T2I-Training——一个 1K 规模的训练数据子集,可复现全量训练的部分收益。
论文精读
TL;DR 该工作提出组合偏好奖励与 rubric 约束奖励的 RL 后训练方案,解决单一信号难覆盖人类意图的问题,在 Arena T2I 榜上 Flux2dev 提升 69 Elo、Ideogram-4 达 1223.5 超越开源模型。
问题
问题背景
当前 文本到图像生成 已能产出高质量视觉内容,但通过后训练进一步对齐用户意图与审美偏好仍是核心挑战。单一奖励信号无法覆盖人类偏好全貌,而多个异质奖励信号的有效整合尚未解决。
现有方法局限
传统后训练多采用单一 偏好奖励 或简单加权合并多个奖励项,但存在明显局限:
- 单一偏好奖励仅捕捉整体审美,忽略 提示忠实度、文本渲染正确性等细节,且易被模型通过 hack 手段欺骗。
- 直接加权平均多个奖励会因量纲、尺度差异导致优化偏离,例如偏好奖励梯度主导而忽略 rubric 约束。
- 缺乏针对奖励攻击的主动防御,模型可能在某项奖励上过拟合,损害其他关键属性。
为什么这个问题难/重要
难点在于:不同类型奖励信号具有 异质性 和 动态冲突——偏好奖励追求整体观感,rubric 奖励强调可验证的约束,二者可能相互制约;同时,奖励模型本身存在 可被利用的漏洞(reward hacking),高容量生成模型在强化学习优化下极易找到这些漏洞。业界关注度高,因为后训练决定模型能否从“能生成”跃迁到“可靠、可控、符合意图”,如 Arena 排行榜显示 RL 训练可带来显著 Elo 提升。
行业类比
这类似于 大语言模型 RLHF 中仅用单一安全奖励易被绕过,需要将安全规则、事实性等多目标与人类偏好共同优化,并通过 约束强化学习 或 reward ensemble 构建稳健的对齐系统。
核心洞察
- 该工作提出通过组合偏好奖励与基于规则的 rubric 奖励来指导文本到图像模型的后训练,并采用分组奖励解耦归一化与门控机制平衡两者。与以往仅依赖单一人类偏好模型或简单加权平均不同,该方法识别出异构奖励直接加权会导致优化偏差,因此引入分组归一化和门控来动态调节各奖励的影响,使得模型在提升整体美感的同时保持提示忠实度和约束满足,这是奖励集成策略上的一个实用创新。
- 将防奖励黑客机制直接构建为 rubric 奖励的一部分,并在优化中实施否决式干预,是防止模型利用奖励漏洞的有效方法。传统 RLHF 通常依赖正则化或事后审计来缓解奖励黑客,而本文设计专门的 anti-reward-hack rewards(点对点和基于参考的)以及 veto-based prevention,在训练过程中主动检测并抑制过度优化行为,这使得奖励信号在优化压力下保持稳健,对前沿生成模型的训练具有工程借鉴意义。
方法
输入与流程
面向开放域 text-to-image 生成,输入为 prompt,以预训练模型(如 Flux2dev、Ideogram-4 )为初始化,采用在线 diffusion RL 在去噪轨迹上优化生成策略。
关键模块
- 人类偏好奖励:在大规模人类偏好数据上用 Bradley-Terry 目标训练偏好奖励模型,捕获整体审美与感知偏好。
- Rubric 奖励:包含三类——
faithfulness reward显式评估 prompt 遵循度;constraint reward对可检查的约束(如文本渲染、布局)打分;anti-reward-hack reward分 pointwise 与 reference-based 两种,检测并惩罚偏离提示意图或异常模式。 - 奖励集成:不采用简单加权平均,而是先做 group reward-decoupled normalization ,将异构奖励按组解耦归一化;再通过 gating mechanism 根据 prompt 意图标签选择性启用约束奖励;veto-based 机制在严重违规时一票否决,避免奖励黑客。最终在 RL objective 中组合,并支持 weight ensembling 合并不同训练 run 的权重。
输出
得到 post-trained 模型,在 Arena T2I leaderboard 上 Elo 显著提升。
差异点:与依赖单一偏好奖励或 naive weighted sum 的常见方案不同,本方法通过分组归一化、意图门控与否决机制组合互补奖励,兼顾偏好优化与 rubric 满足,更强地抑制 reward hacking。
实验
实验设计
- 验证场景:在 Arena text-to-image leaderboard 上评估 post-training 效果,使用 Flux2dev 与 Ideogram-4 两个 base model。
- 训练方案:采用 online diffusion RL,组合 human preference reward(Bradley-Terry model 训练)与 rubric-based rewards(prompt faithfulness / constraint / anti-reward-hack),提出 group reward-decoupled normalization + gating + veto 的 reward 组合策略。
- 对比基线:naive weighted average 组合为次优;模型还包括开源模型与自身 base model。
- 资源发布:open-source Arena-T2I-Training(1K subset)。
关键发现
- Flux2dev 经 RL 训练后 Elo 提高 69 点,达到显著提升。
- Ideogram-4 达到 Elo 1223.5,超越所有 open-source 模型。
- 提出的 reward composition 策略有效平衡 preference 优化与 rubric 满足度,优于 naive weighted average。
- 1K subset 能恢复部分 full-scale training 的收益。
对比解读
- 单纯优化单一 preference reward 会损害 faithfulness(论文限制部分提到),组合 rubric rewards 提供 safeguard。
- gating / veto 等机制防止 reward hacking,说明 reward 设计需兼顾覆盖度与鲁棒性。
- 与其他 open-source post-training 方法相比,该工作强调 reward 组合而非单一信号,为多目标 RL 提供实践路径。
行业影响
落地场景:该后训练配方可直接用于电商产品图生成、社交媒体内容创作、广告素材生产等对视觉质量和 prompt 一致性要求高的业务。例如,Flux2dev 或 Ideogram-4 经过 RL 微调后,能更可靠地渲染指定物品、文字和布局,适合自动生成商品详情页多角度图或营销海报。
商业价值:通过组合偏好与 rubric 奖励,模型在保持美学吸引力的同时显著提升指令跟随,减少人工筛选、修图和返工成本。Arena 榜单 Elo 提升 69 分意味着更低的拒识率和更高的用户满意度,可驱动订阅转化与留存。对按生成量计费的 API 服务,高通过率直接降低单张有效图片的算力浪费。
接口集成:该方案无需改动基座模型架构,可作为 post-training 阶段的 reward ensembling 模块嵌入现有 diffusion/flow 训练流水线。Arena-T2I-Training 提供的 1K 子集可用于快速验证和奖励模型调参,企业可将 rubric 中的约束项替换为业务规则(如品牌合规、安全过滤),实现低成本定制。同时,veto 机制可防止奖励黑客,适合长期在线 RL 或定期模型刷新。
局限
- **数据与复现局限**:论文仅公开 1K 子集 **Arena-T2I-Training**,虽能恢复部分提升但无法完全复现全量训练的完整效果;**Arena leaderboard** 快照随时间变化,SOTA 声明具有时效性。这限制了社区对其方法进行严格的验证和扩展。
- **方法复杂度与依赖**:奖励系统由多个组件构成(preference reward 加多个 rubric rewards),且组合策略涉及 **group normalization**、**gating**、**veto** 等机制,超参数较多,训练和调参成本高。Rubric reward 模型自身的准确性和泛化性可能成为瓶颈,若这些 judge 模型存在偏差或误判,会直接影响 RL 优化方向。
- **泛化性与评估偏差**:实验仅在 **Flux2dev** 和 **Ideogram-4** 两个 base model 上验证,未证明该方法可推广到其他扩散或流模型架构。Arena 用户偏好可能偏向特定审美风格,导致评估有偏。此外,veto-based anti-reward-hack 机制可能过度限制探索,抑制模型在创意和多样性上的表现。