FastOPD: 面向轻量级 VLA 部署的在线策略蒸馏
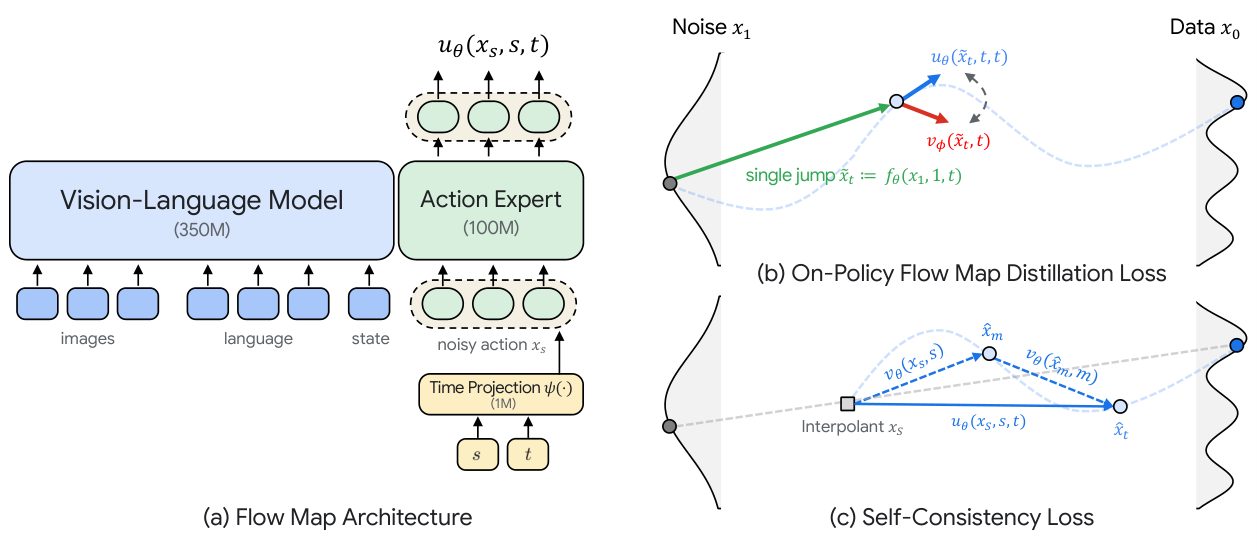
Vision-Language-Action (VLA) 基础模型的规模迅速增长,显著提升了操作性能与泛化能力,但随之而来的高计算开销让真实场景部署愈发困难。现有工作通常通过设计更小的架构,或减少 flow-based policy 中的迭代去噪步数来缓解该问题。 本文提出 FastOPD,一个 foundation-to-lightweight 的 VLA 框架,通过高效的 on-policy distillation 让大规模 VLA 具备实际部署能力。具体而言,FastOPD 为单状态教师监督适配 flow map,并结合 self-consistency 目标,构建出学习教师动力学的紧凑学生模型。理论上,作者证明最小化该目标可使学生模型恢复到与理想少步教师模型相当的分布。 实验覆盖多种基础策略的仿真与真实场景: - 在 LIBERO 上,FastOPD 仅用两步推理即保留 π{0.5} 的 84% 性能,推理延迟降低 78.1%,平均成功率优于现有 few-step 蒸馏基线; - 以 LingBot-VLA 为教师,在 RoboTwin 2.0 上把单步成功率相比基础学生模型提升 15.9 个百分点。 此外,FastOPD 同样适用于 World Action Model (WAM),并已将基于 MolmoAct2 蒸馏得到的紧凑学生模型部署到真实机器人上。
论文精读
TL;DR FastOPD 通过 on-policy 蒸馏将大 VLA 压缩为轻量模型,仅 2 步推理保留 π0.5 84% 成功率并降 78% 延迟,超越现有少步蒸馏方法。
问题
问题背景
机器人学习领域正从单任务策略转向大规模 VLA 基础模型(如 π0.5、LingBot-VLA、MolmoAct2),以提升操作性能与跨任务泛化。然而,模型规模扩大带来推理延迟与算力开销剧增,难以满足真实机器人部署的实时性约束。
现有方法局限
- 一类方法直接设计更小的模型架构,但通常无法继承大模型学到的丰富视觉-语言-动作表征,导致任务成功率显著下降。
- 另一类方法通过减少 flow-based policy 的迭代去噪步骤(如单步或两步生成),但简单减少步数会造成多步 teacher 分布与 few-step student 分布之间的严重 mismatch。现有 few-step distillation(如 DMD、CTM、iMeanFlow)多数依赖离线数据集或需要多步 teacher rollout,容易引入 off-policy 偏差,在真实机器人场景中鲁棒性不足。
为什么这个问题难/重要
VLA 的推理通常要经过数十步 flow matching 去噪,每步都通过庞大的 transformer 网络,使得控制频率可能低于 1-2 Hz,而机器人操作通常要求至少 10 Hz 以上的闭环响应。如何在极少推理步数下恢复 teacher 策略的动作分布,同时保证 on-policy 数据分布下的稳定性,是兼具理论与工程挑战的问题。该问题直接决定大模型能否从云端 demo 走向边缘实时控制,是当前具身智能产品化的核心瓶颈之一。
行业类比
类似大语言模型领域从稠密模型到小模型的推理加速,VLA 的轻量化部署也面临“压缩即掉点”与“加速即失真”的权衡,需要类似知识蒸馏与投机解码的联合优化思路,但又必须额外保证物理动作分布的准确性。
核心洞察
- FastOPD 将流匹配蒸馏从多步教师轨迹匹配简化为单状态 flow map 监督,有效解决 on-policy 训练中的分布失配问题。传统 few-step 蒸馏方法(如 DMD、CTM)要求学生复现教师模型的完整去噪链路,但学生自身的采样分布与教师不一致,导致误差累积并限制步数压缩。FastOPD 只利用单个状态点的 flow map 作为监督信号,让学生直接学习教师在该状态下的速度场,无需遍历教师的多步推理过程。这一设计显著降低了对教师轨迹的依赖,使得学生可以在 on-policy 采样下稳定收敛,并在仅 2 步推理时保留 84% 的教师性能。
- FastOPD 引入自一致性目标,从理论上保证少步学生能恢复与理想少步教师模型相当的分布,避免步数减少导致的性能坍缩。自一致性要求学生从任意状态出发,经少步推理得到的动作分布与单步最优预测保持一致,从而约束学生动力学在时间方向上稳定。与仅匹配教师输出分布的蒸馏方法相比,这一约束直接作用于学生自身的生成过程,有效抑制累计误差,使得 FastOPD 在极低推理步数下仍能保持高成功率,并在多个 baseline 对比中取得平均成功率领先。
方法
FastOPD 面向 flow-based VLA 的少步部署,核心是把高步数教师策略蒸馏为轻量学生。输入为多模态观测(视觉、语言指令、机器人状态)以及当前动作噪声。
单状态 Flow Map 监督:传统 flow matching 策略需要多步积分去噪,FastOPD 先将教师模型的连续 flow 轨迹压缩为一个从噪声动作到目标动作分布的 flow map。对任意单个状态,该 map 直接给出一步去噪结果,学生网络以此为监督,避免逐步模拟教师轨迹。
On-Policy 自一致性目标:FastOPD 不依赖离线静态数据集,而是在学生自身 rollout 的状态分布上采样。学生每次推理生成的 action 会进入环境得到下一状态,再查询教师 flow map 获得单步标签;同时加入自一致性正则,约束学生在自身采样分布上的预测与教师 flow map 一致,从而减小 teacher-student 分布偏移。
训练完成后,学生模型只需 1-2 步推理即可输出动作,显著降低延迟;在 LIBERO 上保留 π0.5 的 84% 成功率,推理步数从默认多步降至 2 步。
与 DMD、CTM 等 few-step 蒸馏方法不同,FastOPD 把 on-policy 采样与单状态 flow map 监督耦合,专门适配 VLA 的动作流形。
实验
实验设计叙述
FastOPD 在多个仿真与真实机器人基准上验证,包括 LIBERO、RoboTwin 2.0 和真实机器人任务。教师模型覆盖 π0.5、LingBot-VLA、MolmoAct2 及 World Action Model (WAM)。对比基线包括 DMD、CTM 和 improved MeanFlow 等少步蒸馏方法。评估指标为任务成功率、推理步数与延迟。
关键发现
在 LIBERO 上,FastOPD 仅用 2 步推理保留 π0.5 的 84% 性能,推理延迟降低 78.1%,平均成功率超过现有少步蒸馏基线。以 LingBot-VLA 为教师时,在 RoboTwin 2.0 上单步成功率比基础学生模型提升 15.9 个百分点。FastOPD 还从 MolmoAct2 蒸馏出紧凑学生并成功部署到真实机器人,展示了跨策略与物理环境的泛化能力。
基线对比解读
与 DMD、CTM 等基于分布匹配或轨迹一致性的方法不同,FastOPD 通过 on-policy 蒸馏 与单状态教师监督,直接学习教师策略动力学,因此在极少推理步数下仍能保持较高成功率。78.1% 延迟降低与 84% 性能保留表明其延迟-性能权衡优于现有方法。真实机器人部署进一步验证了该方法对异构策略的可行性。
行业影响
落地场景
FastOPD 面向 VLA 基础模型 的轻量化部署,适用于实时性要求高的机器人操控任务。典型场景包括:
- 仓储物流机器人:在拣选、分拣、上下料等环节,将大参数 VLA 蒸馏为两阶段推理模型,延迟降低 78.1%,保留 84% 成功率。
- 服务机器人 / 具身智能产品:在家庭、办公等边缘设备上运行轻量策略,避免云端往返延迟。
- 自动驾驶 / 高级辅助:端到端操控模型通过蒸馏压缩至车载芯片可实时运行,提升响应速度。
商业价值
核心收益来自 成本与体验两条线:
- 降本:轻量学生模型大幅降低 GPU/TPU 算力需求,使原本需要高端服务器的大模型可部署到低成本嵌入式设备,减少云推理费用与硬件采购成本。
- 体验提升:推理延迟从数百毫秒降至几十毫秒,机器人动作更连贯,操控更实时;同时能耗降低,适合电池供电设备。
- 规模化复制:一套教师模型可蒸馏出多个场景专用学生,按需部署,提高模型资产利用率。
与现有工作流的接口
FastOPD 输出的是可直接替换教师模型的学生网络,无需改动原有推理框架:
- 兼容 流匹配 / 扩散策略 主流训练栈(如 PyTorch、HuggingFace LeRobot),学生模型保持相同接口。
- 可进一步结合 TensorRT / ONNX Runtime / TVM 等推理优化工具,获得硬件级加速。
- 蒸馏过程可嵌入现有 MLOps 流水线,作为模型上线前的压缩步骤,实现自动化。
具体落地用例
- 电商仓储分拣机器人:用 π0.5 作为教师,蒸馏出两阶段学生模型,部署在边缘计算盒上,实时抓取 SKU 物品。每个仓库可节省数十块高端 GPU,同时提升分拣节拍。
- 自动驾驶端侧操控:将云端训练的 WAM 蒸馏到车载 SoC(如 NVIDIA Orin),在 30ms 内输出控制指令,满足安全冗余要求,为 L2+ 辅助驾驶提供高性价比方案。
局限
- 论文在 LIBERO、RoboTwin 2.0 和单个真实机器人上验证了 FastOPD,但未系统评估跨场景、跨机器人形态或分布外任务的泛化能力。与原始大模型相比,蒸馏后的紧凑模型在长程多步任务上的性能退化程度不明确。由于只报告了平均成功率和推理延迟降低,缺少对失败模式的分析,难以判断性能损失集中在哪些操作类型或环境条件下。
- FastOPD 依赖 on-policy 数据收集,蒸馏过程中需持续与环境交互生成 rollout,这比离线蒸馏更耗时且需要仿真器或真实机器人支持。对于真实机器人部署,在线交互成本高,可能限制其在大规模场景中的可行性。论文未提供与离线蒸馏方法的训练效率对比,也未讨论如何降低 on-policy 采样的样本复杂度或利用已有数据减少交互轮次。
- 方法假设教师策略基于 flow matching 的连续归一化流,利用 flow map 和自一致性目标进行蒸馏。对于非 flow-based VLA(如扩散策略、自回归离散动作模型)可能无法直接适用。理论分析建立在理想化 flow map 可精确拟合的假设上,实际中教师模型本身的近似误差可能被忽略,导致蒸馏学生偏离理想分布。此外,与 DMD、CTM 等现有少步蒸馏基线相比,84% 的性能保留率虽然领先,但绝对性能仍有显著损失,说明方法在极限压缩下可能遇到瓶颈。