MEA: 面向忠实模型解释的奖励驱动多智能体系统
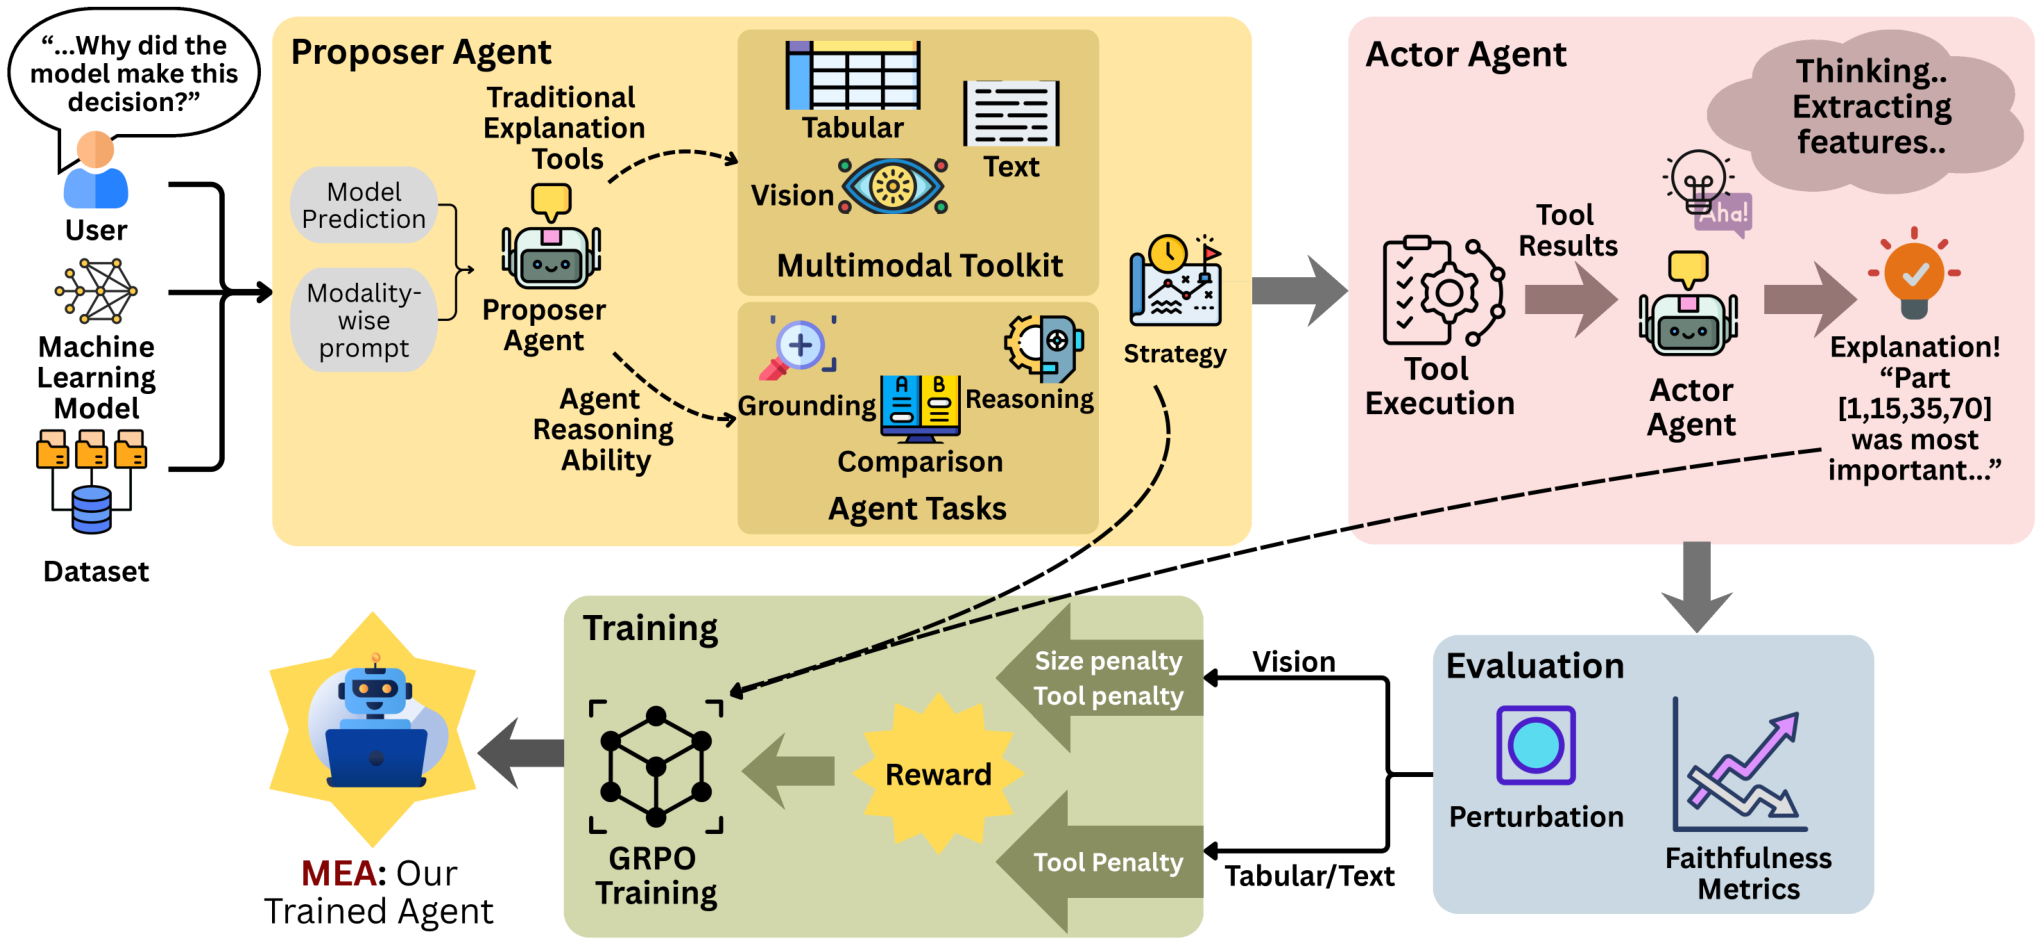
近年来,机器学习(ML)模型在高风险领域被大量采用,但对于依据其预测采取行动的从业者而言,这些模型仍大多不透明。尽管事后解释方法(post-hoc explanation methods)为洞察模型行为提供了视角,但要有效运用它们,所需专业知识远超多数领域专家所具备的范围:驾驭高维输出、挑选最佳解释、以及整合来自不同工具的证据。 为此,我们提出 MEA,一个多智能体框架,彻底消除解释的知识门槛:Proposer agent 依据问题与模态选择并配置解释工具,而 Actor agent 针对忠实性(faithfulness)进行端到端优化,将输出转化为扎根于模型行为的自然语言解释,覆盖表格、文本与视觉三种模态。此外,我们引入了涵盖特征归因、反事实推理与虚假特征检测的多样化问题类型,每种类型都配有基于扰动的忠实性指标。 我们发现,前沿 LLMs 会系统性地产生不忠实的解释。通过针对加入模态自适应惩罚的忠实性奖励进行优化,MEA 在六个数据集上持续优于 post hoc explainers、agentic 与闭源基线,相比未训练主干,奖励驱动优化带来的忠实性提升为: - +28%(表格) - +21%(文本) - +34%(视觉) 更广泛地看,我们的发现表明,AI agent 自身可以充当可扩展、自适应的 ML 可解释性接口,为自然语言可解释性开辟一条道路,使其超越长期以来定义该领域的固定、单一用途工具。
论文精读
TL;DR MEA 用奖励驱动的多智能体框架生成忠实模型解释:Proposer 选择解释工具,Actor 端到端优化 faithfulness,跨表格 / 文本 / 视觉产出自然语言。相比未训练骨干,faithfulness 分别提升 +28%/+21%/+34%。
问题
问题背景
在高风险场景(医疗、金融、自动驾驶)中,模型预测的可信度依赖于可解释性,但一线实践者往往无法直接消化现有解释工具的输出。
现有方法局限
- Post-hoc 解释器(如 SHAP、LIME、Grad-CAM)输出高维归因图/向量,要求使用者具备专业判断力,选择合适解释工具并综合多源证据。
- 直接让 LLM 生成解释存在系统性不忠实:模型倾向于生成表面合理但偏离真实决策逻辑的文本。
- 现有工具大多面向单一模态与单一问题类型,难以覆盖特征归因、反事实推理、伪特征检测 等多样化需求。
为什么难/重要
- 忠实度评估 需要扰动式指标(perturbation-based faithfulness),在不同模态下设计统一的奖惩信号较困难。
- 跨表格、文本、视觉的模型行为差异大,单一固定后处理工具难以泛化。
- 业界对模型审计与合规要求提升,急需可扩展、自然语言化的解释接口。
论文发现前沿 LLM 即使在有解释工具输出时也会生成不忠实解释,说明仅靠 prompt 无法解决 grounding 问题。
行业类比
类似于 RAG 用检索增强抑制 LLM 幻觉,可解释性也需要将 LLM 与工具调用、奖励驱动优化 结合,才能生成忠实于底层模型行为的解释。
核心洞察
- MEA 将 ML 可解释性重构为可微优化的强化学习问题,而非简单的工具编排。它端到端训练 Actor agent,以 perturbation-based faithfulness 指标为奖励,直接优化解释文本的忠实度。与现有 agentic XAI 系统(如仅调用固定工具并让 LLM 总结)不同,MEA 通过 reward 信号调整模型参数,使生成的自然语言解释在模型行为层面被验证,解决了 LLM 生成看似合理但实际不忠实解释的问题,并借助 modality-adaptive penalty 跨模态稳定优化。
- MEA 提出多模态统一解释框架,覆盖表格、文本、视觉数据,并支持特征归因、反事实推理、虚假特征检测等多样化问题类型。传统 post-hoc 方法通常为单一模态或单一任务设计,而 MEA 的 Proposer agent 根据问题和模态动态选择并配置解释工具,Actor agent 再生成自然语言解释。这种 agentic 架构使单一系统能够泛化到不同数据形态和解释需求,展示 AI agent 作为通用可解释性接口的潜力,替代固定、单一用途工具。
- 实验揭示前沿 LLM 在零样本情况下系统性地产生不忠实解释,即使文本流畅合理。这一发现挑战了直接使用 LLM 作为解释器的假设,强调需要专门的优化或约束。MEA 通过 reward-driven optimization 将忠实度提升 21%-34%,证明针对 faithfulness 的训练可以显著修正 LLM 的偏差。这为可解释性研究提供了新基准:不仅评估解释的合理性,更要验证其与模型实际行为的对齐程度。
方法
输入与意图解析
MEA 接收用户问题 与数据模态(表格 / 文本 / 视觉),问题覆盖特征归因、反事实推理、虚假特征检测等类型。Proposer agent 负责意图感知的策略形成:根据问题类型和模态特征,从预定义 XAI 工具库中选择合适工具(如 SHAP、LIME、Integrated Gradients、基于扰动的反事实生成器等)并配置其参数,输出可执行的工具调用计划。
关键模块
- Proposer Agent:策略形成,将用户意图映射为工具选择与配置。
- Actor Agent:接收工具链产生的原始解释输出(如特征权重、反事实样本),将其转化为自然语言解释,并端到端优化使其忠实于底层模型行为。
- 训练与奖励:用扰动基的忠实度指标 作为奖励信号——对输入施加扰动,比较解释所指特征与模型预测变化的一致性。奖励中加入模态自适应惩罚项,防止模型利用模态特性产出高奖励但无意义的解释。
输出
最终输出为跨模态的自然语言解释,通过奖励驱动的优化,MEA 在表格、文本、视觉数据集上的忠实度相比未训练骨干分别提升 +28%、+21%、+34%。
与同类方法的差异点:传统 post-hoc 解释器通常是固定单一工具,依赖使用者主观选择;MEA 通过多智能体自动选择与组合解释工具,并用端到端奖励优化让 LLM 生成的解释直接对齐模型真实行为。
实验
实验在六个数据集上覆盖表格、文本、视觉三种模态,并引入三类问题:特征归因、反事实推理、伪特征检测。每类问题均配有基于扰动的忠实度指标。Proposer 智能体根据问题与模态选择并配置解释工具,Actor 智能体端到端优化生成自然语言解释。实验将 MEA 与 post hoc 解释器、现有 agentic 框架及闭源 LLM 基线对比,并使用未训练骨干模型作为消融参照。
关键发现:前沿 LLM 会产生系统性不忠实解释——即使面对简单问题,其生成内容往往与真实模型行为脱节。通过 reward-driven 优化并加入模态自适应惩罚,MEA 在忠实度指标上显著提升,相对未训练骨干分别获得 +28%(表格)、+21%(文本)、+34%(视觉)的增益,且在所有数据集上一致优于其他基线。
这一结果说明,单纯增大 LLM 规模或调用更多工具并不能保证解释忠实度;关键在于将奖励信号与扰动验证对齐,并施加正则防止跨模态漂移。对工程实践的启示是:多智能体 + 可微奖励优化可以作为通用解释层,替代为每个模型单独定制解释工具,降低部署与维护成本。
行业影响
落地场景
MEA 可嵌入金融风控、医疗影像、电商推荐等需要模型解释的产品。例如,信贷审批中,MEA 自动生成拒绝原因的特征归因;医疗诊断中,对病灶检测提供反事实解释(如“若该区域信号增强,则预测置信度提高”)。此类场景需要高保真、多模态、自然语言解释,传统 SHAP / LIME 输出原始散点或热力图,业务人员难以直接使用。
商业价值
通过保真度奖励端到端优化,MEA 的增益(表格 +28%、文本 +21%、视觉 +34%)直接降低错误解释带来的误信风险。降本方面:减少人工审核解释合理性的人力,加速模型审计与合规报告生成。体验方面:自然语言解释提升非技术利益相关者对模型的接受度,减少因解释不清导致的投诉和返工。对比固定单任务解释工具,MEA 的多智能体框架灵活适应多模态、多问题类型,避免为每个解释任务单独开发和维护工具链。
与现有产品/工作流接口
MEA 可作为独立解释服务接入 MLOps 栈:从模型注册表获取模型和输入数据,通过 API 返回自然语言解释。集成示例:
- 在 MLflow / Kubeflow 流水线中增加 MEA 后处理节点;
- 与 SHAP / LIME 等工具共存,由 Proposer 按需调用,Actor 统一转译;
- 输出格式支持 JSON/Markdown,便于嵌入审计仪表板或 BI 报告。
局限
- **扰动基础度量** 的适用边界未充分界定。MEA 的忠实度依赖对输入特征或表示进行扰动后观察模型输出变化,但这类方法通常要求模型可微、支持前向迭代,对黑盒 API 或计算昂贵的大模型不够友好。此外,论文采用的扰动设计(如表格特征的随机掩码、文本 token 删除、图像超像素掩码)虽参考了常见做法,但不同扰动方案可能得到不同的忠实度排序,缺少统一校准标准。这导致评估结果可能偏向局部解释质量,而全局行为一致性、反事实合理性等维度未被覆盖,与同类工具对比时可能高估自身优势。
- **端到端 GRPO 训练代价高**,实际部署门槛较大。MEA 需同时维护 Proposer 与 Actor 两个智能体,并通过强化学习优化 Actor 的策略,涉及多轮采样、奖励计算与梯度更新,对 GPU 资源、训练时长和超参数(如模态自适应惩罚系数)均较敏感。虽然论文报告了与未训练骨干相比的忠实度增益,但未提供与更轻量提示工程或单智能体方案的效率对比,也未讨论推理延迟。在资源受限的工业场景中,这类多智能体 + RL 框架可能难以快速迭代,限制了其从研究到生产的转化。
- **实验范围较窄,缺少人类评估**。论文在 6 个数据集上验证,覆盖表格、文本、图像三种模态,但数据规模与多样性有限,且问题类型为特征归因、反事实、虚假特征检测三类,未涉及更复杂的解释需求(如时序、图结构、生成模型内部机制)。同时,评估只关注忠实度指标,未收集领域专家对解释可读性、可操作性的主观反馈,也未与人类专家撰写的解释进行对照。这可能陷入“忠实但难懂”的困境,即优化目标是模型行为的一致性,但解释文本的语义质量、逻辑连贯性未受约束,实际用户能否受益仍未知。