DeskForge:面向 Computer-Use Agents 的桌面环境稠密监督
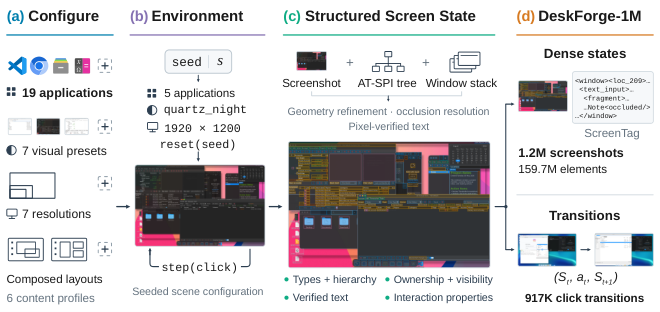
Computer-use agent 需要在多应用、窗口重叠、控件外观相似的复杂桌面场景中可靠定位动作目标,而现有训练数据很少为这类场景提供稠密标注,也难以可控地变化场景。 我们提出 DeskForge,一个可控桌面环境,通过组合与探索真实应用为 computer-use agent 生成大规模监督:它变化应用状态、内容、窗口布局、外观与分辨率,把截图、accessibility tree 和窗口几何融合为稠密元素标注,并记录每个动作的执行结果。基于该环境构建的 DeskForge-1M 包含 1.2M 条标注观测与 159.7M 个元素实例。 我们在取自 DeskForge-1M 的 200K 条 grounding 样本上微调四个 vision-language 模型,它们在留出桌面条件与全部五个外部 GUI grounding 基准上均有提升:Qwen3.5-4B 在 ScreenSpot-Pro 上提升 11.51 个百分点,在 OSWorld-G 上提升 10.11 个百分点。在固定 planner 下,微调后的动作模型也完成更多 WebArena-Infinity(31→50 / 119)与 OpenApps(3→15 / 100)任务。 这些结果表明,可控地组合真实桌面环境为提升 GUI grounding 与长程 computer use 提供了可扩展的监督来源。框架代码、数据集与微调模型见项目主页。
论文精读
TL;DR DeskForge 构建可控桌面环境,合成大规模密集标注(DeskForge-1M),微调视觉语言模型后 GUI grounding 与长程任务完成率显著提升。
问题
问题背景
计算机使用智能体(computer-use agents)需要将自然语言指令中的动作目标可靠地定位到复杂桌面场景的屏幕元素,这一能力被称为 GUI grounding。随着多模态大模型在 Agent 任务中的普及,grounding 已成为长链路任务完成的瓶颈。
现有方法局限
- 训练数据单一:现有数据集多为静态截图或合成 UI,很少将真实桌面场景与密集元素标注(屏幕坐标、语义 ID)配对。
- 场景变化不受控:窗口布局、分辨率、外观、应用状态等维度缺乏系统性扰动,导致模型对遮挡、重叠、相似控件泛化差。
- 人工标注昂贵:逐元素标注真实桌面截图成本高,难以覆盖多应用组合与动态交互;移动端 / 网页端的自动化采集无法迁移到桌面级环境。
为什么这个问题难/重要
真实桌面任务需要同时处理多个应用窗口的重叠、视觉上相似的按钮或输入框,且要求像素级定位准确。任何 grounding 错误都会导致后续规划、操作失败,进而影响长链路任务完成率(如 WebArena-Infinity、OSWorld-G)。业界对 GUI 智能体的可靠性要求不断提升,但公开的密集监督数据严重不足,可控生成成为规模化出路。
行业类比
类似自动驾驶通过仿真引擎合成多样道路场景来提升感知模型,桌面环境可视为 GUI 智能体的“驾驶模拟器”,为 grounding 提供可扩展、可标注的训练场。
核心洞察
- 可控组合真实桌面应用生成密集监督,突破传统 GUI 数据瓶颈。DeskForge 不是合成界面或静态截图,而是动态组合真实应用(应用状态、内容、窗口布局、外观、分辨率均可变),从而生成高度多样且带逐元素标注的训练样本。这与现有数据集(如 SeeClick、ScreenSpot 等仅提供有限标注或不可控采集)形成对比,使模型能学习到窗口重叠、视觉相似控件等复杂场景下的 actionable grounding。
- 融合截图、无障碍树和窗口几何的 dense element annotation,并记录每个动作结果,提供 grounding 与 outcome 双监督。DeskForge-1M 的 1.2M 观测包含 159.7M 元素实例,标注粒度精细到单个 UI 元素,且动作执行结果被记录。这比仅依赖图像-指令对或弱监督的方法更接近真实计算机使用场景,使模型不仅学会“看”目标,还学会“做”后反馈,从而在长时任务上显著提升(如 Qwen3.5-4B 在 WebArena-Infinity 从 31/119 到 50/119)。
方法
输入与场景合成
DeskForge 采用可组合的真实桌面应用作为输入源,通过脚本化控制应用状态、内容、窗口布局、外观主题和屏幕分辨率,生成多样化桌面场景。每个场景包含多个应用窗口,可设置重叠、遮挡、缩放等布局,模拟真实多任务工作环境。
关键模块:密集标注与交互记录
- 标注融合:环境同时采集截图、无障碍树和窗口几何信息,通过坐标对齐和规则融合,生成每个 UI 元素的密集标注,包括边界框、角色、文本内容和可见性状态。平均每个观测包含上百个元素实例。
- 交互记录:对场景中的元素执行点击、输入、滚动等动作,记录动作参数、执行前后状态变化以及结果标签(成功/失败/异常),形成完整的动作-结果监督对。
- 指令构建:基于交互上下文,使用模板或语言模型自动生成自然语言指令(如“点击标题为‘保存’的按钮”),与观测和动作配对,用于训练模型的接地与规划能力。
输出与训练数据
最终输出为 DeskForge-1M 数据集,包含 1.2M 观测、159.7M 元素实例以及对应的交互轨迹。从该数据集抽取 200K grounding 样本,用于微调视觉语言模型,使其在桌面场景中准确地将指令与视觉元素对齐。
与同类方法的差异点:DeskForge 强调可控地合成真实应用环境,而非依赖纯模拟器或静态截图,同时提供远超以往工作的元素级密集标注和动作结果反馈,从而支持更细粒度的 GUI 接地和长期任务学习。
实验
实验设计
DeskForge 构建了一个可控桌面环境,通过组合真实应用并改变状态、布局、外观、分辨率等生成大规模密集标注数据 DeskForge-1M(1.2M 观测、159.7M 元素实例)。从中抽取 200K grounding 样本,对四个视觉语言模型(含 Qwen3.5-4B)进行 grounding 微调。评估覆盖四类任务:
- 留出桌面条件(held-out desktop conditions)泛化测试
- 五个外部 GUI grounding 基准(含 ScreenSpot-Pro、OSWorld-G)
- 固定 planner 下的长程任务完成(WebArena-Infinity、OpenApps)
- 稠密元素检测
关键发现
所有四个模型在留出桌面条件和全部五个外部基准上均有提升,其中 Qwen3.5-4B 提升最显著:
| 基准 | 提升幅度 |
|---|---|
| ScreenSpot-Pro | +11.51 pp |
| OSWorld-G | +10.11 pp |
长程任务中,在固定 planner 条件下,Qwen3.5-4B:
- WebArena-Infinity:任务解决数从 31/119 提升至 50/119
- OpenApps:任务解决数从 3/100 提升至 15/100
与基线对比解读
与未微调模型相比,DeskForge 微调带来的提升不仅限于桌面环境,还能泛化到外部基准和真实世界长程任务,表明可控组合真实桌面环境可提供可扩展的监督来源。相对于合成界面数据,DeskForge 强调真实应用组合与密集几何/语义标注,有助于缓解视觉相似控件混淆问题,尤其在重叠窗口和复杂布局下显著增强目标 grounding 能力。
行业影响
落地场景
- 企业级桌面自动化:DeskForge 生成的密集标注数据可用于训练 GUI 定位模型,改进 RPA 流程中跨应用、跨窗口的元素识别准确性,适用于财务对账、数据录入、客服工单处理等桌面任务。
- 软件测试:可控环境和密集元素标注支持生成大规模回归测试集,验证跨分辨率、主题、内容变化下的 UI 稳定性。
- 无障碍辅助:精准的屏幕元素定位帮助视障用户通过语音指令操作桌面软件,提升数字包容性。
商业价值
- 降本:DeskForge-1M 包含 159.7M 元素实例的密集监督,可大幅减少人工标注和自建环境成本;微调后的 Qwen3.5-4B 在 ScreenSpot-Pro 上提升 11.51 个百分点,意味着更少的人工干预和返工。
- 增效:论文显示在固定规划器下,微调动作模型将 WebArena-Infinity 任务完成率从 31/119 提升至 50/119,OpenApps 从 3/100 提升至 15/100,直接提高自动化流程的端到端成功率。
- 加速部署:现成的环境、数据集与开源模型缩短了从实验到生产的迭代周期。
与现有产品/工作流的接口
- 模型微调:直接用 DeskForge 的 grounded 数据对现有 VLM(如 Qwen、LLaVA)做 SFT,替换默认 grounding 模块。
- RPA 平台集成:通过 API 接入 UiPath、Automation Anywhere 等,提供更鲁棒的元素定位后端。
- 测试框架插件:与 Selenium、Playwright 结合,在桌面应用测试中使用微调模型识别动态 UI 元素。
具体落地 use case
- 电商平台订单管理后台:客服需跨多个内部系统核对订单、库存、物流信息。使用 DeskForge 微调的 computer-use agent 可自动完成跨窗口操作,减少人工切换和数据复制错误。
- 金融报表自动化:从多个桌面应用(Excel、ERP、BI 工具)抓取数据并生成报告,智能体能精准定位重复性 UI 控件,提高月度结账效率。
局限
- - **应用覆盖与可扩展性受限**:DeskForge 依赖真实桌面应用进行组合与探索,当前实验主要覆盖常用软件(如浏览器、办公套件、文件管理器等)。对于行业专用软件、自绘控件密集的应用或闭源工具,无障碍树与窗口几何信息的获取可能不完整,导致密集标注缺失或错误。环境维护成本高,新增应用需要适配采集管线与外观预设,长期可扩展性存疑。与合成界面生成方法相比,真实应用带来的视觉复杂度更贴近实际,但牺牲了任意场景合成的自由度。
- - **标注噪声与质量依赖**:密集标注由截图、无障碍树和窗口几何融合而来,但部分应用(如 Canvas 渲染、视频播放器)的无障碍树信息稀疏,依赖视觉检测或几何推断易引入噪声。论文提到的自动化质量控制(如可见几何筛选)能过滤明显错误,但边界情况下的误标仍可能影响模型学习。此外,指令合成使用模板与 LLM 生成,与真实用户自然语言指令分布存在偏差,可能导致微调后模型对口语化、模糊指令的泛化不足。
- - **实验设置与评测局限**:虽然四个 VLM 微调后在 external benchmarks 和 long-horizon 任务上提升显著,但固定 planner 仅评估 action grounding 部分,未考虑完整 agent 系统(如规划、记忆)的联合优化。微调仅使用 200K 示例(总数据集 1.2M 观察),可能未充分挖掘规模收益。另外,数据集与评测基准均以英文为主,多语言桌面场景未覆盖;grounding 指标侧重中心点命中,对目标边界框重叠、遮挡处理等细粒度评测不足,可能高估实际可用性。