Spatial Memory Intelligence:赋予世界模型理解驱动的长期记忆
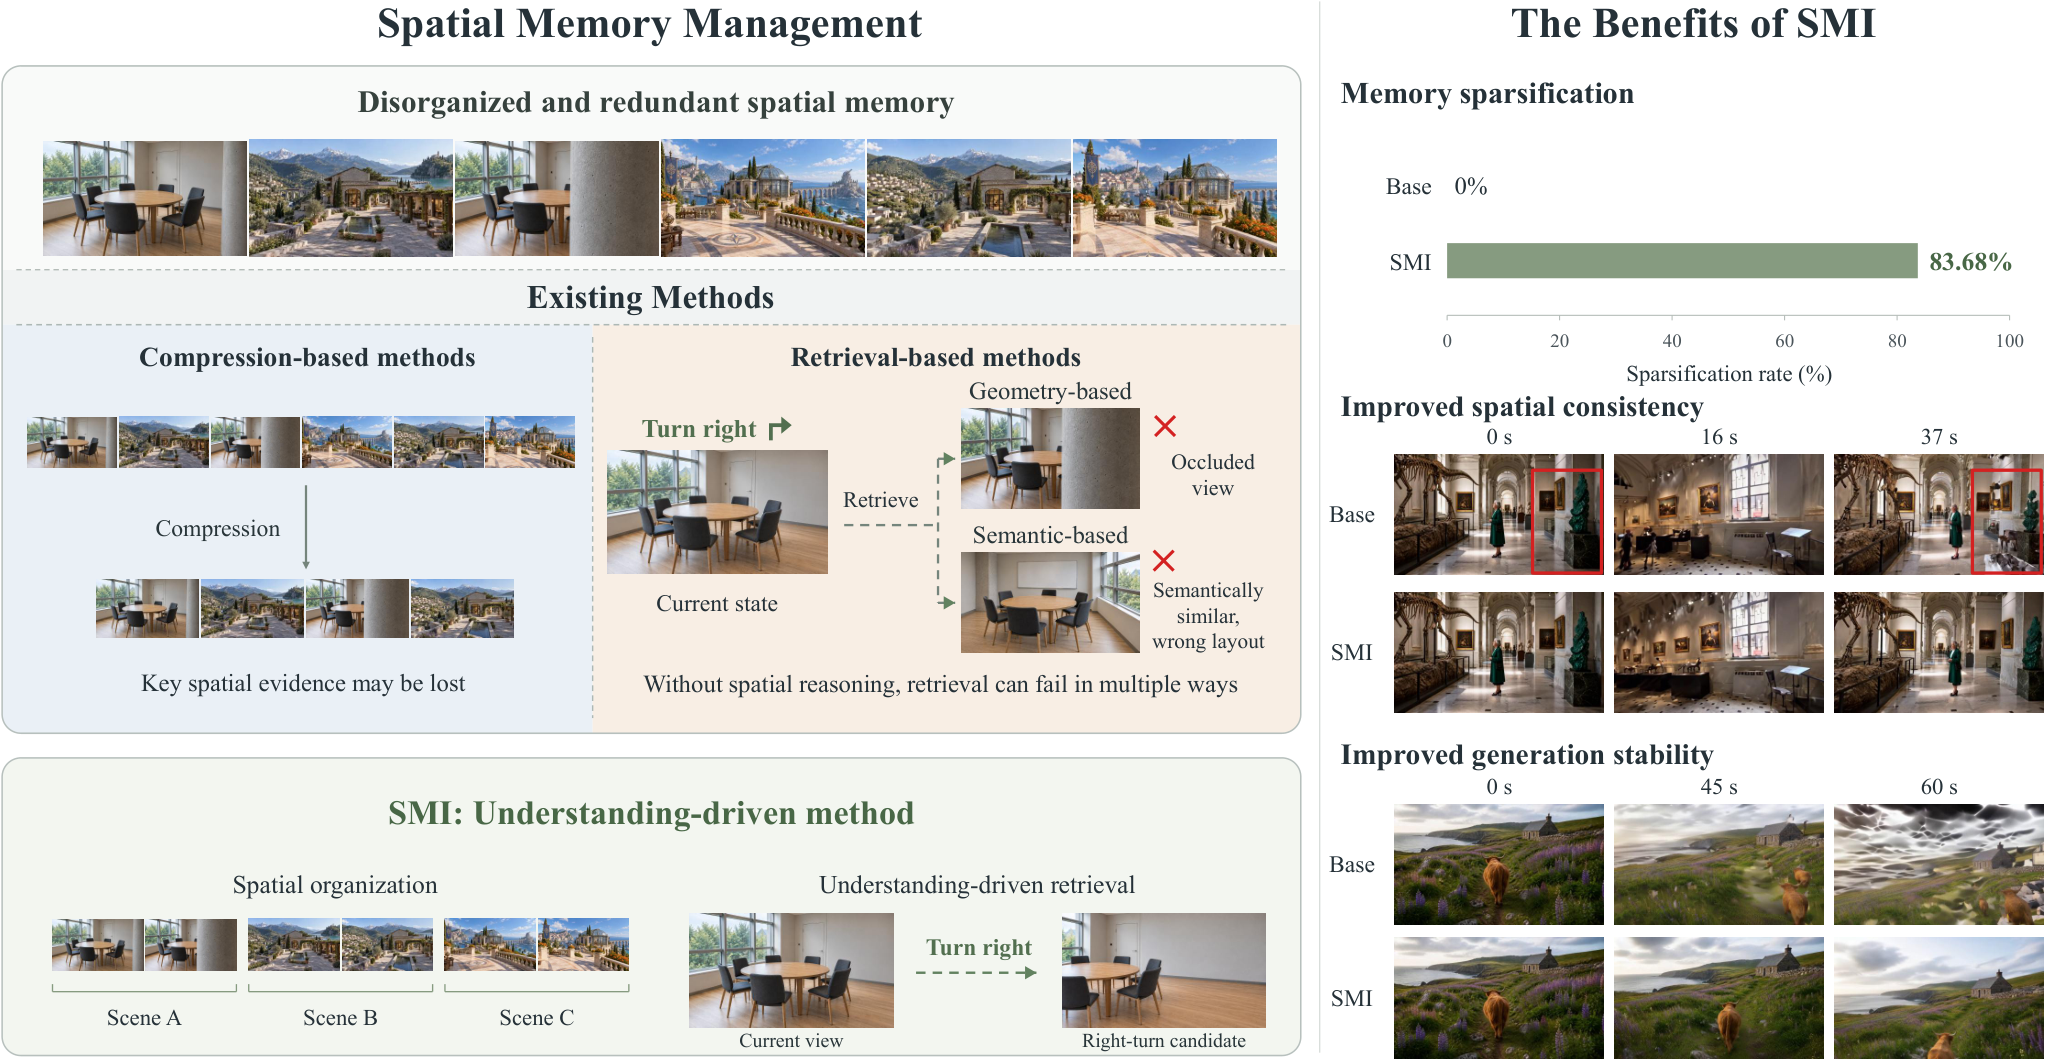
长视频生成与世界模型在交互娱乐和具身模拟中展现出强大潜力,能够基于用户动作与历史记忆预测未来观测。然而,随着记忆序列不断增长、结构日益复杂,长程空间上下文的管理变得愈发困难,亟需更智能、系统化的记忆管理策略。 基于 多模态大语言模型 (MLLMs) 不断提升的空间推理能力以及统一模型的愿景,我们提出 Spatial Memory Intelligence (SMI),这是首个系统性地利用理解模型为长视频世界模型进行空间记忆管理的框架。SMI 引入四个协同的原子操作:空间聚类、簇内稀疏化、动作感知检索 与 可靠性感知过滤。 在多种基线、基准与世界模型骨干上的大量实验表明,SMI 具有有效性与泛化性,在 记忆稀疏度、生成稳定性 与 空间一致性 方面均取得全面提升。
论文精读
TL;DR SMI 首次用多模态大模型管理长视频世界模型的空间记忆,通过聚类、稀疏化、动作检索与可靠性过滤四操作,显著提升记忆稀疏性、生成稳定性和空间一致性。
问题
问题背景
长视频生成与世界模型正成为交互娱乐与具身仿真的核心方向,其核心能力是根据历史观测与用户动作预测未来帧,因此对长程时空上下文的记忆管理至关重要。
现有方法局限
当前主流做法依赖固定长度的滑动窗口、随机采样或基于启发式规则的记忆压缩,缺乏对场景语义和空间结构的理解:
- 滑动窗口 会直接丢弃窗口外的关键空间信息,导致跨时刻的空间一致性断裂;
- 随机/均匀采样 无法区分记忆 token 的重要性,容易保留冗余背景而丢失关键物体;
- 基于规则的压缩(如基于注意力分数)不感知动作与场景变化,无法按需检索与当前动作相关的空间片段。 随着记忆序列增长,存储和计算开销线性上升,记忆稀疏性、生成稳定性与空间一致性显著下降。
为什么这个问题难/重要
空间记忆管理不仅关乎压缩率,更需理解"哪些空间信息在未来预测中仍然有效、哪些因动作而失效"。这涉及多模态语义理解、长程依赖建模、动作条件检索的联合优化,是跨视频生成与 MLLM 的交叉难题。业界对世界模型的投入持续增加,长时记忆能力直接决定其在具身智能、互动内容生成中的可用性与可扩展性。
行业类比
类似于 LLM 面对超长上下文时的记忆管理挑战,世界模型也需要"理解驱动"的记忆子系统,而非仅靠截断或滑动窗口,以在有限上下文预算内保留对未来预测最有价值的空间线索。
核心洞察
- SMI 的核心价值在于把记忆管理从规则式压缩升级为理解驱动的语义调度,并具体化为四个可组合的原子操作。传统长视频世界模型常用固定窗口、时间衰减或 token 相似度检索来维护历史记忆,缺乏对空间结构和动作关联的理解;SMI 让 MLLM 执行 spatial clustering、within-cluster sparsification、action-aware retrieval 和 reliability-aware filtering,将压缩与查询绑定到场景实体和动作上下文,直接改善 memory sparsity 和 spatial consistency。这种把记忆管理本身作为可学习任务、并配以 operation-oriented data construction 的思路,比单纯更换 backbone 或增大上下文窗口更根本。
- 原子操作的流水线设计值得关注:spatial clustering 先按空间关系分簇,within-cluster sparsification 做簇内去冗余,action-aware retrieval 按动作意图取回相关记忆,reliability-aware filtering 再对记忆可信度过滤。这一串操作不是孤立技巧,而是通过 teacher annotation 和 quality control 构造对应监督,让 MLLM 学会“何时压缩、何时保留、如何与动作对齐”。相比现有 memory module 仅实现检索或压缩的单一功能,SMI 提供了一个可扩展、可插拔的记忆管理层,在多个 baselines 和 backbones 上复现提升,证明其泛化性。
方法
输入
SMI 接收长视频世界模型的历史记忆序列与当前用户动作。历史记忆包含逐帧视觉特征及空间位置信息,长度随交互增长,结构复杂。
关键模块:MLLM 驱动的空间记忆管理
SMI 首次引入多模态大语言模型(MLLM)作为理解模型,对记忆执行四个原子操作:
- 空间聚类:将记忆中的空间区域按语义相似度分组,形成若干空间簇,避免碎片化。
- 簇内稀疏化:在每个簇内去除冗余帧或特征,保留代表性样本,显著降低记忆长度。
- 动作感知检索:根据当前动作查询记忆库,检索与动作最相关的空间上下文,提升生成一致性。
- 可靠性感知过滤:评估各记忆条目的置信度,过滤低质量或可能引发幻觉的条目,增强稳定性。
上述操作通过操作导向数据构建训练 MLLM 获得,使模型能输出结构化决策。
输出
经过 MLLM 处理后的精简、可靠、动作相关的空间记忆,输入到世界模型 backbone,用于生成未来观测帧。
传统记忆管理依赖固定规则或启发式压缩,SMI 首次将 MLLM 的理解能力系统化地引入长视频世界模型的记忆运营,实现动态、动作感知、可靠性驱动的空间记忆优化。
实验
实验设计
SMI 在多个 long-video world model 骨干(如 HY1.5 和 Wan2.2)及多个基准上验证,引入 空间聚类、簇内稀疏化、动作感知检索、可靠性感知过滤 四个原子操作。通过操作导向数据构造训练 MLLM,评估记忆稀疏性、生成稳定性和空间一致性,并开展组件消融与操作导向训练效果分析。
关键发现
实验表明 SMI 在多个基线上一致提升记忆稀疏性、生成稳定性和空间一致性。四个原子操作协同工作,消融显示每个组件均有正向贡献;操作导向训练显著提升 MLLM 的记忆管理能力。跨骨干泛化验证了方法通用性。
基线对比解读
与传统基于规则或启发式的记忆管理不同,SMI 首次系统性利用 MLLM 的空间推理能力,从“存储-检索”转向“理解-决策”。它不依赖固定阈值,而是根据场景语义、动作关联和可靠性动态调整记忆,更适合长序列复杂空间上下文。实验证明其在多种骨干上有效,表明该思路可成为世界模型记忆模块的通用设计范式。
行业影响
落地场景
- 开放世界游戏与虚拟制作:长期运行的 3D 场景或视频世界模型,需要管理大量空间记忆。SMI 可在用户操作下保持场景布局与物体位置一致,避免穿帮或漂移,适合 AAA 游戏、互动影游、虚拟制片。
- 自动驾驶与机器人仿真:world model 生成多样驾驶场景,需在长序列中记住道路结构、车辆位置。SMI 的稀疏化与动作感知检索可降低显存,同时保持生成稳定性。
- 电商虚拟试穿 / 室内设计预览:生成连续视频必须保持空间连贯,SMI 可提升商品展示质量。
商业价值
- 降本:
within-cluster sparsification与reliability-aware filtering大幅减少参与推理的记忆 token 数,直接降低 GPU 显存与推理延时,使长视频生成服务可规模化。 - 体验提升:
action-aware retrieval让生成内容更贴合用户操作,减少空间错乱,提升用户沉浸感与留存。 - 产品化加速:SMI 作为独立记忆管理组件,可复用到不同 world model 骨干(如 HY1.5、Wan2.2),降低企业自研成本。
与现有 stack 接口
SMI 以 memory plugin 形式插入现有 video diffusion / world model 推理管线,输入历史帧与用户 action,输出过滤后的记忆 token 供生成模块使用。训练阶段采用 operation-oriented data construction,可通过 MLLM 标注构建监督信号,无需大幅修改骨干网络。实现参考 GitHub 仓库,项目主页 spatial-memory-intelligence.github.io 提供演示。
局限
- - **依赖 MLLM 能力**:SMI 将空间记忆管理完全委托给 MLLM,其性能上限受限于当前 MLLM 的空间推理与场景理解能力。在多模态大模型本身存在幻觉或细粒度空间定位不稳定的情况下,原子操作(如空间聚类、可靠性过滤)可能产生错误判断,进而导致记忆丢弃或检索不当。此外,MLLM 推理带来额外计算延迟和显存开销,在需要实时响应的交互式世界模型(如游戏引擎)中可能成为瓶颈,论文未讨论推理成本优化策略。
- - **数据构建成本较高**:论文提出的 operation-oriented data construction 依赖人工标注和教师模型监督,为每个原子操作生成高质量训练样本。这种数据获取方式难以大规模复制到新场景或新领域,尤其对于动态、复杂环境,标注空间聚类边界、动作相关性等需要专业知识,限制了框架的快速迁移能力。虽然文中提到用教师自动标注,但质量控制流程仍然需要人工介入,实际落地时数据成本不可忽视。
- - **跨场景泛化存疑**:尽管实验覆盖了多个 baselines 和 world-model backbones,但主要验证可能仍局限于特定类型的长视频生成任务(如自动驾驶、简单交互模拟)。对于涉及复杂物理、多智能体交互或长程因果推理的场景,四个原子操作的协作机制能否保持稳定的空间一致性尚未得到充分验证。此外,各操作之间的顺序和超参数(如聚类数目、稀疏率)需要针对不同任务微调,自动化程度不足。