World Editing: 以递增深度干预可执行世界
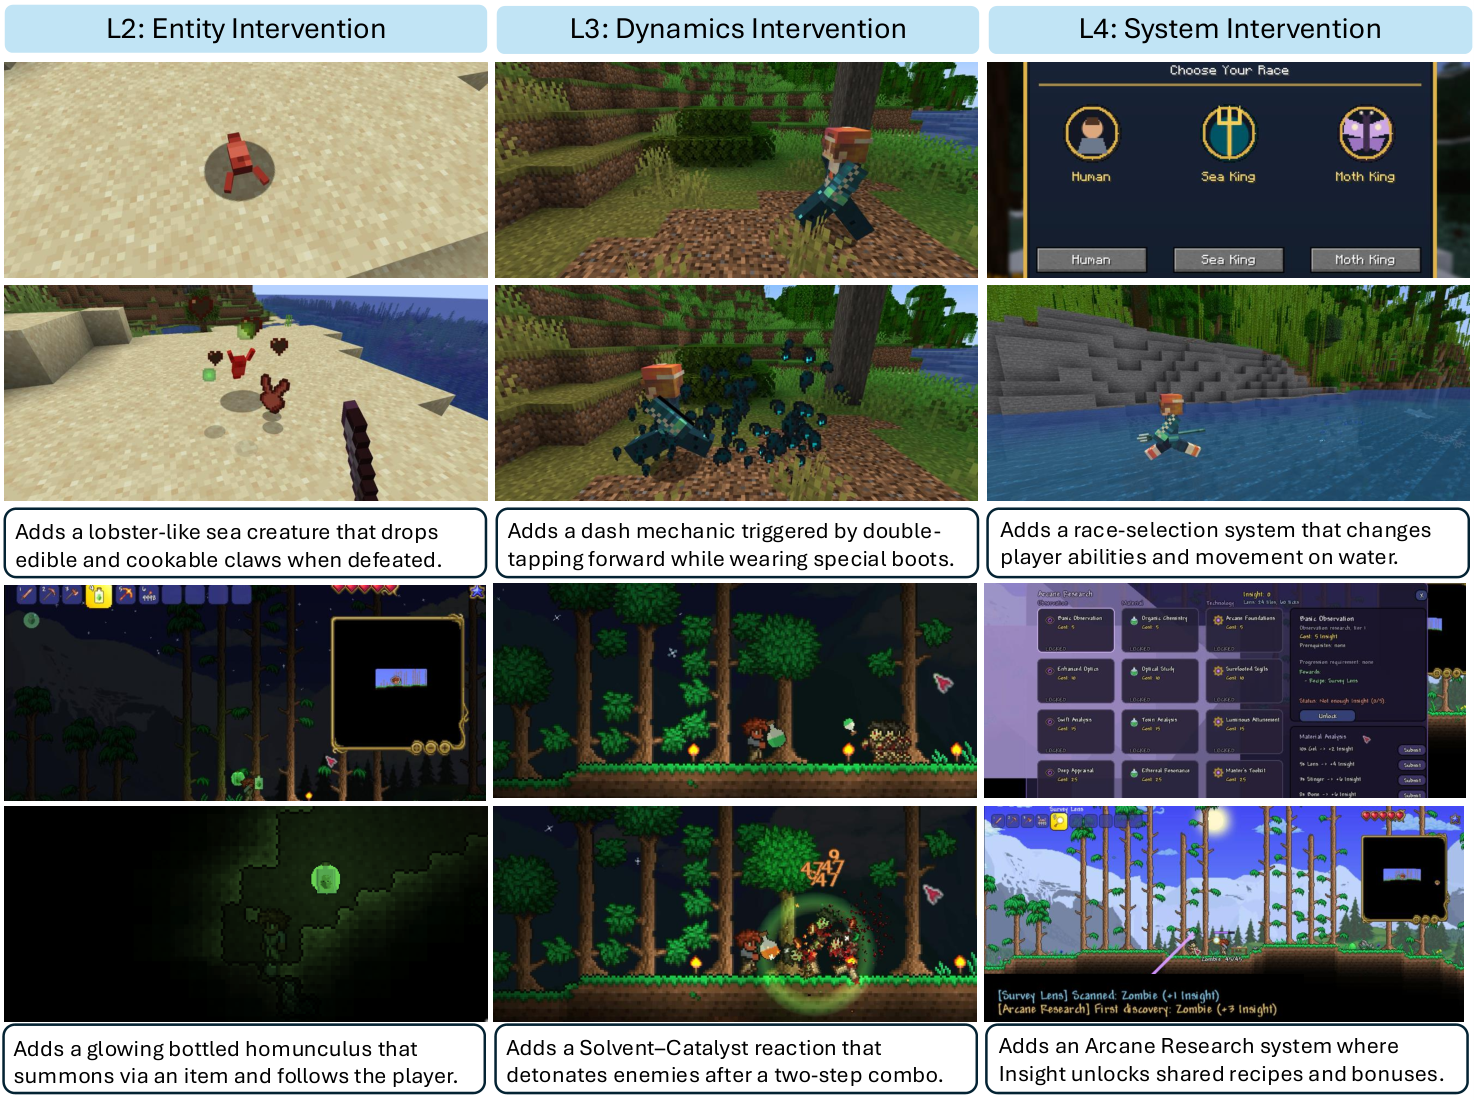
交互式世界模型已能生成环境并在其中行动,但有意编辑一个已有可执行世界仍未被充分探索。我们把 world editing 定义为在保留应保持不变性质的前提下干预已有世界,并引入 intervention depth 这一轴,描述编辑对世界实体、动力学与系统的耦合强度。 我们通过工业级游戏模组(game modding)实现该能力,提出 IGMWorld 与 IGMBench —— 覆盖 Minecraft 和 Terraria 的基准,含 110 个任务、逾 1.1K 条可执行状态与行为判据。任务分为属性、实体、动力学、系统四类干预,用确定性可执行性、行为、保持性与视觉检查来评估。 前沿编程 agent 已具备可观的世界编辑能力:最强配置在严格任务级标准下解决 78.2% 的任务,判据级达 94.8%。可靠性总体随干预深度下降,且在判据数量相近的任务中依然如此。多数失败编辑仍能构建并加载成功,说明难点在于让编辑后的世界按要求运行;视觉一致性是另一短板,所有配置的联合视觉通过率均低于 50%。 这表明世界编辑是与世界生成、世界交互不同的独立能力,而可执行游戏为研究它提供了实用试验台。
论文精读
TL;DR 论文将世界编辑定义为对可执行游戏世界的有约束干预,推出 IGMBench 基准;编码智能体可解决 78.2% 任务,但随干预深度增加可靠性下降,视觉一致性是主要瓶颈。
问题
问题背景
交互式世界模型近年聚焦于环境生成 与在环境中行动,但对已存在可执行世界的刻意编辑 研究不足。现有模型能生成新世界或在给定世界中执行任务,却缺乏对“修改既有世界并保持其余属性不变”的显式支持。
现有方法局限
现有工作大多将世界模型视为从零生成 或目标导向行动,没有系统定义编辑操作。具体局限包括:
- 缺少描述编辑耦合范围的统一轴,难以区分浅层属性修改与深层系统变更;
- 基准只关注生成质量或任务完成率,不检查编辑是否破坏世界其他部分;
- 没有联合评估可执行性、行为保持、视觉一致性,导致对“编辑是否正确”的判断不完整。 这导致现有方案无法区分“重新生成一个类似世界”和“真正编辑原世界”。
为什么这个问题难/重要
世界编辑的核心难点在于干预深度:修改实体、动态或系统时,耦合程度不同。浅层修改(如改变物体颜色)相对容易,但深层修改(如调整物理规则或系统交互)会引发级联效应,使本应保持的行为失效。论文发现,失败编辑大多仍能成功构建和加载,这表明可执行性不是主要瓶颈,行为正确性与视觉一致性才是。所有评估配置的联合视觉通过率低于 50%,凸显视觉一致性是独立短板。该能力对游戏 modding、仿真环境定制、机器人训练场景调整等有直接工程价值。
行业类比
这类似于在大规模代码库中做受控重构:修改一个模块时,必须保证回归测试全部通过,但现有工具往往只能确认“代码能编译”,无法保证行为不偏离预期。
核心洞察
- 世界编辑作为独立能力被正式化为对现有可执行世界的干预,并引入 intervention depth 轴刻画编辑对外部实体、动力学和系统的耦合程度。独特在于:以往世界模型评测聚焦生成或交互(如导航、对话),缺少对“编辑已有世界且不破坏无关部分”的系统化度量;该框架将编辑拆解为属性、实体、动力学、系统四个干预层级,使错误可以归因到具体耦合强度,为诊断模型编辑能力提供新维度。对工程启示:评测智能体不能只看生成质量或任务完成率,需要区分干预深度才能定位失败根源。
- 失败模式分析揭示:可执行性不是瓶颈,行为正确性和视觉一致性才是主要难点。独特在于:传统代码评测把“能编译/能运行”作为强信号,但 IGMBench 中大多数失败编辑仍能成功构建和加载,表明模型能生成语法正确、游戏可加载的 mod,却难以精确控制修改后的世界行为;视觉一致性尤其薄弱,所有配置联合视觉通过率低于 50%,反映当前编码代理在语义对齐和多模态约束上的共同短板。工程启示:构建世界编辑工具链时,应优先强化行为级验证器与视觉一致性检查,而非单纯依赖构建成功。
方法
方法框架
输入 为已有可执行世界(如 Minecraft / Terraria 的模组包)与自然语言编辑任务,要求修改某属性、实体、动态或系统,同时保持其余部分不变。
关键模块 包括:
- 干预深度定义:将编辑按耦合程度分为
property、entity、dynamics、system四个层级,刻画修改对世界实体、动态与系统的扰动强度。 - IGMWorld 基准:基于工业级游戏模组流程,构建 110 个任务、超过 1.1K 个可执行状态与行为标准,任务覆盖四类干预。
- 确定性评测:每个任务通过
executability(能否构建并加载)、behavioral(修改后行为是否符合预期)、preservation(未指定属性是否保持不变)、visual(视觉一致性)四类检查自动评分。
输出 是编辑后的可执行世界及逐项评测结果。最强编码智能体在严格任务级标准下解决 78.2% 任务,标准级性能 94.8%;失败主要集中在行为层而非构建层,视觉一致性为独立瓶颈。
与同类世界生成或交互工作的差异点:该方法以“保持未指定属性不变”为约束,将编辑可靠性按干预深度量化,而非只追求生成或单步行动成功。
实验
实验设计
论文提出 世界编辑 任务,通过 IGMWorld 在 Minecraft 和 Terraria 两大游戏环境实例化,构建 IGMBench 基准,包含 110 个任务、超过 1.1K 个可执行状态与行为标准。干预深度分为 property / entity / dynamics / system 四级,评估采用确定性可执行性、行为、保持性和视觉四类检查。前沿编码代理直接对游戏代码进行修改,实验未报告额外训练算力。
关键发现
- 任务级解决率 最高 78.2%(严格标准),标准级表现 达 94.8%。
- 可靠性随 干预深度 增加而下降,且该趋势在评估标准数量相近的任务中依然存在,说明深度本身引入耦合复杂度。
- 多数失败编辑仍能 构建并加载,表明主要难点在于让编辑后的世界行为符合要求,而非可执行性。
- 视觉一致性 是独立瓶颈,所有配置的 joint visual pass rate 均低于 50%。
作者论断:世界编辑是区别于世界生成与交互的独立能力。
与基线对比解读
无外部基线模型,实验对比不同干预深度与 agent 配置,显示可执行与行为正确之间存在显著差距。这提示实际工程中,仅验证游戏能否启动远远不够。IGMBench 可视为 world editing 能力的标准化测试集,为后续改进提供量化目标。
行业影响
落地场景
World editing 可直接用于 游戏开发与 UGC 平台,如 Minecraft 服务器自动化模组修改、Roblox 场景按需迭代。在 数字孪生与仿真 领域,修改现有场景实体(增加障碍物、调整动力学参数)并保持其余不变,支持自动驾驶长尾测试。也适用于 虚拟电商/展厅 的布局交互自动化修改。
商业价值
最直接的是 降本:将人工 mod 开发与回归测试自动化,减少游戏公司持续更新成本。其次是 增收:个性化世界编辑能力提升 UGC 生态活跃度,带动付费内容。体验上,教育模拟或培训系统可动态调整难度而不破坏整体逻辑。
与现有工作流接口
IGMBench 可充当 coding agent 的 世界编辑基准,类比 SWE-bench 之于软件工程,纳入 CI 流程评估编辑可靠性。可封装为游戏引擎插件或 Modding SDK 中的 可执行校验服务,输出 executable + behavioral + preservation 报告。与现有 world model(Genie、UniSim)结合后,为生成的环境提供“编辑层”。
具体落地 use case:
- 游戏内容平台:AI 助手理解玩家指令“提高僵尸速度 50%,保留掉落物规则”,生成 mod 补丁并自动验证不破坏其他机制。
- 自动驾驶仿真:在现有场景库中插入罕见障碍物、修改红绿灯时序,保持传感器模型不变,用于长尾场景回归测试。
局限
- **任务域与规模局限** 当前基准仅覆盖 Minecraft 和 Terraria 两款游戏,且 modding 接口高度依赖特定引擎与文件格式,难以直接泛化到其他可执行世界(如机器人仿真、代码沙箱或不同游戏引擎)。110 个任务、1.1K 标准虽具一定规模,但相较真实世界编辑空间的多样性仍偏小,且干预深度维度尚未得到充分采样,统计结论的稳健性有待更大规模验证。此外,评估指标依赖游戏特定的确定性检查,移植到新 domain 需要重新设计整套执行与判定逻辑。
- **视觉一致性评估不足** 论文报告所有配置的联合视觉通过率均低于 50%,并将视觉一致性列为独立瓶颈,但并未深入剖析失败成因(例如纹理生成质量、多模态对齐、时序稳定性等),也未提出针对性改进方法。视觉检查仅基于静态截图或选定的视觉属性,可能无法捕捉动态场景下的视觉缺陷,导致瓶颈被高估或低估。同时,现有编码代理对视觉反馈的利用率有限,世界编辑的视觉语义约束在任务定义中可能未被充分表达。
- **方法探索有限** 实验仅评估了现成的 frontier coding agents,这些代理在游戏机制上具有潜在的先验知识,且未对世界编辑这一特定问题做任何适配或监督信号设计,因此其性能上限不代表世界编辑的固有难度。论文提出的 intervention depth 目前仍停留在概念轴层面,缺乏定量度量与理论分析,难以指导后续算法设计(例如如何显式建模编辑的耦合强度)。与生成式世界模型相比,编辑任务的核心是保留约束,但现有代理并未显式编码该约束,这也可能是性能随深度下降的部分原因。