Omni-Embed-Mini:通过稠密蒸馏绑定多模态而不遗忘
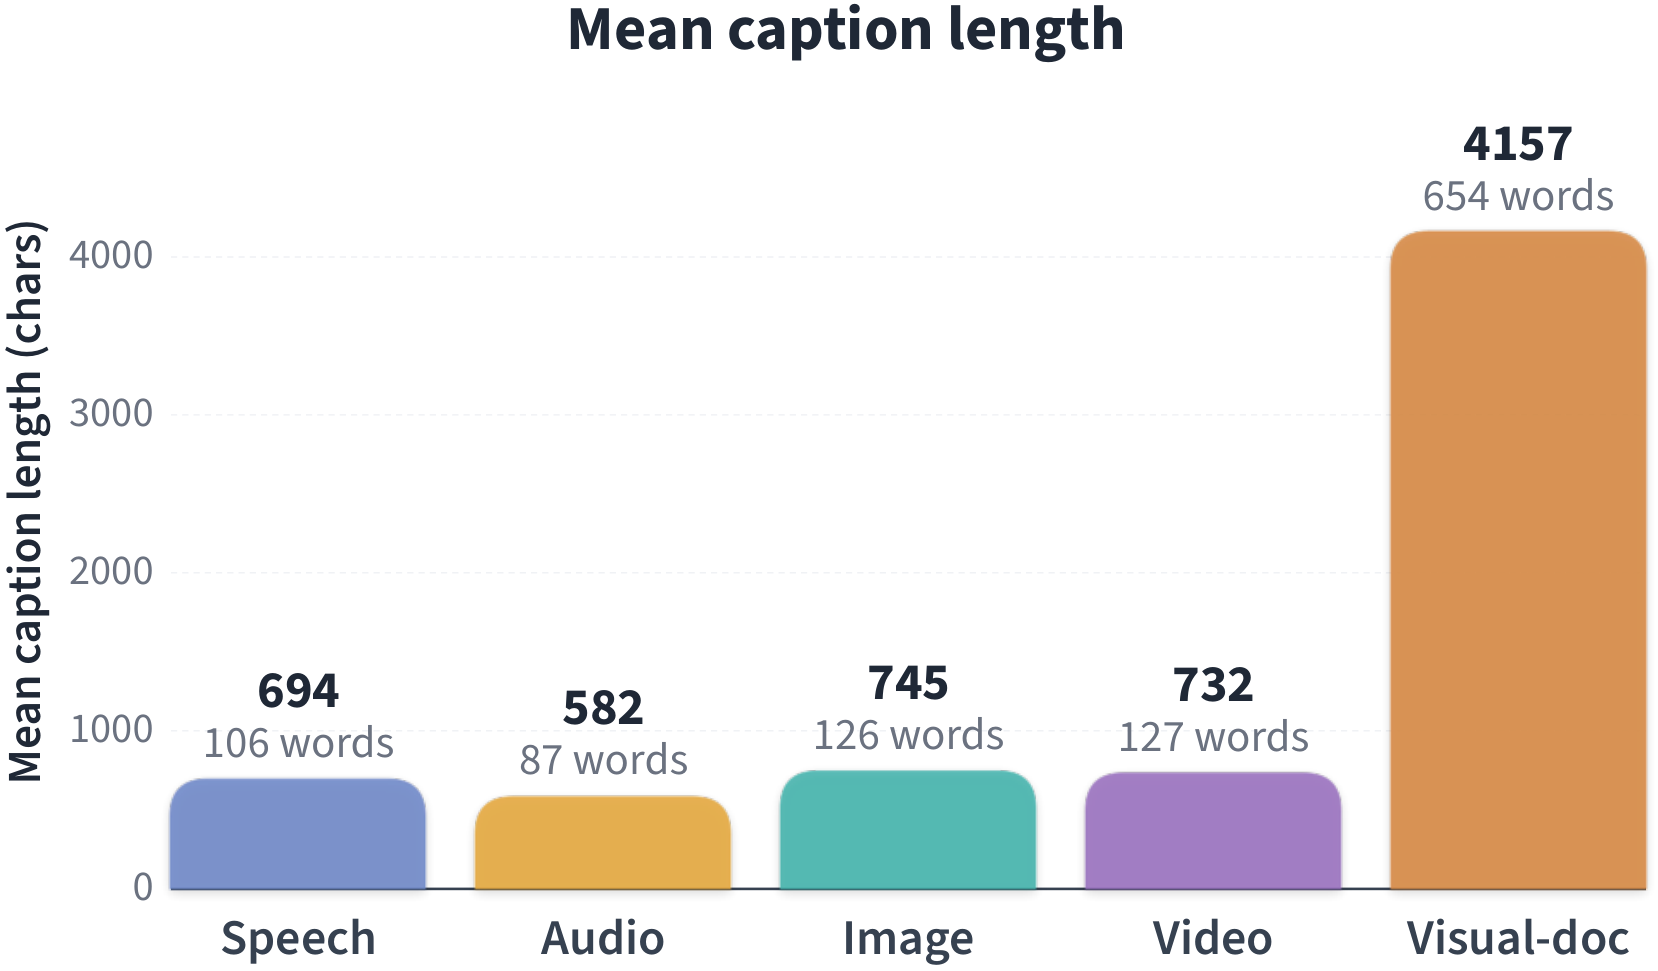
将 text embedding 模型扩展到新模态,通常会损害文本检索质量;已有的全模态嵌入模型往往靠数十亿参数来弥补这一损失。 我们提出 Omni-Embed-Mini,一个 0.9B 参数模型,把文本、语音、音频、图像、视频与富视觉文档映射到同一共享余弦空间,且不更新任何文本侧参数。核心洞见在于:教师信号无需额外的嵌入模型——每个媒体样本配一段密集级联描述,教师目标就是冻结骨干对该描述的自身嵌入。教师与学生共享骨干权重,因而处于逐字节一致的几何空间,轻量 projector 加模态编码器上的分阶段 LoRA 适配器即可完成对齐。 训练结合 Matryoshka SigLIP 对比损失与在线混合难负例挖掘器,负例随编码器提升而不断收紧;换成原生视觉语言骨干后,该配方可直接迁移到 2.3B 变体。 Omni-Embed-Mini-0.9B 的文本权重与骨干逐比特一致,训练不会导致文本检索退化(MTEB-v2 BEIR-8 上 49.57 nDCG@10),同时覆盖另外五种模态,体积比我们对比的所有开源全模态嵌入器小 2.7x–9.5x。2.3B 变体与闭源 gemini-embedding-2 相当,并在全模态平均分上略胜一筹。模型、代码、数据与评测框架见 https://omniembed.cvmbzuai.com
论文精读
TL;DR Omni-Embed-Mini 用 0.9B 参数、冻结文本侧权重的密集级联字幕自蒸馏,将语音、音频、图像、视频和富文本文档对齐到同一余弦空间,文本检索性能不退化,参数量比现有开放全模态模型小 2.7–9.5 倍。
问题
问题背景
当前多模态嵌入检索的核心目标是在一个共享余弦空间中表示文本、语音、图像、视频和富文档。随着检索场景从纯文本扩展到跨媒体,如何在保持文本检索精度的同时接入新模态成为焦点。
现有方法局限
- 传统 多模态联合训练 会更新文本侧权重,导致预训练文本几何发生漂移,使 MTEB 等文本基准明显回退。
- 现有 全模态嵌入器(如多模态大模型)依赖数十亿参数弥补文本退化,推理延迟和显存占用过高,不适合规模化部署。
- 用独立教师模型做对齐时,学生和教师几何不完全一致,需要额外蒸馏损失或投影层对齐,训练复杂且易受噪声影响。
为什么这个问题难/重要
- 模态异质性:文本 token 与声学特征、像素 patch 的分布差异大,对齐需要克服几何不匹配。
- 遗忘问题:多任务学习中的灾难性遗忘在嵌入空间里表现为文本检索质量下降,尤其当文本预训练权重被冻结时,新模态需通过外部适配器对齐,不能反向传播到共享 backbone。
- 业界关注:跨模态检索在 RAG、多模态搜索、内容审核等场景落地,既要求文本性能不降,又要求模型轻量,是工业级部署的关键矛盾。
行业类比
这类似于在不重训搜索引擎倒排索引的前提下,为新接入的视频 / 音频文档建立向量索引,要求新索引与现有文本索引共享同一语义空间,避免召回偏差。
核心洞察
- 冻结文本权重并采用自我蒸馏来绑定新模态,确保文本检索性能完全无遗忘。与以往通过微调文本编码器或依赖十亿级参数容量来补偿质量损失的全模态嵌入模型不同,该方法在 0.9B 参数下文本指标与骨干完全一致,且比所有开放全模态模型小 2.7–9.5 倍,实现了真正的无退化模态扩展。
- 密集级联描述作为跨模态锚点,教师信号来自冻结骨干自身的文本嵌入,使师生共享同一几何空间。相比使用独立大模型教师或构建显式对比对的方案,该方法无需任何额外文本编码器或成对数据,仅靠轻量投影器和 LoRA 适配器即可完成对齐,让 0.9B 小模型有效覆盖五类非文本模态。
方法
输入
多模态样本(文本、语音、音频、图像、视频、富文档)与通过密集级联流程生成的 密集字幕 成对输入。
关键模块
- 冻结文本骨干:保留原始文本嵌入模型(0.9B 参数)的全部权重,文本侧不更新任何参数,从而避免文本检索质量退化。
- 不对称模态对齐:仅训练各模态编码器上轻量投影器和分阶段 LoRA 适配器,文本骨干作为固定锚点,形成非对称训练结构。
- 级联字幕自蒸馏:利用冻结骨干自身对配对的密集字幕计算嵌入作为教师目标,教师与学生共享同一骨干权重,几何空间字节级一致,无需额外教师模型。
- 混合 Matryoshka 对比损失:结合 SigLIP 对比损失与多粒度表示约束,提升不同维度下的对齐鲁棒性。
- 在线混合难负样本挖掘:训练过程中动态筛选更难负样本,随着编码器改进负样本尖锐度逐步提升,增强判别能力。
输出
所有模态映射至统一余弦嵌入空间,支持跨模态检索。文本检索指标(如 MTEB-v2 BEIR-8 nDCG@10 = 49.57)与原始骨干完全一致,模型参数仅 0.9B。
与同类全模态嵌入器相比,本法通过冻结文本骨干与共享权重的自蒸馏,在不引入额外教师模型的前提下实现字节级几何对齐,参数规模缩小约 2.7–9.5 倍。
实验
实验设计
作者采用 英文 only 协议 评估多模态嵌入质量,覆盖四个基准:
- MTEB-v2 的 8 任务 BEIR 文本检索子集
- MAEB 的 22 任务英文子集
- MMEB-V2 的 16 任务英文子集
- ViDoRe-V3 的 7 个英文域
主实验验证 0.9B 模型在冻结文本骨干下,通过轻量投影层与分阶段 LoRA 适配音频 / 视觉编码器,实现跨模态对齐;同时检验 2.3B 变体的可扩展性。
关键发现
- 文本参数 bit-identical,所以 MTEB-v2 BEIR-8 的
nDCG@10保持 49.57,无灾难性遗忘。 - 核心创新 cascaded-caption self-distillation:教师目标就是冻结骨干对 dense caption 的嵌入,教师与学生共享字节级一致的几何结构,因此轻量适配即可绑定五种额外模态。
- 训练使用 Matryoshka SigLIP 对比损失 + 在线混合难负样本挖掘,随编码器改进难负样本质量动态提升。
- 2.3B 变体在 整体模态平均 上略优于闭源
gemini-embedding-2,证明该方法具备参数扩展性。
与基线对比的深度解读
现有 omni embedder 通常依赖 十亿级参数 补偿文本检索退化,而 Omni-Embed-Mini 用 0.9B(小 2.7–9.5×)就实现无回归,对比优势明确。其本质区别在于 冻结文本侧 + 共享骨干几何 + 稠密蒸馏,避免了联合训练中文本表征被平均化的风险。工程启示:可在不触碰现有文本检索服务的前提下,仅添加多模态投影与 LoRA 适配,降低上线风险并保护既有性能 SLA。2.3B 变体与闭源模型的竞争进一步表明,参数效率与多模态覆盖可以兼得。
行业影响
落地场景
Omni-Embed-Mini 以 0.9B 参数统一文本、语音、图像、视频、文档嵌入,适合多模态检索与推荐。典型 use case:
- 电商搜索:用户上传商品图片或语音描述,系统通过同一向量空间返回匹配商品,无需切换多套模型。
- 内容平台:对短视频、音频、文字评论进行跨模态去重、相似推荐或版权监测。
商业价值
- 降本:比同类开源全模态嵌入模型小 2.7 至 9.5 倍,推理显存、延迟大幅降低,可在边缘设备或高并发场景部署。
- 无退化:文本侧权重与骨干位相同,MTEB-v2 BEIR-8 nDCG@10 保持 49.57,扩展模态不会拖累原有文本检索业务。
- 体验提升:统一余弦空间使跨模态结果一致,减少多模型维护和结果融合复杂度。
与现有产品/工作流的接口
输出标准嵌入向量,可直接对接 FAISS、Milvus 等向量库。训练时冻结文本骨干、仅为模态编码器增加 LoRA 与 projector,允许保留已有文本索引,增量部署多模态路径。在线难负样本挖掘适合动态数据流,可周期性微调而无需重建全量索引。
局限
- **冻结文本侧参数的代价**:该方法不更新任何文本侧参数,成功避免了文本检索退化,但也放弃了通过跨模态信号调整文本表示的机会。当某些模态(如语音、音频)与文本的语义空间存在系统性偏移时,仅调整模态编码器与投影器可能无法完全消除对齐误差,可能影响细粒度跨模态检索。论文消融实验显示 unfreezing backbone 会带来某些模态提升但牺牲文本性能,说明该 tradeoff 未根本解决。
- **数据质量依赖**:训练核心是 cascaded dense captions 作为教师目标。模型性能高度依赖自动生成 caption 的准确性、信息密度与覆盖度。对于语音、视频等复杂模态,自动描述容易产生噪声、幻觉或模板化输出,即使有 noise safeguards,开放性场景下的分布外数据仍可能导致对齐失败。此外,生成高质量 dense captions 的管道成本较高,限制了方法快速扩展到新领域或低资源语言。
- **评测与工程部署局限**:评测集中在英文基准,未涉及多语言、低资源模态或实际检索系统的延迟/显存指标。0.9B 模型虽小,但在部分模态(如视频、视觉富文档)可能与数亿参数专用模型或更大 omni 模型仍有差距。论文仅展示 2.3B 变体接近 gemini-embedding-2,未充分讨论 0.9B 与商业模型的实际应用鸿沟,以及推理时多模态编码的额外开销。