在消退之前:在 VideoLLMs 推理阶段强化时间表征
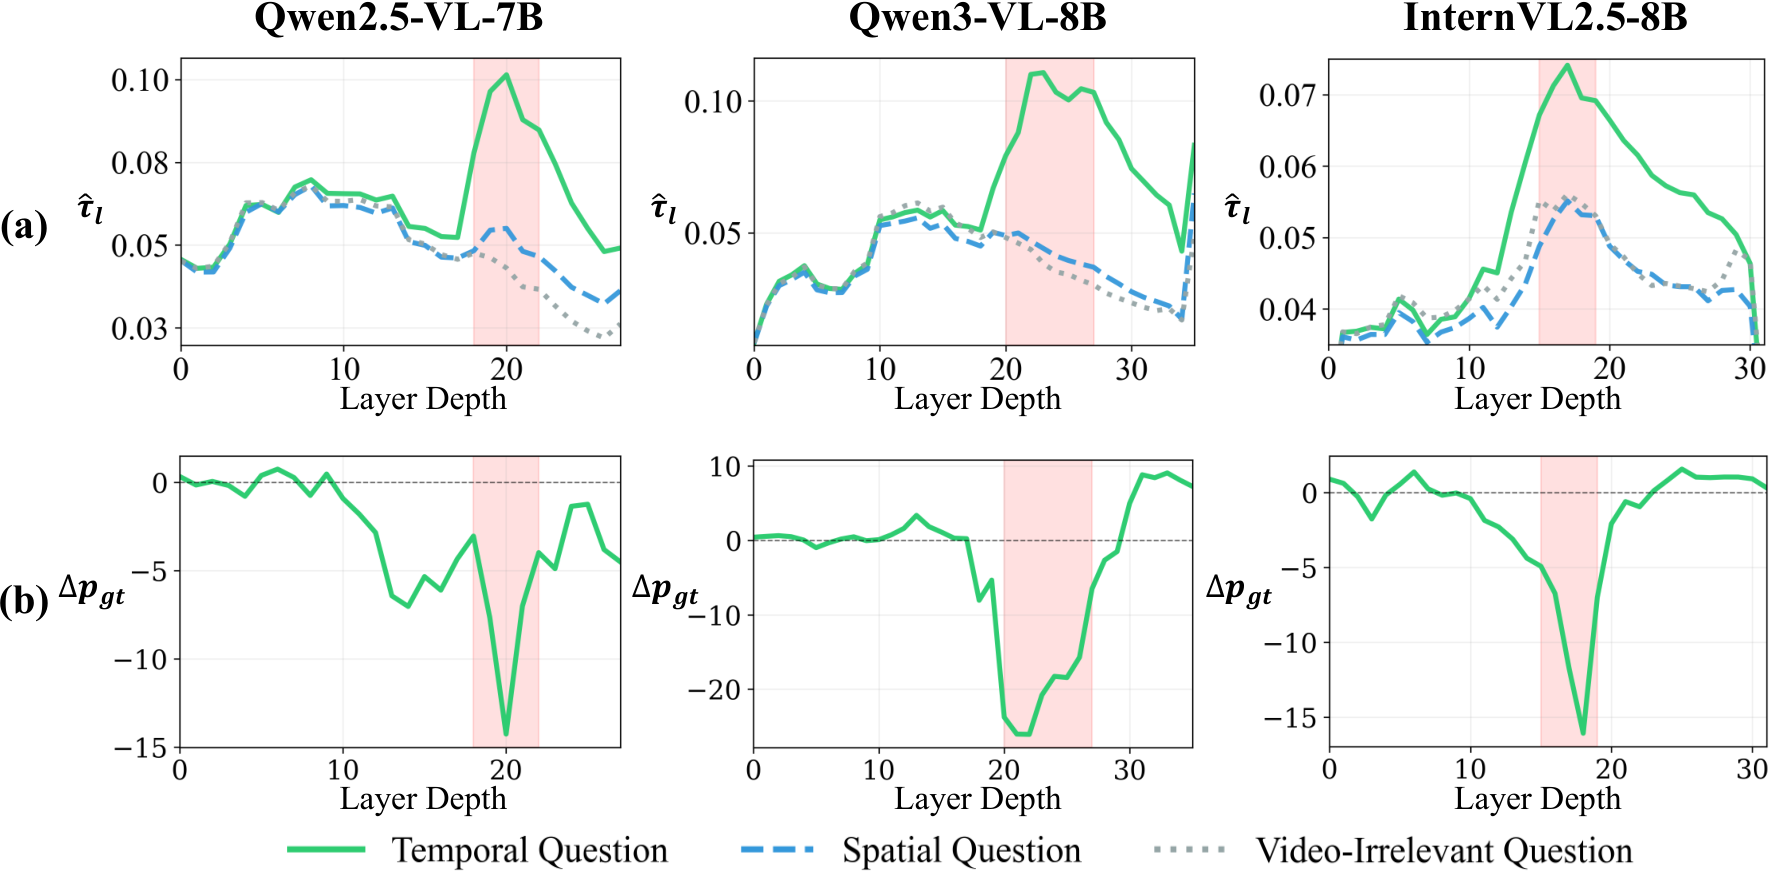
VideoLLMs(视频大语言模型)按顺序接收帧,并解读视觉内容如何沿时间轴演变,但时间推理 始终是各类架构的共同弱点。将视频的帧顺序反转——这一本应颠倒时间答案的变换——往往无法改变最终预测。 为定位这一失败的根源,作者定义了时间发散向量 τl,即由时间顺序反转引起的逐层表征差异。追踪其幅度可发现一致的时间发散曲线:发散在中间层达到峰值,并在接近输出层时逐渐减弱。研究确认该峰值是时间推理特有的,且对预测在功能上至关重要,说明 VideoLLMs 在中间层获得了时间信息,却未能将其保持到输出端。 这种逐步消退的现象催生了 Temporal Activation Injection (TAI) 方法:它为每个输入提取曲线峰值处的 τl,并按照测得的衰减将其重新注入后续层。 TAI 无需训练,在三个 VideoLLMs 和四个基准上持续提升时间推理能力,对非时间任务的影响可忽略不计。代码已开源于 https://github.com/Youngwoo-git/Before-It-Fades。
论文精读
TL;DR VideoLLMs 的时间表征在中间层达到峰值后逐渐衰减,导致时间推理弱。本文提出无需训练的 TAI,在推理时从峰值层提取时间发散向量并重新注入后续层,显著提升时间推理性能。
问题
问题背景
视频大语言模型 (VideoLLMs) 需要准确理解视频帧的时序演化,时序推理是其区别于静态图像理解的核心能力,直接影响动作顺序、因果推断等任务。
现有方法局限
当前主流 VideoLLMs 在处理时序信息时存在系统性问题:将视频帧顺序反转后,模型预测常常保持不变,说明时序信号未能有效驱动最终输出。现有推理时模型操控 (inference-time model steering) 方法多依赖特定任务的激活方向设计,缺乏对时序信息在层间传递规律的精确刻画;部分方法需要额外训练或数据,部署灵活性不足,且可能干扰非时序任务性能。
为什么这个问题难/重要
论文通过定义层间时序散度向量 τ_l,发现时序信息在中间层达到峰值后向输出层逐渐衰减,即模型在中间层“学到”了时序但未能保持到预测端。这种衰减是结构性的,且与时序推理特异性相关,定位并逆转这一衰减需要逐层诊断而非简单全局干预。时序推理是视频理解走向真实应用的关键瓶颈,业界对视频问答、事件定位等任务的鲁棒性诉求持续增强,因此无需训练的推理时修复方案具有较高的工程价值。
行业类比
类似于长上下文 LLM 中位置信息在深层被稀释导致顺序不敏感,需在推理阶段显式强化关键时序信号以保证序列建模一致性。
核心洞察
- VideoLLMs 并非无法编码时序信息,而是在前向传播中无法将中间层获得的时间信号保持到输出层。论文通过定义层间时间差异向量 τ_l,发现其幅值在中间层达到峰值后单调衰减,且该峰值对时序推理具有因果重要性。这一诊断视角与以往侧重输入侧改进(如帧采样、位置编码)的工作根本不同,把问题定位在表示传播阶段,为推理时修复提供了明确靶点。
- TAI 的核心创新是利用每个输入样本自身的 τ_l 峰值向量进行逐层重注入,而不是使用全局固定的激活方向。这种 input-dependent 的操控能适配具体视频的时间变化幅度与模式,无需任何训练,即可在三个 VideoLLM 和四个基准上稳定提升时序推理,同时对非时序任务影响极小。相比现有推理时 steering 方法多采用固定方向或线性探针,TAI 的信号来源与衰减补偿策略更具物理可解释性和鲁棒性。
方法
方法详解
输入:一段视频的帧序列(原始顺序)以及该视频的逆序帧序列(时间反转)。
关键模块:
- 计算层间时序散度向量 τ_l:对于模型中每一层 l,分别将原始顺序和逆序帧序列输入 VideoLLM,提取该层 last token 的隐藏表示,两者相减得到时序散度向量 τ_l。
- 确定峰值层 L_src:观察各层 τ_l 的 L2 范数变化曲线,发现中间层达到峰值,随后向输出层衰减直至接近消失。将峰值所在层记为 L_src。
- 时序激活注入:对每一个新输入视频,额外做一次逆序前向传播,得到 L_src 处的 τ_{L_src}。然后按照预先测得的时间衰减曲线,将 τ_{L_src} 乘以相应系数后加到 L_src 之后各层的隐藏状态上,相当于“回填”逐渐消退的时序信息。
输出:经过注入后的最终 logits,用于生成时间相关的答案。整个过程无需训练,仅增加一次逆序前向传播。
与同类方法差异:相比现有推理时激活操控方法通常使用固定方向向量(如从训练集统计得到),TAI 采用输入特定的 τ 且注入强度依据实测衰减曲线逐层调整,针对性强且零训练成本。
实验
实验设计
作者在 三个 VideoLLMs 上评估 Temporal Activation Injection (TAI),覆盖 四个时序推理基准。核心思路是先为每个输入计算 temporal divergence vector τ_l 的峰值层 L_src,提取该层的 τ_l 并按照后续层的测量衰减幅度重新注入,以强化时间信号。
关键发现
实验结果表明,TAI 无需训练即可一致提升时序推理能力,且对非时序任务影响可忽略。这验证了论文的核心假设:VideoLLMs 在中间层获得时序信息但未能保持到输出层,通过推理时注入可有效弥补这一缺陷。
与基线对比
与标准推理相比,TAI 在多个模型和基准上表现出稳定增益。其优势源于精确定位时序信号最丰富的层并在下游层进行补偿,而非盲目施加通用扰动。该方法属于推理时模型操控范畴,与现有激活操控工作相比,避免了额外训练开销,并针对性解决时序信息衰减问题。
行业影响
落地场景
TAI(Temporal Activation Injection)主要适用于依赖视频时序推理的产品,例如:
- 电商视频商品描述:用户上传商品展示视频,系统需回答“先展示外观还是先展示功能?”等时间相关问题。注入 TAI 后,VideoLLM 能更准确地捕捉动作顺序,减少错误推荐。
- 内容平台视频审核:判断视频中是否存在“先违规后正常”或“先正常后违规”的时序模式。TAI 可提升对时序违规的识别率,无需重新训练审核模型。
商业价值
- 降低成本:TAI 不需要任何训练或微调,直接插入现有 VideoLLM 推理流程,省去数据标注和 GPU 训练开销。
- 提升体验:在视频问答、视频摘要等任务中,时间推理准确率提升意味着更可靠的服务,减少人工复核成本。
- 风险控制:对于金融监控、安全巡检等场景,时序错误可能导致错误报警或漏报,TAI 增强时间一致性可降低业务风险。
与现有产品/工作流的接口
TAI 是一种推理时激活操控方法,可封装为轻量级插件:
- 离线阶段:在目标 VideoLLM 上,用少量反转帧序样本估计各层时间发散向量
τ_l,确定峰值层L_src。 - 在线推理:对输入视频提取
L_src层的τ,按预设衰减因子注入后续层,完成前向计算。
该接口兼容主流推理框架(如 vLLM、Hugging Face Transformers),只需暴露中间层激活即可。额外计算开销可控,对非时间任务影响几乎可忽略,适合在现有 MLOps 流程中作为可选增强模块部署。
局限
- **方法泛化性有限**:TAI 依赖反向帧顺序构造时序发散向量 `τ_l`,但反转操作并不总能代表所有时序推理场景(如细粒度动作顺序、非对称因果链)。论文在三个 VideoLLM 和四个时序基准上验证有效,但缺乏长视频、多轮对话、生成式视频问答等更复杂任务的覆盖。此外,TAI 需要额外计算 `L_src` 层输出以提取并注入 `τ_l`,推理成本上升;其衰减轮廓估计也基于特定数据集和模型,迁移到新分布时可能需要重新校准,限制了零样本部署的鲁棒性。
- **对超参数和注入位置的敏感性**:TAI 的效果依赖于几个关键设计:源层 `L_src` 的选择、注入层范围以及缩放因子(基于测量的衰减函数)。论文虽做了消融,但未充分证明这些设置在不同模型深度或架构家族(如仅自回归解码器 vs 编码器-解码器)上的稳定性。实际应用中,工程师仍需针对目标模型和任务进行额外调参,否则可能引入噪声或对非时序任务造成干扰。与端到端微调相比,TAI 更像一种经验性补丁,缺少自动适应输入复杂度的机制。
- **缺乏对根本问题的修复及理论解释**:作者清楚指出了时序表征中间层峰值后衰减的现象,但没有深入分析模型为何无法在后续层保持该信号,也没有探讨利用训练或结构改进根治该问题的可能路径。TAI 作为一种 inference-time 注入,虽无需训练且能提升指标,但并未改变模型底层的表示学习缺陷,无法从根本上增强时序推理能力。同时,论文未与近期 activation steering 或 inference-time intervention 方法(如 ITI, TruthX)进行系统对比,在一定程度上削弱了方法相对价值的说服力。