近乎免费地更好地解码 Looped Transformers
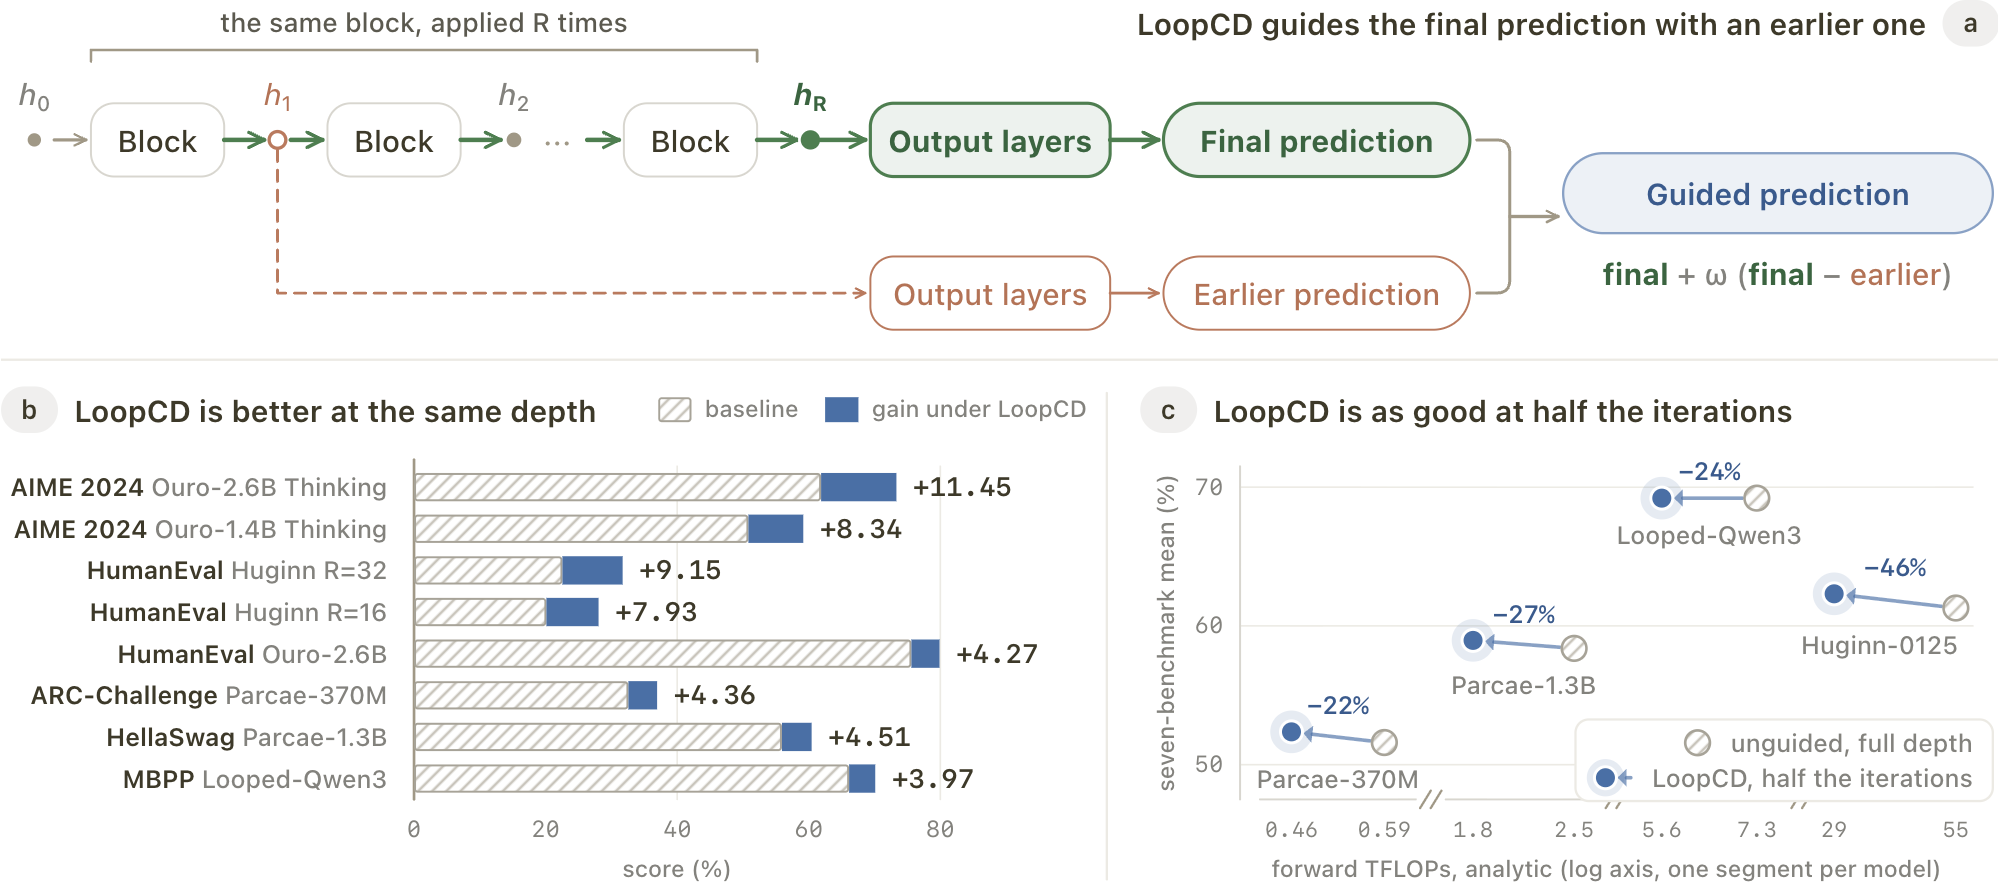
Looped Transformers 通过反复执行共享 block 实现参数效率。每次循环都会产生可解码同一 next token 的中间表示,但标准解码会丢弃较早的状态。由于早期循环蕴含的计算更少,循环本身天然提供了对齐的弱-强预测对,无需辅助模型或额外训练。 为此,作者提出 LoopCD——一种免训练的对比解码框架,通过将最终预测与较早的循环输出进行对比来引导 token 选择。它有两种工作模式:在 logit 空间运行、仅需一次额外输出前向的 LoopCD-Logits,以及在 hidden-state 空间运行、零输出开销的 LoopCD-Hidden。 在四个 looped Transformer 家族上,该方法于完整循环深度下均取得显著且一致的提升:LoopCD-Logits 将 Ouro-2.6B-Thinking 的 AIME 2024 pass@1 从 61.88% 提升至 73.33%;LoopCD-Hidden 将 Huginn 的 HumanEval pass@1 从 22.56% 提升至 31.71%。 更关键的是,这些增益使得循环次数减半后仍能追平或超越全深度无引导基线,forward FLOPs 降低 22.5% 至 48.2%。通过把中间循环状态转化为有效的引导信号,LoopCD 在显著降低推理算力的同时实现了更优的解码质量。
论文精读
TL;DR LoopCD 利用循环 Transformer 固有的弱/强预测对,无需训练即可对比解码,显著提升数学与代码推理性能,并能减半循环次数降低 22.5%–48.2% FLOPs。
问题
问题背景
循环 Transformer(Looped Transformers)通过共享同一模块在多个循环中反复执行,以参数效率换取深度计算。每个循环产生一个可解码的中间表示,但标准解码只使用最终循环的输出,丢弃了早期状态。
现有方法局限
- 对比解码(Contrastive Decoding) 通常需要一个弱模型(如更小或未充分训练的模型)来提供负向信号,这需要额外的模型加载、内存占用与推理开销,难以即插即用。
- 循环模型天然具备“弱预测—强预测”对:早期循环计算量少,预测较弱;最终循环计算充分,预测较强。但现有方法没有利用这一内部对齐信号,造成信息浪费。
- 一些训练-free 解码策略(如 early exit、layer 加权)要么需要额外训练门控,要么在减少循环时显著降低生成质量,缺乏针对循环架构的系统化对比机制。
为什么这个问题难且重要
循环模型在推理时每生成一个 token 都需要多次前向循环,计算成本线性增长。减少循环次数通常直接导致性能下降,而保持全深度又面临高 FLOPs。如何在不引入辅助模型或额外训练的前提下,把中间状态转化为有效的解码指导,同时实现“降循环、不降质”甚至“提质”,是一个兼具理论价值与工程紧迫性的问题。
业界对推理效率与生成质量的平衡高度关注:任何能削减 20%–50% 前向 FLOPs 且不掉点的方案,都能直接降低在线服务成本并提升吞吐。
行业类比
类似推理加速中的 speculative decoding(草稿模型验证),但 LoopCD 不需要额外的草稿模型——它利用循环模型自身在不同深度上的计算冗余,实现一种“自对比”的解码校正。
核心洞察
- - LoopCD 的核心洞察:Looped Transformer 的每一轮前向都会产出一个可解码中间表示,这些中间状态天然构成弱/强预测对,无需任何外部教师模型或额外训练。这与标准对比解码依赖独立小模型或人为扰动不同,弱参考与最终预测共享全部参数和输入,对齐性更强、减法更稳定,把递归本身变成免费的自对比信号。
- - LoopCD-Hidden 在隐状态空间直接做对比,完全跳过额外输出投影,实现零额外输出开销;而 LoopCD-Logits 只需多跑一次输出层。两者都让对比解码的推理成本几乎可忽略,进一步使减半循环次数成为可能:相比全深度无引导基线,前向 FLOPs 降低 22.5%–48.2%,同时保持或超越原性能。
- - 这一方法将中间递归状态从被丢弃的计算副产物转化为可用的弱参考信号,为循环深度提供了一个新的质量-算力权衡旋钮。实验显示 LoopCD-Logits 把 Ouro-2.6B-Thinking 的 AIME 2024 pass@1 从 61.88% 提升到 73.33%,LoopCD-Hidden 把 Huginn 的 HumanEval pass@1 从 22.56% 提到 31.71%,同时还能用更少循环达到同等效果。
方法
输入与核心思路
Looped Transformer 通过重复执行共享参数块产生一系列中间表征,每个循环步的表征均可解码为下一 token 预测。LoopCD 的输入是一组循环迭代的隐藏状态:选择一个较早的迭代作为弱预测参考,使用最终迭代作为强预测。早期迭代计算量少、预测置信度低,天然形成“弱-强”配对,无需外部弱模型或额外训练。
关键模块:两种对比空间
- LoopCD-Logits:对参考迭代和最终迭代分别执行输出投影,得到两组 logits,然后计算对比修正项。需要额外一次输出投影,开销与单层输出层相当。
- LoopCD-Hidden:直接在隐藏状态空间计算对比,将最终隐藏状态沿与参考状态差异的方向调整,再经一次输出投影。输出投影次数与原始解码相同,几乎零额外 FLOPs。
原文强调:LoopCD 是 training-free 的,不需要辅助模型、外部训练或额外数据集。
输出与解码
对比后的修正分布用于 next token 采样。实验表明,在数学推理和代码生成任务上,LoopCD 能稳定提升 pass@1,且能在降低循环深度(减少 22.5%–48.2% FLOPs)后仍匹配或超越全深度基线。
与同类方法差异
不同于经典 contrastive decoding 依赖独立弱模型或人工扰动,LoopCD 将递归过程中自然产生的中间状态视为弱预测来源,实现零训练、极低开销的对比解码。
实验
实验设计
论文在四类 looped Transformer 家族上验证 LoopCD,覆盖数学推理(AIME 2024、GSM8K)、代码生成(HumanEval)与通用知识(MMLU-Pro)。对比标准解码,LoopCD 利用最终循环与早期循环的表示做对比,分为 logits 空间(额外一次输出)与 hidden 空间(零额外输出开销)。同时评估半循环深度下的性能恢复与 FLOPs 节省。
关键发现
- AIME 2024 上 LoopCD-Logits 将 Ouro-2.6B-Thinking 的 pass@1 从 61.88% 提升至 73.33%。
- HumanEval 上 LoopCD-Hidden 将 Huginn 的 pass@1 从 22.56% 提升至 31.71%。
- 增益跨架构与评测集一致;循环数减半后仍能匹配或超过全深度无引导基线,前向 FLOPs 降低 22.5%–48.2%。
与基线对比解读
LoopCD 不依赖额外模型或外部训练,利用 recurrence 天然产生的弱-强对齐预测对。相比传统 contrastive decoding 无需辅模型;相比 self-consistency 无需多次采样,单条轨迹即可产出对比信号。其 hidden 空间版本零额外输出开销,使高性能解码接近免费。但增益集中在不确定决策上,过度增强会导致生成崩溃,需调 α 强度。
行业影响
落地场景
循环 Transformer(如 Ouro-2.6B-Thinking / Huginn)常被用于轻量级数学推理、代码生成等 API 服务。LoopCD 可作为即插即用的解码增强,直接提升 pass@1 准确率。典型 use case:在线教育平台的数学解题辅助,回答正确率从 61.88% 提升至 73.33%,并允许将循环层数减半,单次推理 FLOPs 减少 48.2%,显著降低 GPU 成本。企业级代码助手(如代码补全 / 生成)同样适用,Huginn 的 HumanEval pass@1 从 22.56% 提至 31.71%,可减少重试和 token 消耗。
商业价值
主要价值在 降本 与 体验提升 双线:FLOPs 减少 22.5%–48.2% 直接降低单次调用成本;pass@1 提升意味着用户获得正确结果的等待时间缩短、失败重试减少,提升产品可用性和客户留存。LoopCD 无需额外训练或蒸馏,训练成本为零,部署风险低。
与现有产品 / 工作流的接口
LoopCD 作为训练免费的对比解码策略,可在现有推理框架(如 vLLM、TensorRT-LLM)中作为自定义采样器实现。需要从循环块中保存一个较早的隐状态或 logits 副本,然后在最终 logits 上做对比(LoopCD-Logits)或直接在隐状态空间调整(LoopCD-Hidden)。推荐先以 Logits 模式验证,再切换 Hidden 模式以省去额外输出头的计算。强度超参数 α 需按任务微调,可提供作为 API 的可配置项。
局限
- 验证范围主要限于数学推理与代码生成任务(AIME 2024、HumanEval 等),对通用自然语言处理任务(如开放域问答、摘要、对话)效果未知;且仅在四个 looped Transformer 家族上测试,未覆盖更广泛的架构变体,结论的泛化性有待进一步验证。
- 方法需要选择参考迭代和调节 guidance strength,这两者对性能影响较大但缺乏自动化或自适应机制,不同模型和任务可能需要手动调参;对比解码本身也可能放大某些偏差(如重复生成或过度自信),论文未系统讨论这一副作用。
- LoopCD-Logits 需要一次额外的输出层前向传播,虽相对整体推理开销较小但并非完全免费;LoopCD-Hidden 虽然零输出开销,但需要缓存中间隐藏状态,可能增加内存占用,且其性能提升幅度在部分任务上低于 Logits 变体。