Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens
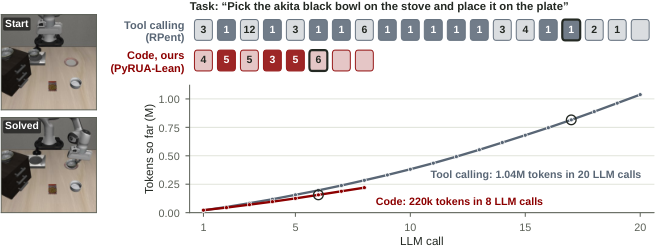
Vision language model (VLM) agents can control robots through visual feedback and action primitives, but repeated model invocations and redundant observations incur substantial token overhead. We introduce PyRUA-Lean, an interactive code-execution framework that couples feedback-driven primitive composition with selective observation: the agent composes classical robot primitives and learned vision-language-action (VLA) policies into Python cells that perform conditional checks and local retries, returning only explicitly requested images and state feedback for replanning. Across 700 simulated task instances from LIBERO-PRO, RoboTwin 2.0, and RoboCasa365, we compare PyRUA-Lean with a tool-calling baseline using the same GPT-6 Astra planner and underlying robot primitives. Under equal LLM-call budgets, PyRUA-Lean increases overall success from 63.1% to 71.7%. On instances solved by both agents, it uses 49% fewer LLM calls and 65% fewer input tokens.
论文精读
TL;DR PyRUA-Lean 让 VLM 机器人智能体以代码方式组合原语并选择性请求观察,在相同 LLM 调用预算下将成功率从 63.1% 提升至 71.7%,且输入 token 减少 65%。
问题
问题背景
VLM 开始用于机器人操控,通过视觉反馈和动作原语组合完成任务,但推理 token 开销成为部署瓶颈。
现有方法局限
现有 tool-calling 范式下,每次工具调用依赖前一步结果时都需要重新调用 VLM,导致 LLM 调用次数线性增长。同时,中间结果(尤其是多摄像头图像)会不断累积在对话上下文中,后续每次调用都要重复处理这些冗余信息。例如 RPent 系统在每步运动后自动返回多张摄像头图像,即使规划器并不需要这些视觉细节,造成严重的 token 浪费。在需要反复定位、运动与恢复的长程任务中,token 开销可能超过实际决策所需的信息量,极大限制可扩展性。
为什么这个问题难/重要
核心难点在于信息充分性与推理成本之间的冲突:机器人操控需要丰富的视觉反馈来保证可靠性,但原始图像 token 成本高昂;若刻意减少反馈则可能牺牲成功率。业界的关注点正从“能否完成”转向“以什么成本完成”,推理效率直接影响实际部署的可行性。此外,代码执行框架虽然可以在单次 VLM 调用内完成条件判断和局部重试,但需要设计合理的原语组合机制与选择性观察策略,否则容易出现错误累积或上下文缺失。
行业类比
类似 LLM-based web agent 中通过按需返回页面快照而非完整 HTML 来降低上下文长度,PyRUA-Lean 在机器人操控领域引入了选择性观察优化。
核心洞察
- PyRUA-Lean 的核心创新在于用可执行 Python 代码替代传统的逐次工具调用,将原语组合、条件检查和局部重试封装在单个单元格中。与工具调用 baseline 不同,后者每个依赖前一步结果的操作都需要再次调用 LLM,且中间结果不断累积;PyRUA-Lean 让代理编写包含循环和条件分支的代码,在本地执行多次尝试,仅在需要重新规划时才返回结果,从而将 LLM 调用次数降低 49%。这种接口设计将规划的控制粒度从“每次操作”提升到“每段流程”,大幅减少交互开销。
- 选择性观察机制是 PyRUA-Lean 降低 token 消耗的另一关键,它打破了“每次执行后自动返回多摄像头图像”的惯例。同类系统如 RPent 会在每个运动原语步骤后自动返回多个摄像头图像,导致视觉 token 冗余。PyRUA-Lean 要求代理显式请求所需图像和状态,仅返回这些信息,输入 token 减少 65%。这证明冗余观察是 VLM 机器人推理成本的主要来源之一,且可以通过接口层精细控制来消除,对实际工程部署的延迟和成本优化具有直接参考价值。
方法
输入与执行模型
PyRUA-Lean 以 VLM planner (GPT-6 Astra) 为决策核心,输入为任务描述、以及按需获取的 机器人状态 和 视觉图像。与 tool-calling 接口不同,VLM 不再逐原语调用工具,而是生成一段可执行的 Python 代码 cell,cell 内部组织控制流。
关键模块
- 反馈驱动的原语组合:代码 cell 将 classical robot primitives (如 motion、grasping) 与 learned VLA policies 组合,并嵌入条件判断(
if-else)和局部重试循环。例如:先调用 VLA 定位物体,若置信度低则重试或调用传统检测原语。这些步骤在单次 LLM 调用生成的代码内完成,减少返回 VLM 的频率。 - 选择性观察:执行过程中,agent 仅显式请求所需的传感器反馈(指定摄像头、特定状态字段),不自动回传所有中间结果。这样上下文只保留高价值信息,避免 token 膨胀。
输出与后续循环
代码 cell 执行完毕后,返回 明确请求的图像与状态反馈 (如最终抓取结果、关键帧),VLM 据此决定是否重新规划或结束任务。在 700 个仿真任务中,该方法在同等 LLM-call 预算下将成功率从 63.1% 提升至 71.7%,并且在双方都成功的实例上,LLM 调用次数减少 49%,输入 token 减少 65%。
与同类方法差异:tool-calling baseline 每个依赖前序结果的操作都需额外 VLM 调用,且中间结果自动累积;PyRUA-Lean 将多步原语逻辑封装在代码 cell 内并采用选择性观察,从执行架构上减少了推理开销。
实验
实验设计
- 数据集:LIBERO-PRO、RoboTwin 2.0、RoboCasa365,共 700 个模拟任务实例。
- 对比:PyRUA-Lean(代码执行框架) vs tool-calling baseline,两者使用相同 GPT-6 Astra planner 和底层机器人 primitives。
- 评估:相同 LLM 调用预算下的成功率;以及两者都成功任务上的 LLM 调用数和输入 token 数。
关键发现
- 成功率:PyRUA-Lean 总体成功率 71.7%,基线 63.1%,提升 +8.6 pp。
- 调用效率:在共同解决的任务上,PyRUA-Lean 减少 49% LLM calls 和 65% input tokens。
- 机制:通过 feedback-driven primitive composition 和 selective observation,将条件检查和本地重试封装在 Python cells,仅返回显式请求的观察。
与基线对比解读
Tool-calling 需要为每个依赖前一步结果的操作重新调用 VLM,且中间结果不断累积;PyRUA-Lean 的代码执行允许单 cell 内完成控制流和重试,显著降低推理开销。这为机器人 agent 工程提供了降低 token 成本、保持成功率的可行路径。
行业影响
落地场景
机器人操作与具身智能:PyRUA-Lean 适用于需要 VLM 进行视觉推理和动作规划的机械臂、服务机器人、仓储物流机器人等。通过将经典原语和 VLA 策略组合为可执行 Python 代码单元,并在单元内完成条件判断和局部重试,仅返回显式请求的图像和状态,适合频繁定位、抓取、恢复等任务。
交互式机器人系统:减少 token 消耗可降低端到端延迟,使远程操作、人机协作等实时性要求高的场景更可行。
商业价值
- 降本:在相同 LLM 调用预算下,输入 token 减少 65%,直接降低模型 API 费用;LLM 调用次数减少 49%,进一步降低推理成本与延迟。
- 增效:任务成功率从 63.1% 提升至 71.7%,减少人工干预,提高自动化产线或服务机器人的运行效率。
- 体验提升:更快的反馈和决策速度,改善用户与机器人的交互体验。
与现有产品/工作流接口
PyRUA-Lean 可作为中间层替换现有 VLM agent 的工具调用模块。在 LangChain、AutoGen 等 agent 框架中,规划器通常通过 tool-calling 生成 JSON 调用原语,PyRUA-Lean 提供 Python 代码执行环境,上层规划器无需改动,只需将原语封装为可调用函数。同时,该方法支持将现有 VLA 策略(如 RT-2、Octo)作为原语嵌入代码单元,通过 if 语句和局部循环控制调用时机和反馈数据量。开源实现基于 Python,可快速集成到 ROS 2 或其他机器人中间件。
具体 use case
- 电商仓储拣选:在 fulfillment center 中,机械臂根据视觉识别商品并执行抓取。使用 PyRUA-Lean,每次操作仅返回关键图像和状态,使 GPT-6 Astra 规划器在相同 token 预算下能执行更多步骤,拣选成功率和吞吐量提升。
- 医疗辅助机器人:手术或护理机器人需要精确操作和实时反馈,减少 token 可显著降低推理延迟,提高安全性和响应速度。
局限
- **模拟与真实差距**:论文在 LIBERO-PRO、RoboTwin 2.0、RoboCasa365 三个模拟基准上验证,未在真实机器人上部署。真实场景存在传感器噪声、执行器误差、遮挡与光照变化,代码执行框架还可能带来安全风险(如错误调用 primitive 导致碰撞)。选择性观察策略减少了视觉冗余,但在真实环境中可能忽略关键细节,导致更严重的失败。需要在真实机器人上做系统评估才能验证其鲁棒性。
- **泛化性依赖底层组件**:PyRUA-Lean 的性能高度依赖底层 primitive 的可靠性、API 的设计完备性以及 GPT-6 Astra 的代码生成质量。实验仅使用单一大模型,未测试其他 VLM(如 GPT-4o、Gemini、开源模型等)。当 primitive 粒度不匹配或代码生成出错时,agent 可能难以恢复。此外,选择性观察减少了视觉反馈,可能丢失长程任务所需的上下文信息,尤其在需要跨步骤推理或细粒度操作时表现不稳定,限制了其在复杂任务上的扩展性。
- **对比基线与评估范围有限**:论文仅与自身 tool-calling 基线比较,未对比现有代码执行 agent 或端到端 VLA 方法。虽然 token 减少显著,但成功率提升幅度中等,任务类型集中于桌面操纵、家庭等有限场景。此外,论文没有报告失败案例中 token 节省是否以牺牲鲁棒性为代价,也未详细分析代码执行环境本身的开销与延迟对端到端系统的影响,这削弱了结论的全面性。