关键词测试框架 Fail Open:小语言模型工具使用声明的廉价诊断阶梯
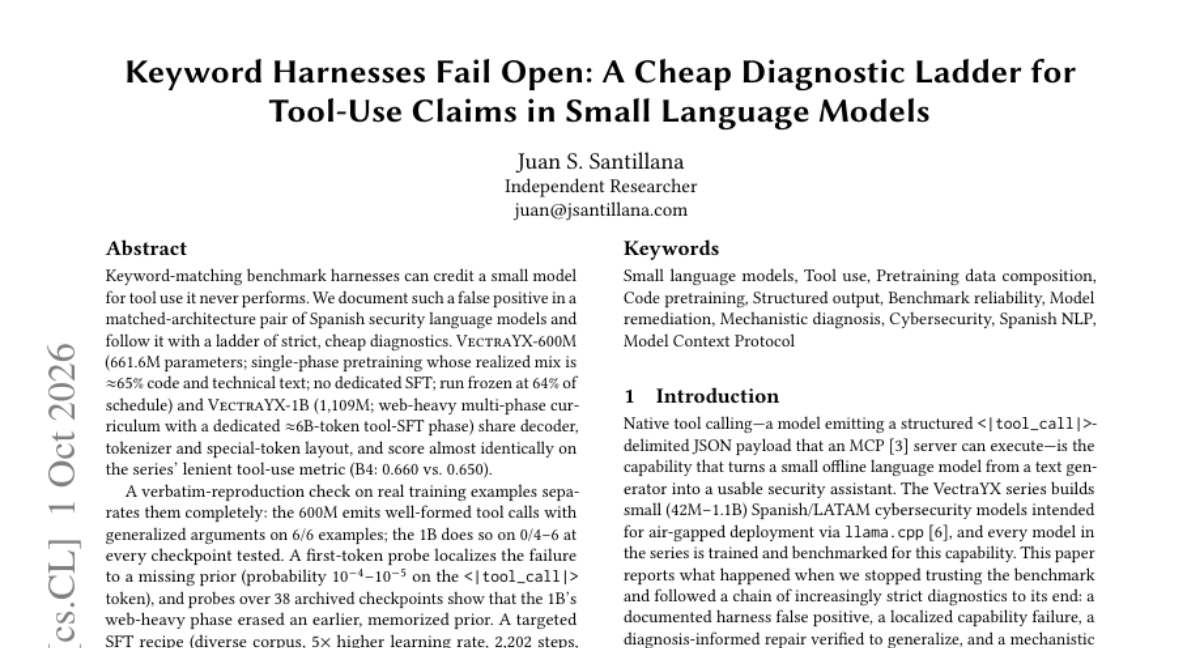
关键词匹配 基准会把小模型从未真正执行的工具调用算作成功。我们在一对同架构的西班牙语安全语言模型上记录了这样一个 false positive,并提出一套严格且廉价的诊断阶梯。 - 661.6M 模型(约 65% 代码/技术文本,无专属 SFT)与 1,109M 模型(网页为主的多阶段课程 + 6B-token 工具 SFT)共享 decoder、tokenizer 与 special token,在宽松工具使用指标上几乎同分(B4: 0.660 vs. 0.650)。 - 训练样本的逐字复现检查 将二者彻底分开:600M 在 6/6 样本上给出带泛化参数的有效 tool call,1B 在所有 checkpoint 上均为 0/6。 - 首 token 探针 将 1B 的失败定位到缺失先验(<|toolcall| 上仅 10^{-4}--10^{-5}),该先验被其网页为主的训练阶段抹除。 定向 SFT 配方(多样化语料、5 倍学习率、2,202 步、约 3.3 GPU 小时)以少三个数量级的 token 完成修复:269 条语料行上有效输出 0.100 → 0.959(600M: 0.926);238 条未见 prompt 上为 0.536 vs. 0.428(p = 0.004)。Embedding 漂移检查 显示触发 token 的 tied embedding 未移动(bf16 表 97.7% 逐位相同),变化发生在周边网络。 两个模型都过度触发,很少对否定 prompt 不作调用(0.09 / 0.17);因子分析确认所有修复配置都能装上该格式,但多样化语料的抑制收益仍属假设(种子敏感)。该诊断阶梯仅需几分钟 CPU,应成为小模型工具使用声明的准入关卡。
论文精读
TL;DR 该论文揭露小型语言模型工具使用评测中关键词匹配的虚假高分,提出一套廉价诊断阶梯(逐字复制检查与首 token 探针)严格验证真实工具调用能力,并给出高效修复方案。
问题
问题背景
小型语言模型(SLM)在工具调用 (tool calling) 领域的评估常依赖于关键词匹配基准 (keyword-matching benchmarks),这类基准仅检查输出中是否出现 <|tool_call|> 等特殊 token 或 JSON 格式片段,用于快速筛选声称具备工具使用能力的模型。
现有方法局限
- 关键词匹配存在系统性假阳性:模型只要生成看似工具调用的格式,即使没有正确参数、没有实际调用语义,甚至对负面提示也触发调用,也会获得高分。
- 文中匹配架构的 600M 与 1B 模型在宽松指标 BLEU-4 上几乎相同(0.660 vs. 0.650),但逐字复现检查显示 600M 在 6/6 训练样例上生成有效工具调用并泛化参数,1B 在 0/6 上失败,说明宽松指标掩盖了能力差异。
- 这类基准无法检测先验缺失:1B 模型在 web-heavy 预训练阶段把
<|tool_call|>token 的先验概率擦除至 (10^{-4})—(10^{-5}),即使经过 6B token 的工具 SFT 也难以恢复。
为什么这个问题难/重要
小型模型容量有限,预训练数据混合与课程设计对工具调用先验影响极大,且修复成本高:错误的工具 SFT 可能完全没有效果,浪费数 GPU 小时的训练资源,而问题在部署后才暴露。业界需要廉价、严格、可定位的诊断方法(如首 token 概率探针、嵌入漂移检查),在训练早期就识别出“只有格式没有能力”的模型。
行业类比
类似自动驾驶系统中,仅凭车辆是否输出“刹车指令”关键字就判定安全,而不检查制动执行与泛化能力——看似有反应,实则不可靠。
核心洞察
- 工具调用能力的评估不能依赖宽松的关键词匹配指标;在架构匹配的模型对上,B4 等宽松指标会给出几乎相同的分数,但实际工具调用行为完全相反。本文通过逐字复现检查与首 token 概率探针,以分钟级 CPU 成本区分了真实能力与表面巧合,为小模型工具使用声明提供了廉价且严格的诊断阶梯。
- 机制诊断可以指导修复:1B 模型缺失 <|tool_call|> 先验概率,被 web-heavy 训练阶段擦除;通过定向 SFT 用比失败阶段少三个数量级的 token 恢复,且嵌入表几乎不变,表明修复发生在路由/周围网络而非表示层。这提示针对首 token 先验的修补比大规模重训更高效,且要检查嵌入漂移确认修改位置。
- 负向抑制是共同短板:两个模型在负例提示上过度触发工具调用;消融显示所有修复配置都能安装正向格式,但多样化语料的抑制效果受随机种子影响。因此工具使用评测应包含负例提示,否则模型只是学会了“总是调用”,而不是按需调用。
方法
方法:四级诊断阶梯与针对性修复
输入为一组共享 tokenizer、解码器与特殊 token 的小型语言模型(如 661.6M 与 1,109M 参数),评估其对工具调用的真实掌握程度。
诊断阶梯(严格度逐级递增)
Level 1:宽松基准
沿用 B1–B5 指标(如 BLEU-4),自动评分工具调用生成质量,但仅能反映表面相似度。Level 2:固定提示定性评估
人工审阅模型输出,区分“流畅但无指令跟随”与真实工具调用格式。Level 3:逐字复现与泛化变体
抽取训练样本,要求模型复现完整工具调用;再替换实体(新实体、新语域)检验泛化。成功标准为发出合法调用且参数可泛化。Level 4:机制探针(无生成)
- 首 token 概率:测量模型在提示后预测
<|tool_call|>的概率,定位先验缺失。 - 嵌入漂移检查:对比修复前后 trigger token 的嵌入表位级变化,判断修改发生在路由网络而非表示层。
- 首 token 概率:测量模型在提示后预测
修复方法
针对诊断出的先验缺失,采用针对性 SFT:使用多样化语料、5 倍学习率、仅 2,202 步(约 3.3 GPU 小时),以比失败阶段少三个数量级的 token 数量恢复工具调用能力。修复后逐字复现通过率从 0.100 升至 0.959。
与同类方法的差异点:不同于仅依赖宽松自动指标的常见做法,该阶梯以逐字复现与首 token 探针提供廉价、可证伪的诊断,能够区分“误报的工具使用能力”与真实泛化,且无需昂贵人工标注或大模型裁判。
实验
实验设计
训练两个匹配架构的 Spanish security LM: 600M 与 1,109M。600M 预训练混合约 65% 代码/技术文本;1B 采用 web-heavy 多阶段课程,含 6B token 工具 SFT。评估分四级:lenient B1–B5 harness、定性 battery、逐字复现与泛化 battery、机制探针(首 token 概率、embedding drift)。修复阶段用 2,202 步 SFT,约 3.3 GPU-hours,5x 学习率与多样化语料。
关键发现
宽泛指标 B4 上两者接近(0.660 vs 0.650),但逐字复现完全分离: 600M 在 6/6 训练样本上生成合法 tool call,1B 为 0/6。首 token 探针显示 1B 对 <|tool_call|> 的先验概率仅 10^-4–10^-5,web-heavy 阶段擦除了先验。修复后 1B 在 269 语料行上有效发射率从 0.100 升至 0.959(600M:0.926);238 未见过 prompt 通过率 0.536 vs 600M 的 0.428(p=0.004)。embedding drift 显示 trigger token 的 embedding 97.7% bit-identical,变化在周边网络。
基线对比
与 600M 相比,1B 原始模型在严格诊断下几乎不具备 tool use,尽管 B4 分数几乎相同,证明 keyword harness 会假阳性。修复后 1B 在未见 prompt 上显著超越 600M (p=0.004),但过触发率更高(0.17 vs 0.09),说明抑制能力仍弱。600M 泛化参数能力较好,但二者都过触发,揭示小型模型共同弱点。
行业影响
落地场景
- 小型语言模型 (SLM) 在边缘设备、IoT、移动端做 工具调用 的应用(如语音助手、设备控制)。
- 模型上线前的 能力验证:利用廉价诊断阶梯区分“真正会调用工具”和“只会复述关键词”的模型。
- 具体用例:电商客服助手需调用订单查询/退换货 API;企业服务中智能工单系统需调用 CRM 接口。若模型仅通过关键词匹配基准但不会生成合法工具调用,将导致业务失败。用逐字复现测试和首 token 概率探针可快速筛出此类伪能力。
商业价值
- 降低评估成本:诊断仅需 CPU 分钟级,无需大规模 GPU 推理,可在选型阶段排除不合格模型,避免上线后返工。
- 提升可靠性:修复方法(定向 SFT,~3.3 GPU 小时)能显著提高工具调用生成率(0.10→0.96),改善用户体验,减少人工兜底。
- 供应链/风控收益:避免因工具调用失败造成的订单流失或服务中断。
与现有工作流接口
- 可将诊断阶梯封装为 Hugging Face Evaluate 自定义指标或 pytest 插件,嵌入 CI/CD 流水线,作为模型发布的 质量门禁。
- 与 MLflow 或 W&B 集成,记录诊断指标曲线,追踪训练过程中工具调用能力的出现与遗忘。
- 修复配方可作为 LoRA/QLoRA 微调模板,直接应用到现有小模型训练栈。
核心启示:不要信任宽松的关键词匹配基准,必须用严格、便宜的诊断验证工具调用真实性。
局限
- **抑制能力弱且修复不稳定**:原文明确承认两个模型都会过度触发——600M 在负提示上仍有 0.09 的工具调用率,修复后 1B 上升到 0.17,说明现有 SFT 配方只植入格式、未学会何时不调用。此外 6.9 节 factorial 的种子重复表明 diverse corpus 对 suppression 的增益仅在一个种子中显著,作者将‘diverse corpus 的抑制优势’降级为假设,结论受 seed sensitivity 限制,需要更多重复或更大规模消融。
- **适用范围窄**:研究仅基于西班牙语安全领域的两个模型,共享 decoder/tokenizer/special tokens,且工具调用格式固定为 `<|tool_call|>` 首 token。这种匹配架构虽利于对照,但也将结论锚定在特定语言、垂直领域、模型尺寸(0.6B/1.1B)和 tokenizer 设计上。更大参数规模、不同预训练语料或非拉丁语系中,keyword harness 是否同样 fail open、diagnostic ladder 是否同样有效,尚未验证。
- **诊断阶梯只覆盖触发先验,未评估生成质量**:第一 token probe 能定位缺失先验,但不能反映完整调用参数是否正确、是否幻觉;embedding-drift 检查 97.7% embedding 表 bit-identical,但网络其余部分的变化未被逐层分解。因此修复后的 1B 在 238 个未见 prompt 上 pass@1 仅 0.536,仍落后于实用要求,且 over-trigger 与 under-specificity 等后期失败模式未被阶梯捕获。