Argo-Bench: 在企业级工作流上评估数据智能体
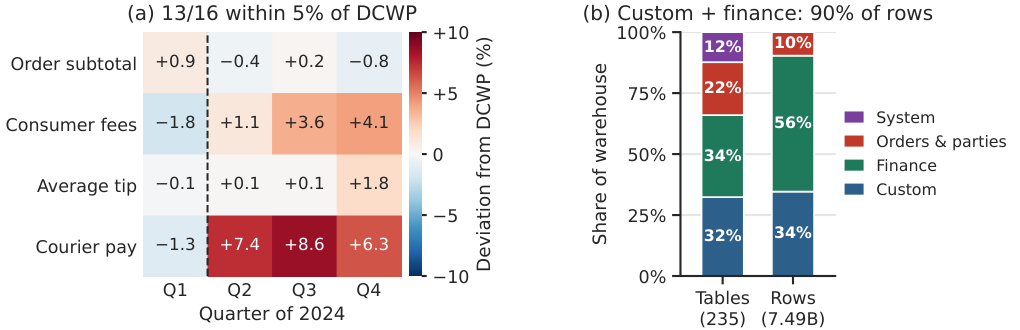
真实企业的数据科学与分析工作流,需要在数十张表之间推理、执行统计分析,并依据结果采取行动。现有 text-to-SQL 基准只评测查询生成,且有审计发现其答案键经常出错。由于真实企业数仓过于敏感、无法公开,这些基准大多建立在公共数据集上,一个业务事件往往只装在一张表里。 为此,我们提出 Argo-Bench,一个包含 210 个数据科学与分析任务的评测框架。它结合公开数据、同行评审的行业文献与监管文件,以真实规模模拟了一家位于纽约市的外卖平台:2024 年 8100 万 笔订单,并配有扎实的经济学设定、欺诈模式与市场激励机制。我们将这一世界导出为 235 张表、75 亿 行的 ERP 数仓,其建模参照 Oracle E-Business Suite schema。模拟器的真值状态对智能体可见的数仓隐藏,因此任务要求先导航数仓重建事实,再据此行动。 Argo-Bench 不止于 text-to-SQL:智能体需提交封禁欺诈账户、分配骑手激励预算、发放补发工资等动作,评分器按这些动作在模拟器中产生的后果打分。每个任务都配有可执行参考解,证明仅凭该数仓即可求解。 在 14 个前沿与开放权重模型中,最强模型也仅在 34.8% 的任务上达到 95 分及以上,平均仅 59.5 分。我们希望 Argo-Bench 能推动智能体走向真正理解、导航并作用于真实数据环境。
论文精读
TL;DR Argo-Bench 构建纽约外卖平台仿真仓库(235 表 75 亿行),评估数据智能体在真实企业流程中的查询、推理与决策执行,而非仅 text-to-SQL,前沿模型平均仅 59.5 分。
问题
问题背景
当前数据智能领域正从 text-to-SQL 走向 端到端数据 agent,期望模型能自主完成查询、分析、决策到执行的全流程企业任务。
现有方法局限
- 基准类型单一:主流基准(如 Spider、BIRD)仅评估 SQL 生成,忽略 agent 的后续行动及后果。
- 答案质量存疑:多项审计发现这些基准的答案键存在大量错误,影响评估可信度。
- 环境规模失真:受限于数据敏感性,现有基准多基于公共数据集,单个业务事件通常存储于单表,无法覆盖真实企业仓库中数十表关联、亿级行数据和隐藏真实状态的场景。
为什么难/重要
企业数据环境具有 schema 复杂度高、数据量巨大 和 行动结果需通过环境反馈 的特点,构建可重复、真实感强的评估环境涉及 世界模拟、仓库设计与验证、任务自动评分 等多重挑战。缺乏此类基准,模型在真实企业工作流中的性能无法被可靠度量,阻碍了数据 agent 的落地。
行业类比
类似自动驾驶中采用 高保真仿真 评估车辆决策,数据 agent 需要在模拟企业环境中评估多步决策和行动后果,以减少真实业务试错成本。
核心洞察
- Argo-Bench 将数据代理评估从静态 SQL 生成推进到闭环行动后果评分。它让代理在模拟世界中采取行动(封禁、预算分配、补发工资),并通过模拟器状态变化打分,而不是仅比对答案字符串。这种机制直接惩罚“看起来正确但实际错误”的推理,与 Spider、BIRD 等只验证查询结果的文本到 SQL 基准形成鲜明对比,更能反映真实企业决策风险。
- 通过模拟器生成具有真实经济和欺诈模式的大规模企业数据,同时隐藏 ground truth,迫使代理从仓库数据重建事实后再行动。与使用公开单表数据集或直接暴露标签的基准不同,Argo-Bench 复现了 ERP 仓库的数百表规模(235 张表、75 亿行),要求代理处理模式复杂性、跨表导航和隐私限制,同时保证了可复现性和答案可验证性。
- 实验结果显示最强模型仅在 34.8% 任务上获得 95 分以上,平均 59.5 分,揭示当前前沿模型在复杂企业分析中的系统性短板。模型常犯“查错记录、目标错误、数量错误、过度自信预测”等错误,表明现有文本到 SQL 或通用推理基准高估了真实企业场景能力。这个基准提供了一个更严格、更贴近生产的工作流压力测试,为模型迭代提供了具体失败模式。
方法
输入:任务定义与受限环境
agent 接收自然语言任务描述(如“识别并封禁 2024 年欺诈账户”),仅可访问一个 Oracle E-Business Suite 风格的数据仓库(235 张表、75 亿行),其中不包含模拟器的 ground-truth 状态。任务要求 agent 自行导航仓库、执行 SQL 查询、完成统计分析与多表推理,并最终提交具体动作(例如封禁账户、分配预算、补发工资)。
关键模块:世界模拟与仓库导出
- 世界模拟器:基于纽约市食品配送平台,生成 8100 万订单的真实规模数据,集成经济学规律、欺诈模式和市场激励(数据来自公共数据集、行业文献与监管文件)。
- 仓库设计:参考 Oracle E-Business Suite 的表结构,将模拟世界导出为 ERP 风格数据仓库,但刻意隐藏关键状态(如账户是否欺诈),迫使 agent 通过查询重建事实。
- 任务与评分:210 个任务均配有可执行参考解决方案,证明仅凭仓库数据可解。agent 的动作被送入模拟器,由 grader 根据动作在模拟器中产生的后续后果打分,而非比对静态答案。
输出:后果驱动的评分
评分反映动作的实际影响(例如封禁错误账户的代价),而非 SQL 生成正确率。
与同类方法的差异:Argo-Bench 超越了 text-to-SQL 或静态问答基准,评估 agent 在隐藏真值、企业级规模下的端到端工作流,并以模拟器后果作为客观评分依据,避免人工标注错误。
实验
实验设计
Argo-Bench 构建了一个模拟的 NYC 食品配送平台,包含 81M 订单、235 张表、7.5B 行数据,基于 Oracle E-Business Suite schema。任务要求 agent 查询仓库重建事实并执行动作(如封禁欺诈账户、分配激励预算等),评分基于模拟器后果。共 210 个任务,每个任务有可执行参考解决方案。评估了 14 个前沿和开放权重模型。
关键发现
企业级数据智能体 任务仍有很大挑战:最强模型在 95 分以上任务仅占 34.8%,平均分 59.5。论文发现模型常犯错误包括检索错记录、目标理解错误、数量错误、过度自信预测等。
与基线对比
与 text-to-SQL 基准(如 Spider)相比,Argo-Bench 更注重端到端数据科学工作流而非仅 SQL 生成,且隐藏 ground truth,评分基于动作后果,更贴近真实企业环境。传统基准常存在答案键错误,而 Argo-Bench 每个任务有可执行参考解,确保可解性。
行业影响
落地场景
Argo-Bench 将数据代理评估从文本到 SQL 的单一查询生成,推至包含统计推理与业务动作的闭环任务,直接映射企业数据科学自动化场景。典型用例包括:
- 电商风控代理:跨订单、支付、用户表识别欺诈团伙,自动执行账户冻结或退款复核。
- 物流调度代理:分析配送时效、运力与激励数据,动态分配 courier 激励预算。
- 企业服务分析代理:在 ERP 系统中自动生成合规报告、补发工资或调整财务科目。
商业价值
核心价值在于 减少人工介入,缩短从数据洞察到业务决策的路径。基准显示当前最强模型平均仅 59.5 分,说明依然存在显著自动化红利。若代理能在少量高价值任务(如欺诈处置、预算分配)达到 95+ 分,企业可降低数据科学团队的人力成本,同时避免人工操作延迟带来的损失。对于模型供应商,Argo-Bench 成为区分“能查数”与“能办事”的硬性指标,驱动产品溢价。
跟现有产品/工作流的接口
Argo-Bench 可作为企业内部的评估与选型基准,直接嵌入现有 Agent 开发流程:
- 对接 Snowflake、Databricks、Oracle EBS 等数据仓库,通过工具调用执行 SQL 查询与写回动作。
- 使用其可执行参考解决方案生成训练数据或回归测试用例,用于微调开源模型。
- 在 LangChain 等编排框架中,将 Argo-Bench 任务作为验收关卡,衡量代理在真实 ERP 复杂度下的可靠性。
具体落地 use case:金融行业反洗钱调查代理,汇总多表交易记录后自动提交可疑活动报告;零售企业供应链代理,分析库存与销售数据后生成补货订单并触发采购流程。
局限
- **模拟环境与真实企业数据存在偏差**:Argo-Bench 的合成数据虽规模庞大,但欺诈模式、经济激励等由设计者注入,可能无法覆盖真实企业环境中非结构化、长尾的异常情况。代理在合成仓库上的表现未必能直接迁移到实际生产环境,外部有效性有限。此外,仓库模式固定为 Oracle E-Business Suite,对其他 ERP 系统(如 SAP、Microsoft Dynamics)的兼容性未经验证,可能高估或低估代理在异构数据栈中的能力。
- **任务多样性与覆盖面受限**:210 个任务全部围绕纽约市食品配送平台,领域单一,且仓库表结构和关系预先定义。现实企业分析需求涉及更多行业(如金融、医疗、制造)和多源数据融合,本基准无法充分评估代理的跨领域泛化能力。同时,任务数量相对有限,难以对模型进行细粒度的能力区分(如不同推理深度或工具使用方式),也可能导致过拟合风险。
- **评分机制可能引入偏差与高执行成本**:参考解决方案和模拟器评分虽能评估动作后果,但预测类任务(如预测需求)的评分依赖参考预测值,若参考本身存在偏差则会传导至分数;奖励函数设计(如对误封禁的惩罚权重)亦反映特定业务假设,未必普适。此外,运行模拟仓库和执行代理需要大量计算资源,可能限制小团队或学术机构的复现与迭代,减弱基准的社区采用度。