VTR-Bench: 面向视频生成中视觉文本渲染评估的系统性基准
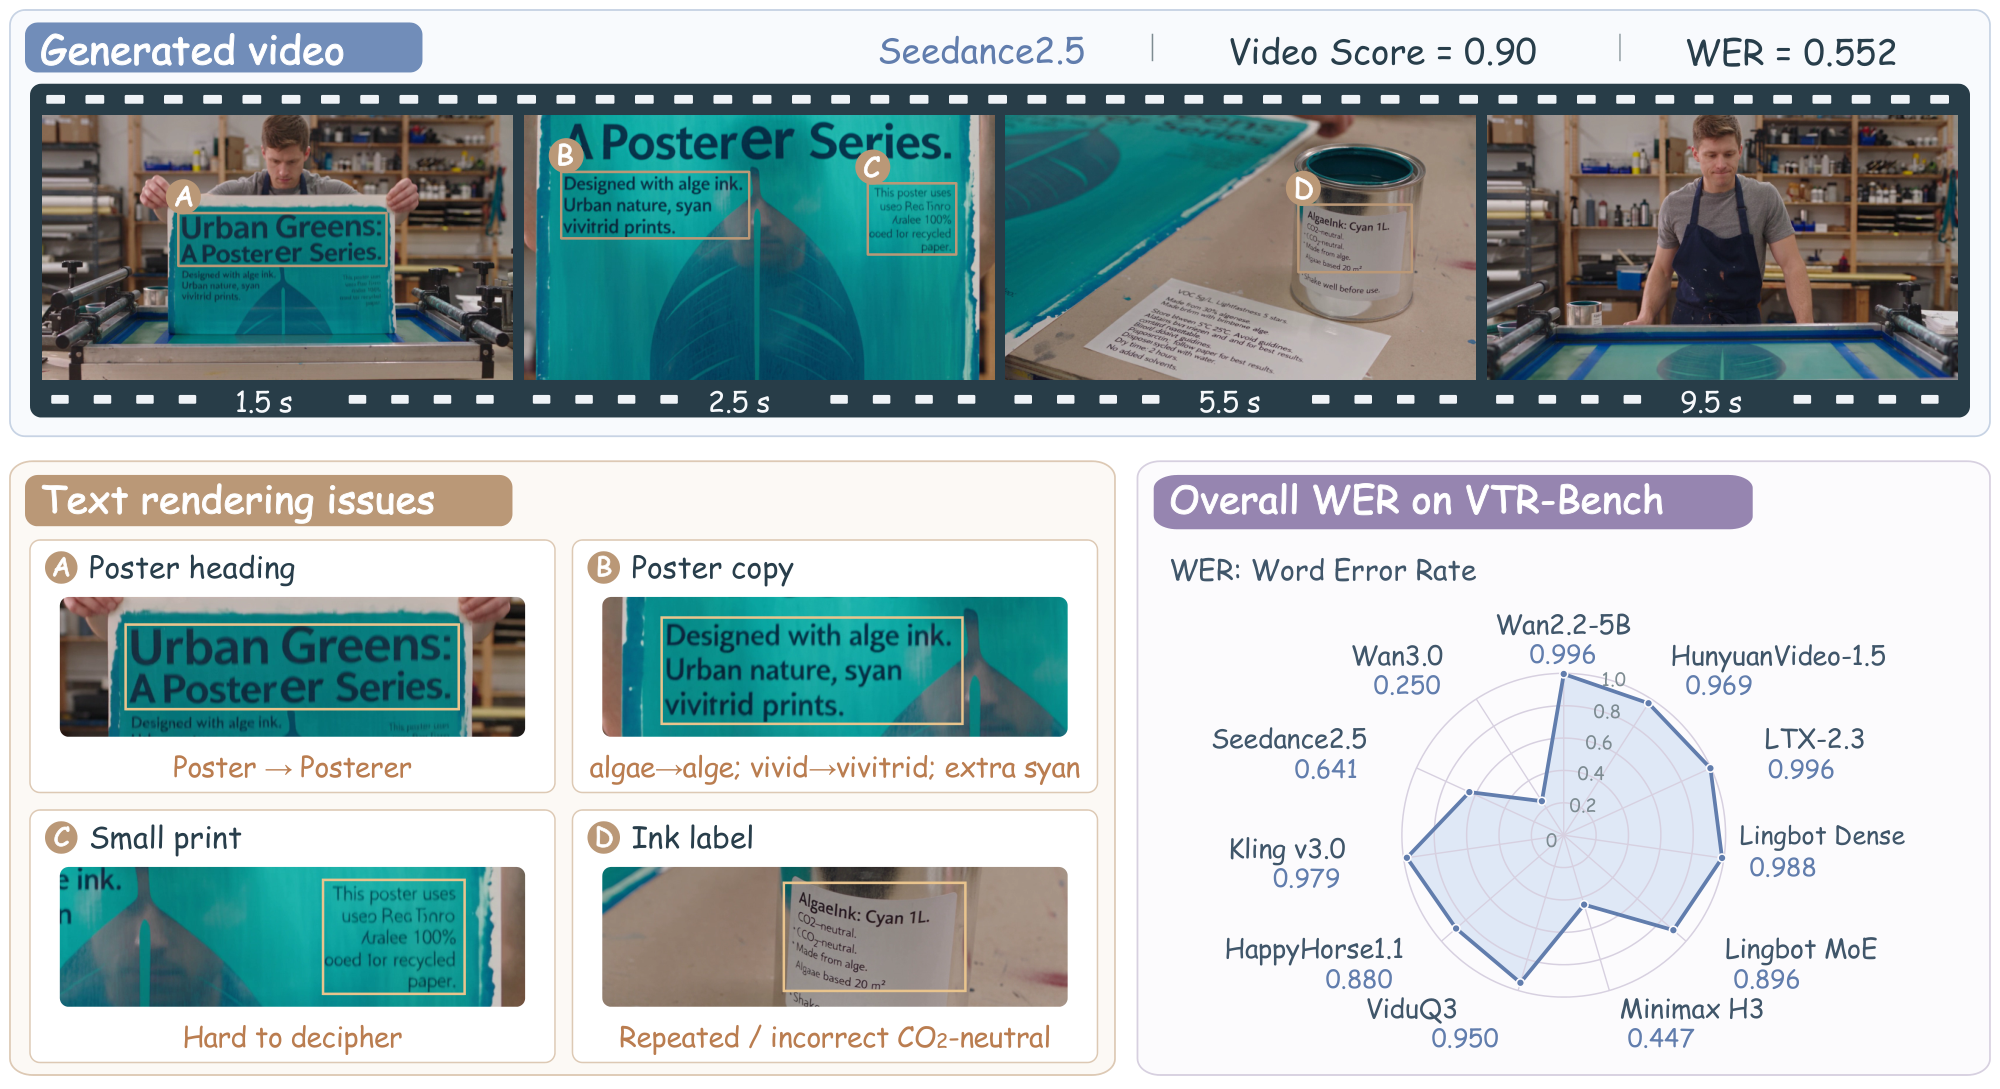
近期视频生成模型已能根据自然语言指令生成高度逼真的视频,视觉质量接近电影级水准。但现有评测基准主要关注视觉质量、美学吸引力与物理合理性,对文本这一日常场景中承载信息的关键媒介关注不足:一段生成视频可能画面吸引人、主体栩栩如生,场景中的文字却渲染错误。 为弥补这一被忽视的维度,我们提出 VTR-Bench 基准,系统评测视频生成模型的视觉文本渲染 能力。该基准把文本放入广告、科学视频等具体应用场景,包含覆盖 5 个场景类别的 300 条精心构建的提示词;并设计了与人工判断对齐的自动化评测流水线,分别通过载体特定的转写评估文本保真度,通过提示词特定的查询链评估场景与运动要求。 除评测外,我们提出 Keyframe-Guided Agentic Framework 框架:由 Director agent 协调图像生成、视频生成与视觉评估,借助视觉反馈引导迭代优化与候选选择。 在 11 个 SOTA 模型上的实验显示,准确渲染场景文本普遍困难,表现最好的模型整体词错误率(WER) 为 0.250。我们进一步分析文本渲染失败案例,刻画当前视频生成模型面临的挑战,表明视觉文本渲染是视频生成的关键难题,并给出了可行的改进路径。代码见 https://github.com/hardenyu21/VTR-Bench 。
论文精读
TL;DR VTR-Bench 推出首个系统评估视频生成中视觉文本渲染的基准,用 300 个场景化 prompt 发现当前最优模型词错率仍达 0.250,并提出关键帧引导的 agentic 框架改进渲染。
问题
视频生成质量提升后的新瓶颈
当前视频生成模型在视觉真实性、运动平滑度上已接近电影级,但场景中的文本(如广告牌、产品标签、字幕)常出现拼写错误、字符错位、字体违和,成为影响实用性的突出短板。
现有基准的局限
主流视频生成基准(如 VBench、EvalCrafter)主要评估视觉质量、时序一致性和物理合理性,对文本渲染的评估仅停留在粗略的 OCR 检测或完全缺失。它们没有区分文本载体(纸张、屏幕、标志牌)的特定渲染要求,也没有提供与人类判断对齐的自动化指标,导致模型可能在视觉上“以假乱真”但文本完全错误,却无法被现有评测发现。
技术挑战与业界关注
视觉文本渲染要求模型在生成过程中同时约束字符级语义、字体样式、透视几何、运动模糊和光照反射,并在视频帧间保持稳定,任何一处失误都会导致文本不可读。这比静态图像文本生成更困难,因为文本需要随相机运动、物体移动而精确变形。对于广告、教育、新闻等依赖文本信息传递的视频生成任务,文本错误会直接损害内容可信度。
行业类比
类似于 OCR 系统需在复杂场景中可靠识别路牌,视频生成模型需要可靠地“写入”文本,二者构成感知与生成的双向挑战。
核心洞察
- - **VTR-Bench** 将视觉文本渲染从静态图像扩展到动态视频,并以场景化方式构建评估。与现有视频生成基准(如 VBench、EvalCrafter)侧重视觉质量、物理合理性不同,VTR-Bench 聚焦于文本正确性这一被忽视维度,且通过 carrier-specific transcription 与 prompt-specific chain of query 分别评估文本保真度和场景/运动要求,填补了系统性评估空白。
- - 自动化评估管线通过 carrier-specific transcription 和 prompt-specific chain of query 实现与人类判断高度一致。不同于直接使用通用视觉语言模型打分,该管线针对文本载体(如招牌、字幕)设计转录方法,有效应对动态视频中 OCR 的局限性;同时 chain of query 确保对提示中场景与运动要求的细粒度核验,为大规模可靠评估提供了工程上可复用的方案。
- - **Keyframe-Guided Agentic Framework** 展示了利用多模态 agent 迭代改进文本渲染的可行路径。该框架由 Director agent 协调图像生成、视频生成与视觉评估,通过关键帧引导和视觉反馈进行候选筛选与优化,证明在不重新训练模型的前提下,可通过测试时 refinement 显著降低文本渲染错误率,为视频生成模型在广告、教育等实际场景的落地提供了直接可借鉴的工程范式。
方法
方法概述
VTR-Bench 围绕视觉文本渲染问题,构建了场景化评估与迭代生成闭环。
输入:五个场景类别(广告、科学视频 等)的 300 个场景化 prompt,每个 prompt 指定了需要渲染的文本内容及其载体(如标牌、字幕、纸张等),并包含场景与运动要求。
关键模块:
自动化评估管线
- 文本保真度评估:采用
carrier-specific transcription,先检测视频中文本出现的载体区域,再对每个载体进行 OCR 转录,与 ground-truth 文本比对,计算 词错误率 (WER) 等指标。 - 场景与运动评估:通过
prompt-specific chain of query,将 prompt 拆解为一系列针对场景、物体、动作的查询链,由视觉-语言模型逐项判断生成视频是否满足要求。
- 文本保真度评估:采用
Keyframe-Guided Agentic Framework
- 引入 Director agent 协调图像生成与视频生成。Director 先生成关键帧(图像),再以关键帧为条件生成视频;随后调用视觉评估模块获得反馈,指导关键帧和视频的迭代细化与候选选择,直至输出满足要求的视频。
输出:对 11 个 SOTA 视频生成模型在 VTR-Bench 上的量化得分(如总体 WER),以及针对文本渲染失败模式的分类分析。同时,该框架本身也作为一种测试时优化方法,可提升生成视频的文本渲染质量。
与同类方法差异点:现有视频生成基准侧重于视觉质量、美学或物理合理性,VTR-Bench 首次将视觉文本渲染作为独立维度,并通过关键帧引导的 agentic 流程将评估反馈用于主动改进生成结果。
实验
实验设计
- VTR-Bench 包含 300 条精心构建的提示,覆盖 5 个场景类别(如广告、科学视频),每条提示均经过视觉可行性验证。
- 评估流程自动化且与人类对齐:文本保真度通过 carrier-specific transcription 评估,场景与运动需求通过 prompt-specific chain of query 评估。
- 共评估 11 个 SOTA 视频生成模型,覆盖闭源 API 与开源配置;同时测试了提出的 Keyframe-Guided Agentic Framework(Director agent 协调图像/视频生成与视觉评估,迭代精化)。
关键发现
- 所有模型在场景文本渲染上均存在广泛困难:最佳模型的整体 WER = 0.250,意味着约四分之一的字符被错误转录,场景文字经常出现拼写错误、残缺或与语义不符。
- 失败分析表明分辨率与时长对文本渲染有显著影响,transcription outcomes 的分布揭示了特定错误模式(如字符漏失、字体漂移)。
- 测试时精化(test-time refinement)在部分模型上显示出改善文本渲染的潜力,但提升有限,说明该问题不能仅靠后处理解决。
与基线对比解读
现有基准主要评估视觉质量、美学与物理合理性,完全忽略了场景文字这一信息载体。VTR-Bench 首次系统地将视觉文本渲染作为视频生成的独立维度进行评测,填补了空白。11 个 SOTA 模型的最佳 WER 仍高达 0.250,表明当前模型在生成可读、语义正确的场景文字上远未达到实用水平,这对广告、教育视频等以文字为核心的应用构成显著障碍。提出的 Keyframe-Guided Agentic Framework 通过视觉反馈迭代精化,为未来改进提供了可行路径,但对比无精化的基线,其绝对提升幅度尚未达到可忽略 WER 的数量级,说明需要从模型架构或训练数据层面根本性强化文字渲染能力。
行业影响
落地场景
VTR-Bench 直接适用于所有需要 视频生成模型 输出包含文字的场景:广告创意自动生成(品牌标语 / 促销信息)、教学内容短视频(公式 / 图表标注)、社交媒体内容(字幕 / 贴纸)、电商产品展示视频(规格参数)、企业宣传片等。当前视频模型常出现文字错乱(如单词缺字母、logo 变形),导致内容不可用。该 benchmark 按 五个场景类别 构建 300 条 prompt,可作为产品上线前的质检标准。
商业价值
核心价值在 降低人工校验成本 与 避免品牌风险。通过自动化评估(基于 WER 的文本保真度 + 场景/运动约束审查),团队可在生成后毫秒级识别文本渲染失败,无需逐帧人工审核。对内容平台,能大幅提升 AI 生成视频的可用率,减少返工;对行业客户,可保证品牌文字准确呈现,避免因错误文字引发的法律 / 声誉问题。同时,论文提出的 Keyframe-Guided Agentic Framework 提供迭代修复路径,进一步压缩生成成本。
与现有产品 / 工作流的集成
- 作为 评估层 嵌入视频生成 API 或内部 pipeline:在模型输出后自动运行
VTR-Bench评分,低于阈值则触发重试或切换模型。 - 用于 模型选型 / 版本回归:在 benchmark 上比较不同模型(文中 11 个 SOTA 模型,最佳 WER 仍为 0.250),指导技术选型。
- 与 agentic 生成框架 结合:将 Director agent 的反馈回路接入现有 ComfyUI / diffusers 等工作流,实现 “生成 → 评估 → 细化” 闭环。
- 开源代码(GitHub)可直接作为
pytest风格测试套件引入 MLOps 流程。
局限
- **数据集规模与多样性有限**:VTR-Bench 仅包含 300 个提示,覆盖五个场景类别,虽然主题设计有针对性,但相较于真实世界的文本应用场景(如多语言标识、手写体、复杂排版)仍显不足。提示多基于英文文本,未系统评估中文、阿拉伯文等不同书写系统或特殊字体,这限制了基准的泛化能力。对于希望评估模型在多语言环境下文本渲染鲁棒性的研究者,需要额外扩展数据集。
- **评估指标可能存在偏差**:自动化评估依赖 OCR 转录和 VLM 判断,虽然作者进行了人类对齐验证,但转录环节的误差会直接传导到 WER 指标,且 WER 偏重字符级正确性,无法捕捉语义保持、排版美观或字体一致性等更细粒度的视觉质量。此外,VLM 对场景和运动要求的判断受限于其自身的理解能力,可能引入系统性偏差,而人类对齐实验只覆盖了部分样本,不足以证明全量评估的可靠性。
- **Agentic 框架缺乏充分消融与成本分析**:提出的 Keyframe-Guided Agentic Framework 依赖 Director agent 协调图像生成、视频生成和视觉评估,这引入了额外的推理成本与复杂度。论文未对框架中各组件(如迭代次数、评估器选择、关键帧策略)进行系统性消融实验,难以判断性能提升的主要来源,也不清楚框架在计算资源受限环境下的实用性。与单纯使用更强的基座模型相比,该框架的边际收益需要更清晰的对比论证。